
ADG:智能体依赖图谱,看清 Agent 能力边界
Agent 的风险,很多时候不是来自某一个工具本身。
Agent 的风险,很多时候不是来自某一个工具本身。
一个网页搜索工具,单独看没有问题;一个邮件发送工具,单独看也可以通过审批策略保护;一个共享会话记忆,看起来只是为了提升多轮任务体验。
但如果这些组件被连在一起:用户输入先进入 Research Agent,Research Agent 可以调用搜索工具,又可以 handoff 给 Ops Agent,Ops Agent 能调用 SendEmail,两个 Agent 还共享同一个 session,那么问题就变了。
风险不再是“有没有危险工具”,而是:
Prompt 能不能影响高权限工具调用? 一个 Agent 的上下文能不能流向另一个 Agent? 共享 memory 会不会变成跨 Agent 的隐性通道? 审批策略到底保护了哪个工具、哪条调用路径?
这正是 ADG,也就是 Agent Dependency Graph,智能体依赖图谱 想解决的问题。
7 月 2 日,华中科技大学联合 Macquarie University 提交论文《AgentFlow: Building Agent Dependency Graphs for Static Analysis of Agent Programs》。
论文提出 AgentFlow,用静态分析方式从 Agent 程序源码中恢复 Agent、Prompt、模型、工具、记忆状态和控制策略之间的依赖关系,并在 5399 个真实 Agent 项目中发现了 238 个 Prompt-to-Tool 风险项目。
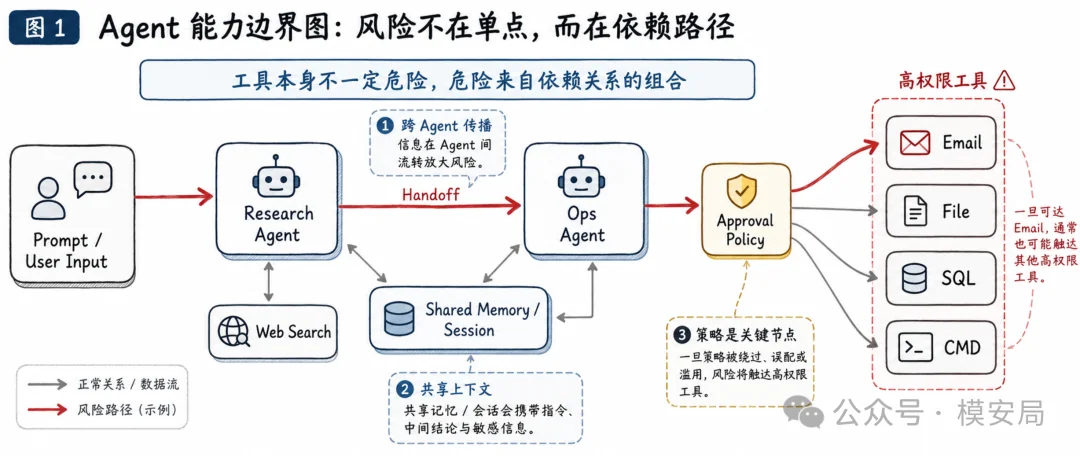
工具清单不等于能力边界
企业做 Agent 安全治理时,第一反应通常是列清单。
这个 Agent 用了什么模型? 挂了哪些工具? 接了哪些 MCP Server? 有没有外部 API? 有没有文件、数据库、邮件、代码执行权限?
这些问题当然重要,但它们只能回答“系统里有什么”,不能回答“这些东西如何相互影响”。
论文把这个问题说得很直接:Agent 程序不是普通应用程序。它既包含常规代码逻辑,也包含框架定义出来的 Agent 语义,比如 Agent 构造器、工具装饰器、handoff 声明、session、memory、guardrail、审批策略等。传统静态分析擅长看函数调用、变量传播、控制流和数据流,但这些 Agent 框架语义往往不是普通函数调用能直接表达的。
例如,在 OpenAI Agents SDK 风格的程序里,tools=[…] 表示 Agent 可以调用某个工具,handoffs=[…] 表示一个 Agent 可以把任务转交给另一个 Agent,session=session 表示多个 Agent 可以共享状态,require_approval=“always” 表示某个工具调用前需要审批。
这些都不是简单的业务代码,它们定义了 Agent 的真实能力边界。
所以,一个 Agent 的安全审计不能只问:
它有没有 send_email 工具?
更应该问:
谁能触达 send_email? Prompt 有没有路径影响 send_email 的参数? 是否可以通过 handoff 间接触达? 共享 memory 是否让原本隔离的 Agent 发生了数据流连接? 审批策略是在工具前,还是只存在于配置里但没有覆盖完整路径?
这就是 ADG 要补上的视角。
ADG 的三张图
ADG 的全称是 Agent Dependency Graph,可以翻译为智能体依赖图谱。
它不是简单画几个 Agent 和工具之间的连线,而是把 Agent 程序中的核心实体抽象成节点,再把它们之间的依赖关系抽象成边。
论文中的 ADG 主要包含六类节点:
- Agent:具体的智能体执行单元
- Prompt:角色设定、任务说明、系统指令、上下文模板
- Model:Agent 绑定的模型
- Capability:工具、MCP 能力、Skill、外部 API
- Memory State:session、memory、状态对象、长期记忆
- Control Policy:人工审批、guardrail、权限检查、校验策略
这六类节点覆盖了 Agent 程序中最关键的能力构成。论文明确将 Agent、Prompt、Model、Capability、Memory State、Control Policy 建模为 ADG 的 typed nodes,并通过 typed edges 表示组件依赖、控制流依赖和数据流依赖。
更重要的是,ADG 不是单一视角,而是由三类子图组成。
第一类是 ACDG:Agent Component Dependency Graph,也就是组件依赖图。它回答“一个 Agent 静态绑定了哪些组件”。例如某个 Agent 绑定了哪个 Prompt、哪个模型、哪些工具、哪个 memory、哪个控制策略。
第二类是 ACFG:Agent Control Flow Graph,也就是 Agent 控制流图。它回答“控制权可能从哪里转到哪里”。例如 Agent 可以调用某个工具,也可以 handoff 给另一个 Agent;如果中间有审批策略,那么控制流会经过 policy 节点。
第三类是 ADFG:Agent Data Flow Graph,也就是 Agent 数据流图。它回答“信息可能如何传播”。例如 Prompt 会影响 Agent,Agent 会把参数传给工具,工具返回结果会影响 Agent,一个 Agent 的输出可能通过 message 或 handoff payload 影响另一个 Agent,memory 的写入和读取也会形成跨 Agent 数据流。
论文将 ADG 表示为 ACDG、ACFG、ADFG 三部分,分别捕获组件绑定、控制流转移和数据传播。
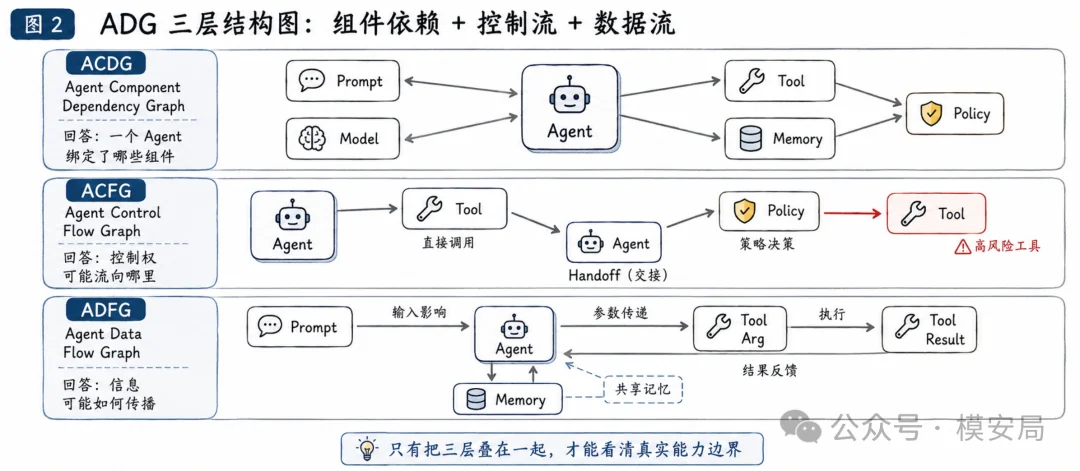
这三个视角叠在一起,才是完整的 Agent 能力边界。
只看 ACDG,只能知道 Agent 有哪些组件。 只看 ACFG,只能知道 Agent 可能调用谁。 只看 ADFG,只能知道数据可能怎么传播。
但安全风险往往出现在三者交叉处:
- 一个 Prompt 影响了 Agent
- 这个 Agent 有控制流路径到高权限工具
- Agent 上下文又能作为工具参数传入
- 中间没有有效审批或隔离
这才是 Prompt-to-Tool 风险的基本形态。
一个简单例子:检索 Agent 如何间接触达发邮件工具
论文给了一个很典型的例子。
程序里有两个 Agent。
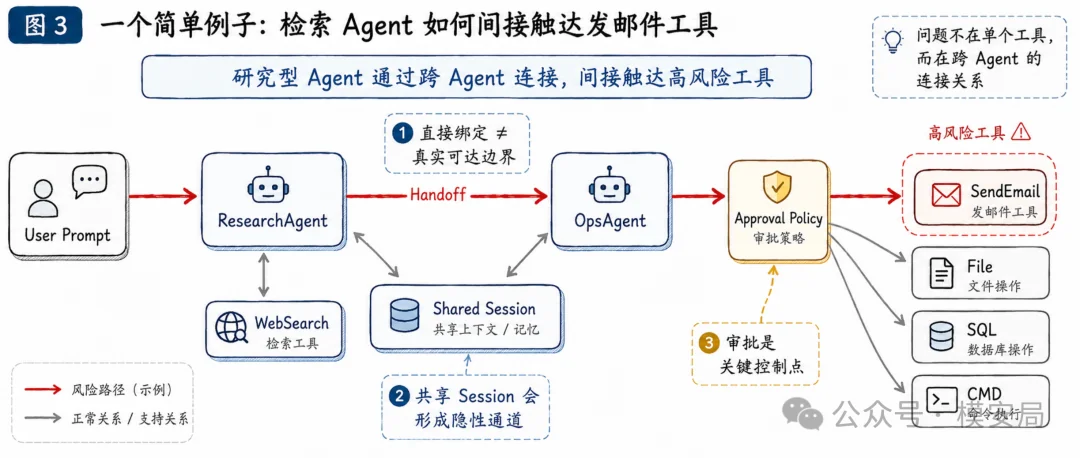
第一个是 ResearchAgent,负责搜索信息,绑定了 WebSearch 工具。 第二个是 OpsAgent,负责执行运营动作,绑定了 SendEmail 工具。
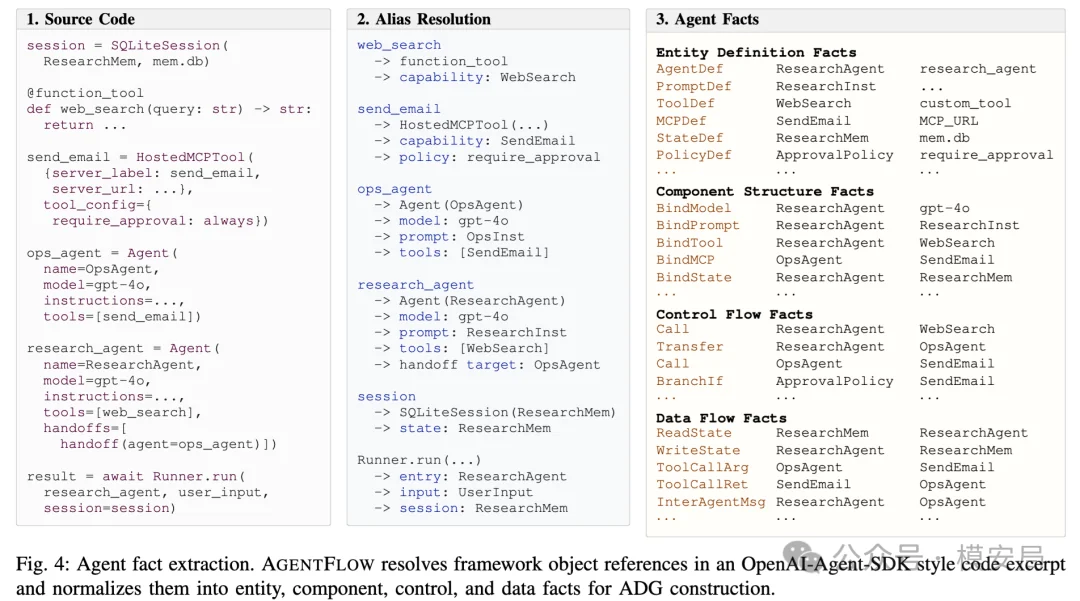
SendEmail 是一个 Hosted MCP Tool,并且配置了 require_approval=“always”。ResearchAgent 可以通过 handoff 把任务交给 OpsAgent。两个 Agent 共享一个 SQLiteSession。
从表面看,ResearchAgent 没有邮件发送能力,它只绑定了搜索工具。SendEmail 也不是裸奔的,它配置了审批策略。
但从 ADG 视角看,会出现一条更完整的路径:
用户输入 / Prompt → ResearchAgent → WebSearch → 共享 session / handoff → OpsAgent → ApprovalPolicy → SendEmail
这条路径说明,ResearchAgent 虽然没有直接绑定 SendEmail,但它可以通过 handoff 影响 OpsAgent;同时,两个 Agent 共享 memory,信息也可能通过 session 在 Agent 之间流动。
这里的安全问题不是“send_email 是否存在”,而是“用户输入是否有路径影响 send_email”。
这类问题在真实 Agent 系统里很常见。企业为了提升任务完成率,会把检索、分析、执行、通知拆成多个 Agent;为了提升体验,会让它们共享上下文;为了复用能力,又会把邮件、工单、数据库、代码执行等工具统一挂到某些执行型 Agent 上。
单看每个组件,都可能是合理设计。连起来之后,才出现能力边界扩大。
AgentFlow 怎么从源码里恢复 ADG
AgentFlow 的目标不是运行 Agent,也不是模拟模型会怎么回答,而是静态分析源码。
它做的事情可以理解成三步。
第一步,提取 Agent Facts。
不同框架有不同写法。OpenAI Agents SDK 有 Agent(…)、@function_tool、HostedMCPTool、handoff;LangGraph 有 graph node、edge、state、Command;CrewAI 有 agent、task、crew、tool、delegation;LlamaIndex 和 Semantic Kernel 也有各自的抽象。
AgentFlow 先识别这些框架 API,再做 alias resolution,把变量引用解析回定义位置。比如 send_email 在工具列表里出现时,系统要知道它其实来自前面的 HostedMCPTool(…) 定义。随后,AgentFlow 把这些信息归一化成四类 facts:实体定义、组件绑定、控制流、数据流。论文图 4 展示了从源码、别名解析到 Agent Facts 的转换过程。
第二步,做单 Agent 内部分析。
如果一个 Agent 绑定了 Prompt、Model、Tool、Memory,就生成组件依赖边。
如果一个 Agent 可以调用某个工具,就生成控制流边。
如果 Agent 的上下文可能作为工具参数传入,就生成数据流边。
如果工具返回结果会进入 Agent 上下文,也生成反向数据流边。
第三步,做跨 Agent 依赖分析。
跨 Agent 传播有两类。
一类是显式传播,比如 message、task output、handoff payload。
另一类是隐式传播,比如共享 memory、共享 state、共享 session。
这一步很关键,因为很多 Agent 风险不是发生在单个 Agent 内部,而是发生在多 Agent 协作边界上。
论文也强调,AgentFlow 采用的是 over-approximate 设计。它不是预测模型运行时一定会走哪条路径,而是判断程序架构允许哪些路径存在。
这点需要特别注意。
静态分析看到的是“可能性”,不是“必然性”。 但对上线前安全审计来说,“可能存在高危路径”本身就有价值。
Agent BOM:清单要升级为依赖关系
AgentFlow 的第一个应用是生成 Agent BOM。
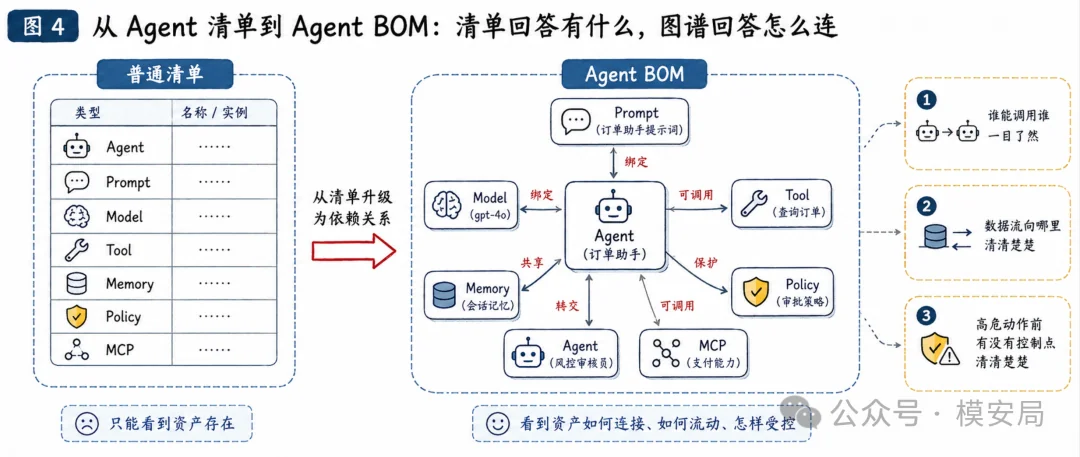
BOM 这个概念在软件供应链里并不新。SBOM 列软件包,AI-BOM 列模型、数据集、环境、元数据、来源信息。Agent 系统的问题在于,只列组件还不够。
一个 Agent 项目里有多少模型、多少工具、多少 MCP Server,只能说明“资产存在”。真正影响安全的是:
哪个 Agent 可以调用哪个工具? 哪个 Prompt 影响哪个 Agent? 哪些 Agent 共享 memory? 哪些工具被 policy 保护? 哪些 Agent 可以通过 handoff 互相触达? 哪些能力来自外部 MCP Server 或 Skill?
论文认为,Agent BOM 不应只记录 agent-specific components,还要记录它们之间的 dependency relations。比如哪个 Agent 可以调用哪些工具,memory 如何传播信息,哪些 guard 保护高影响动作。
这和企业治理高度相关。
很多企业现在做 Agent 备案或上线审查,仍停留在表格层面:应用名称、模型名称、工具名称、负责人、数据范围、权限说明。这种表格可以作为合规材料,但很难支撑技术审计。
因为风险不是写在单个字段里,而是藏在字段之间的连接关系里。
例如,一个工具被标记为“高危”,但如果没有任何 Agent 能触达它,风险就不一定高。反过来,一个 Agent 表面只绑定普通工具,但它可以 handoff 到另一个高权限 Agent,风险就不能按普通 Agent 处理。
Agent BOM 的关键不是“列出来”,而是“连起来”。
Prompt-to-Tool:Agent 安全里最需要被看见的路径
AgentFlow 的第二个应用是 Prompt-to-Tool 风险检测。
这个风险可以简单理解为:
- Prompt 或用户输入影响了 Agent
- Agent 可以触达高权限工具
- 相关上下文可能进入工具参数
- 于是 Prompt 有机会影响真实世界动作
这里的“工具”不只是普通函数。它可以是发邮件、写文件、删文件、执行命令、调用数据库、提交工单、修改配置、请求外部 API,也可以是某个 MCP Server 暴露出来的能力。
这类风险和传统内容安全不同,内容安全关心模型输出了什么,Prompt-to-Tool 关心模型驱动了什么动作。
对企业来说,后者往往更接近真实损失。一次错误的文本输出,可能只是体验问题;一次错误的工具调用,可能带来数据泄漏、误操作、越权访问、业务中断,甚至供应链攻击入口。
AgentFlow 的 P2T 检测本质上是一个图查询问题:
- 从 Prompt 出发,沿着数据流找到被影响的 Agent
- 再沿着控制流判断它能否到达高危 Capability
- 如果 Agent 上下文还能流入 Capability 参数,就报告风险路径
这个思路比“扫描危险关键词”更接近 Agent 安全本质。
因为 Agent 风险不是由某个敏感词触发的,而是由“上下文 + 工具权限 + 控制路径 + 数据流向”共同决定的。
实验结果:5399 个项目里发现 238 个风险项目
论文构建了一个名为 AgentZoo 的真实项目语料库,共包含 5399 个 GitHub Agent 项目,覆盖 LangChain / LangGraph、OpenAI Agents SDK、CrewAI、LlamaIndex、Semantic Kernel 五类框架。AgentFlow 总共建模支持了 143 个框架特定构造,其中 OpenAI Agents SDK 48 个,LangChain / LangGraph 27 个,CrewAI 15 个,LlamaIndex 22 个,Semantic Kernel 31 个。
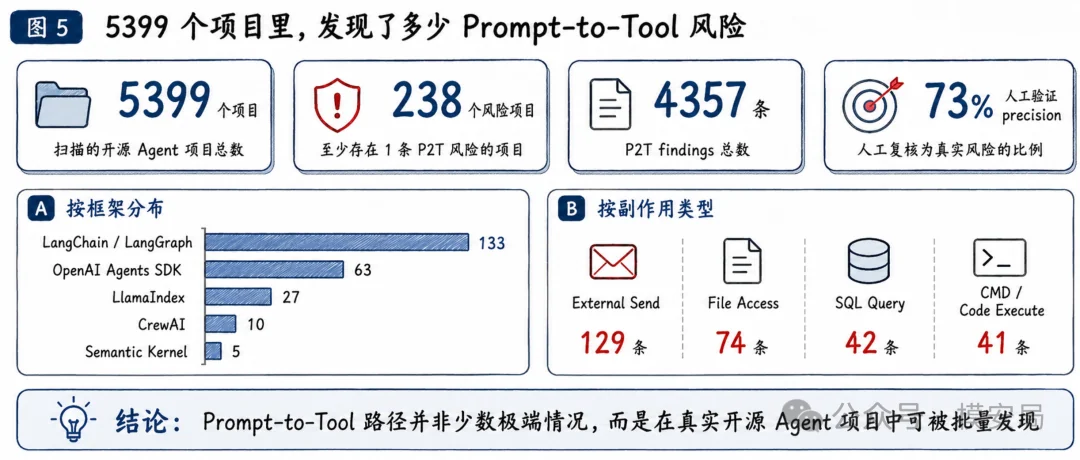
在 Prompt-to-Tool 风险检测中,AgentFlow 在 5399 个项目中识别出 238 个存在 P2T 风险的项目,占比 4.4%,共包含 4357 条 P2T findings。按框架看,LangChain / LangGraph 项目最多,有 133 个;OpenAI Agents SDK 为 63 个;LlamaIndex 为 27 个;CrewAI 为 10 个;Semantic Kernel 为 5 个。按副作用类型看,External Send 有 129 个,File Access 有 74 个,SQL Query 有 42 个,CMD / Code Execute 有 41 个。
人工验证结果也值得看。作者抽样审计了 100 条 AgentFlow 报告,其中 73 条确实存在 Prompt-to-Tool 漏洞,precision 为 73%。剩下 27 个 false positive 中,有 25 个其实仍然存在有效污点传播路径,只是 sink 语义判定不够精细。例如有些是只读文件访问、只读 SQL、受限计算器工具,不应简单等同于文件写入、数据库修改或通用代码执行。
这个结果说明两件事。
第一,真实开源 Agent 项目里,Prompt-to-Tool 路径不是少数极端情况,而是已经能在批量项目中稳定发现。
第二,ADG 适合作为上线前的风险发现机制,但它还不能单独完成最终定级。发现路径之后,还需要结合工具语义、权限范围、参数约束、审批策略、运行环境隔离等信息进一步判断风险等级。
启发:把 Agent 安全前移到代码阶段
Agent 安全不能只靠运行时拦截。
运行时拦截当然重要,比如工具调用审批、敏感参数检测、沙箱隔离、模型输出检测、策略引擎拦截。但这些机制通常发生在 Agent 已经跑起来之后。
AgentFlow 的价值在于,它把一部分安全问题前移到了代码阶段。
在 Agent 程序上线前,企业就可以问:
这个 Agent 新增了什么能力? 新增能力是否被 Prompt 可达? 是否引入了新的 handoff 路径? 是否共享了原本不该共享的 memory? 高危工具前是否有 policy? policy 是否覆盖了完整调用路径? 本次代码变更是否扩大了 Agent 的真实能力边界?
这非常适合接入 CI/CD。
例如,每次开发者提交 Agent 代码时,系统自动生成 ADG diff:
- 新增了哪些 Agent
- 新增了哪些工具和 MCP 能力
- 哪些 Agent 新增了到高危工具的控制流路径
- 哪些 Prompt 新增了到工具参数的数据流路径
- 哪些 memory 变成多个 Agent 共享
- 哪些审批策略被移除、绕过或没有覆盖新增路径
这样,Agent 安全审计就不再只是上线前人工填表,而可以进入工程流水线。
从产品设计角度看,ADG 可以成为 Agent 安全平台里的底层 IR。上层可以做资产发现、能力边界分析、Agent BOM、Prompt-to-Tool 风险检测、权限收敛建议、变更审计、合规报告生成。
这比单纯做“工具风险标签”更进一步。
工具风险标签只告诉你“这个工具危险”。 ADG 告诉你“谁能碰到这个工具,数据怎么过去,中间有没有控制点”。
局限性
这篇论文的边界需要说清楚。
第一,ADG 是静态分析,天然会有过近似。它看到的是程序结构允许的路径,不代表运行时模型一定会走这条路径。因此,它适合做风险发现和治理审计,不适合直接作为漏洞定罪依据。
第二,它依赖框架语义建模。论文支持五类主流 Agent 框架,但 Agent 框架变化很快,企业内部也经常有二次封装。如果开发者自己封装了工具注册、动态路由、多工具 wrapper,静态规则就可能漏掉。论文在漏报分析中也提到,自定义 command wrapper、动态工具绑定、自定义编排、LangGraph 特定 state/tool binding、多工具 wrapper 都会造成 missed risks。
第三,ADG 能发现“路径”,但不能完全理解“工具语义”。比如同样是文件访问,读文件、写文件、删除文件风险不同;同样是 SQL,查询和修改风险不同;同样是代码执行,受限计算器和任意 shell 执行不是一个级别。这也是论文中 false positive 的主要来源之一。
第四,ADG 不能替代运行时防护。Prompt 注入、工具投毒、恶意 Skill、MCP 描述污染、多轮诱导、模型幻觉调用等问题,仍然需要动态测试、红队评测、运行时策略引擎和沙箱隔离共同处理。
所以更合理的定位是:
ADG 不是 Agent 安全的全部,而是 Agent 安全工程化的一层基础设施。
它让企业在上线前看清结构性风险,再把高风险路径交给更细粒度的 SAST、DAST、fuzzing、红队测试和运行时防护去验证。
从“有没有工具”走向“能力边界是否可控”
如果把这篇论文转化成企业 Agent 安全治理方案,可以抽象成四件事。
第一,建立 Agent 资产图谱。
不只登记模型和工具,还要登记 Agent、Prompt、Memory、MCP、Skill、Policy 之间的绑定关系。每个 Agent 都应该有自己的能力画像。
第二,建立高危能力路径分析。
对文件写入、数据库修改、命令执行、外部发送、权限变更、代码提交、工单审批等能力,分析哪些 Agent 可达,哪些 Prompt 可影响,哪些上下文可进入参数。
第三,建立 Agent 变更审计。
Agent 的风险变化通常来自小改动:加了一个工具、改了一个 Prompt、换了一个 memory、打开了一个 handoff、接了一个 MCP Server。ADG diff 可以帮助安全团队判断能力边界是否扩大。
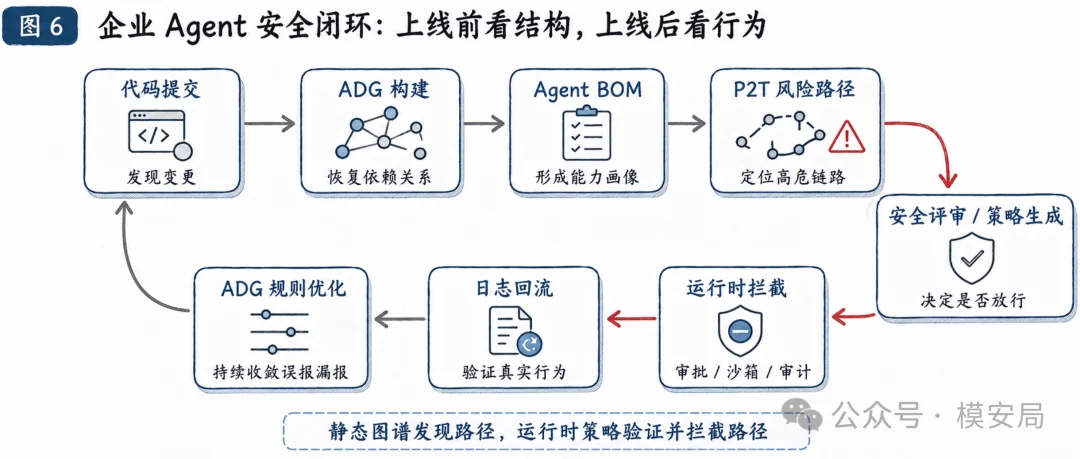
第四,建立运行时策略闭环。
静态图谱发现路径,运行时策略验证和拦截路径。比如 ADG 发现 Prompt 可以影响 SendEmail,运行时就应该重点检查邮件收件人、正文、附件、审批策略、调用来源和上下文污染情况。
写在最后
Agent 安全正在从内容安全走向行为安全,也从单点工具检测走向系统级依赖分析。
一个 Agent 是否安全,不只取决于它用了什么模型、挂了什么工具,也取决于 Prompt、工具、记忆、handoff、审批策略之间如何连接。
ADG 的价值就在这里。
它不是再发明一个安全标签,而是给 Agent 程序提供了一种更适合审计的中间表示:把原本散落在源码、Prompt、工具配置、框架 API 和多 Agent 编排里的信息,统一变成一张可查询的依赖图。
有了这张图,企业才能真正回答几个关键问题:
Agent 到底能做什么? 谁能影响它去做? 它能把信息传给谁? 高危动作前有没有控制点? 一次代码变更是否扩大了能力边界?
Agent 的风险,不只在工具里,也在路径里。 ADG 要解决的,就是把这些路径提前画出来。
— end —
同专题推荐
查看专题不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?