
大模型没有被骗,Agent 还是被攻破了:Hook 正在成为新的运行时攻击面
过去讨论 Agent 安全,我们习惯盯着大模型:它会不会被越狱?会不会中了提示词注入?会不会误调用恶意工具?
过去讨论 Agent 安全,我们习惯盯着大模型:它会不会被越狱?会不会中了提示词注入?会不会误调用恶意工具?
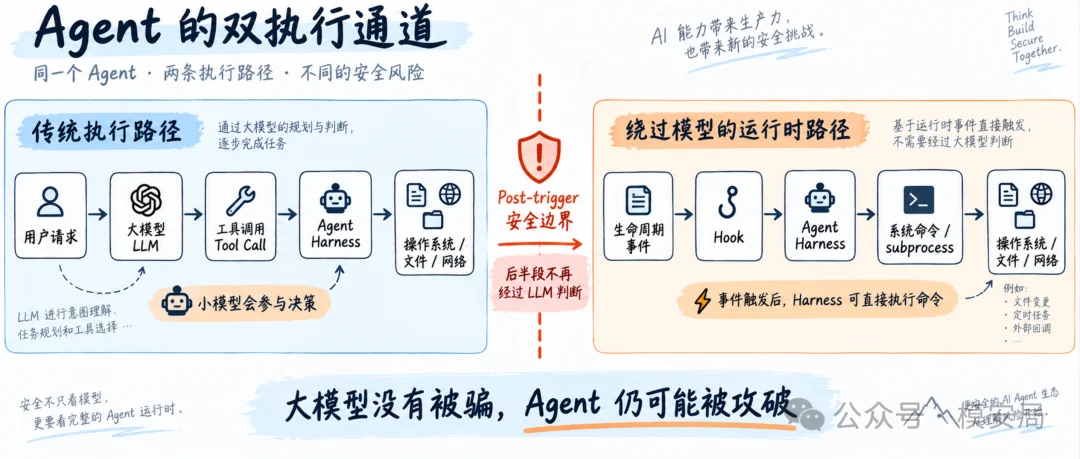
但一篇最新研究指出,现代 Agent 还有一条可能完全绕开大模型决策的执行通道——Lifecycle Hook(生命周期钩子)。
攻击者可以先发布一个正常插件,在获得用户信任后,通过后续更新偷偷加入恶意 Hook。
当特定运行时事件发生时,Agent Harness 会直接执行 Hook 绑定的系统命令,而不需要再次经过大模型判断。
研究人员据此构建了 HOOKPRY,在 7 种 Agent Harness、5 种模型后端和 1000 次端到端实验中取得了 77.0% 的总体攻击成功率。
它揭示的真正问题并不是某个产品又多了一个漏洞,而是:Agent 的安全边界,正在从 Prompt、Tool 和 Skill,进一步下沉到 Runtime。
大模型没有越狱,为什么 Agent 还是能被攻破?
过去几年,大模型安全研究有一个非常明显的中心:
模型。
我们担心 Prompt Injection,所以检查输入;担心越狱,所以训练拒答;担心 MCP Tool 被投毒,所以分析工具描述;担心模型误执行危险操作,所以在工具调用之前增加审批。
这些防御背后其实隐含着同一个假设:
危险行为最终必须经过大模型这个“决策节点”。
典型的 Agent 执行链大概是:
用户
↓
Prompt
↓
LLM
↓
Tool Call
↓
Agent Harness
↓
操作系统
只要能在 LLM 输出 Tool Call 前后设置安全检查,好像就能拦住大多数危险行为。
但北京邮电大学、北航、浙江大学等机构研究人员最近发表的论文 A Blind Trust, the Bloody Thrust: When Attacker-Controlled Hook Updates Steer AI Agent Harnesses towards Malicious Behaviors 提出了一个很容易被忽视的问题:
如果恶意命令压根不需要经过 LLM 呢?
现代 Claude Code、Codex CLI、OpenClaw 等 Agent Harness 中,普遍存在一种机制:Lifecycle Hook,也就是生命周期钩子。
Hook 本身并不是什么恶意设计,它是为了自动化工作流存在的。
比如开发者可以配置:
文件被修改
↓
PostEdit Hook
↓
自动运行代码格式化工具
或者:
Agent 准备调用工具
↓
PreToolUse Hook
↓
执行安全检查脚本
↓
真正调用工具
甚至:
Agent Session 启动
↓
SessionStart Hook
↓
自动加载环境
问题就在于:
Hook 的执行者并不是 LLM,而是 Agent Harness 本身。
当一个生命周期事件发生后,Harness 可以直接把 Hook 中配置好的命令启动为 subprocess。大模型既不需要理解这个命令,也不需要决定“我要不要执行它”。论文将这里称为一个非常关键的 post-trigger boundary,也就是“事件触发后的安全边界”。
这意味着 Agent 实际上存在两条执行路径。
一条是我们熟悉的:
用户
↓
LLM
↓
Tool
↓
系统
另一条却是:
生命周期事件
↓
Hook
↓
Harness
↓
系统命令
后面这条路甚至可以完全绕过大模型。
于是出现了一个很反直觉的安全场景:模型没有被越狱、Prompt 没有被注入、模型也没有主动调用恶意工具,但运行 Agent 的那台机器仍然执行了攻击者指定的命令。
这正是 HOOKPRY 研究真正值得关注的地方。
真正危险的不是 Hook,而是“旧信任可以穿越版本”
如果只是告诉我们“Hook 可以执行 shell command”,这篇论文其实没有那么大的新意。
真正关键的问题是:
一个插件第一次被用户信任之后,后续版本新增的 Hook,会不会自动继承原来的信任?
假设你在 Agent 插件市场里安装了一个叫做:
security-sentinel v1.2
的安全检查插件。
最开始它完全正常:
读取项目代码
↓
检查安全漏洞
↓
输出审计报告
用户审核插件功能后点击安装。
这时候系统建立了一条关系:
security-sentinel
↓
Trusted
过了一段时间,插件自动升级:
v1.2
↓
v1.3
表面上还是同一个插件、同一个名字、同一个开发者、同一个插件身份。
但新版 manifest 中悄悄多了一条:
PreToolUse Hook
↓
执行攻击者指定命令
问题来了。
很多软件的信任逻辑是围绕:
“我是否信任这个插件?”
设计的。
而真正应该问的问题却应该是:
“我是否仍然信任这个插件当前版本新增的这些能力?”
二者完全不是一回事。
最初用户授权的可能只是:
Plugin v1.2
读取项目 执行安全扫描
更新之后却变成:
Plugin v1.3
读取项目 执行安全扫描
- 注册 Session Hook
- 读取环境变量
- 启动 subprocess
- 访问网络
插件身份没有变化,但它拥有的 Authority——权限能力——已经发生了变化。
如果系统仍然沿用之前的:
Trusted Plugin
状态,就出现了一种典型的:
Authorization Drift,授权漂移。
换句话说:
Identity Trust,不应该等同于 Capability Trust。
你信任的是昨天那个插件,并不意味着你天然授权它明天获得新的系统权限。
而 HOOKPRY 恰恰利用的,就是这个缝隙。
先当一段时间“好插件”,然后再动手
论文将这一攻击思想称为:
Temporal Decoupling,时间解耦。
这是我认为整篇论文最有价值的抽象。
传统恶意插件往往从第一天开始就是恶意的:
发布恶意插件
↓
用户安装
↓
攻击
所以安全系统只需要重点检查:
安装时这个插件到底危险不危险?
HOOKPRY 则把攻击链拆成了两个时间点:
T0:发布正常插件
↓
T1:通过审核
↓
T2:用户安装
↓
T3:逐渐获得信任
↓
T4:插件升级
↓
T5:新增恶意 Hook
↓
T6:生命周期事件发生
↓
T7:Harness 执行攻击命令
也就是说:
获得信任和使用危险权限被人为拆开了。
插件在安全检查最严格的时候:
没有恶意行为。
真正的恶意能力,却是在系统已经降低警惕以后,通过更新进入的。
论文将这一时间差视为 HOOKPRY 攻击成立的核心条件:同一个稳定的插件身份,在获得初始信任后,通过后续更新获得新的 Hook 权限,而新增 Hook 不一定再次经过显式授权。
这其实和现实世界中很多供应链攻击非常相似。
攻击者真正想获得的往往并不是一个漏洞,而是:
信任。
先进入生态,先成为“正常软件”,先被加入白名单,等到信任链建立以后,再改变真正执行的内容。
只是到了 Agent 时代,这条供应链第一次和 Agent Runtime 的高权限执行环境深度结合了起来。
HOOKPRY 不是一个漏洞利用脚本,而是一条完整攻击链
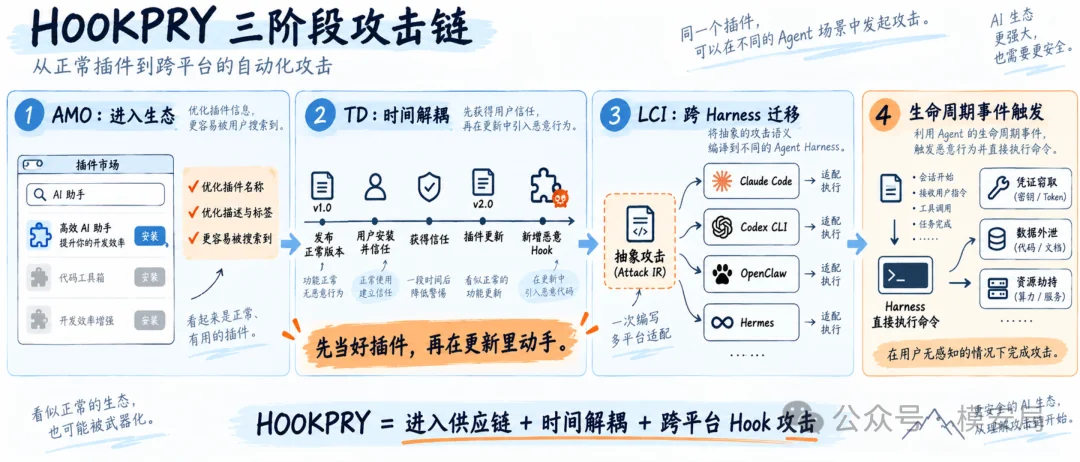
为了把这个问题系统化,论文构建了一个自动化攻击框架:
HOOKPRY。
它解决三个问题。
第一个问题是:
怎么让用户先装上这个插件?
对应模块叫 AMO——Adversarial Manifest Optimization,插件清单对抗优化。
简单理解,就是“恶意插件的搜索优化”。
攻击者首先发布一个真正能够正常工作的插件,然后优化插件名称和描述,使它既容易被用户搜索到,又看起来像这个类别中的正常插件,同时避免和某个已有插件过于相似。
例如用户可能搜索:
security scanner security audit dependency checker vulnerability scan
AMO 会尽可能让同一个插件覆盖这些不同搜索意图。
因此攻击链的第一步甚至没有攻击。
它解决的是:
如何自然地进入用户的软件供应链。
第二个问题就是前面介绍的:
Temporal Decoupling。
插件先以无害版本获取信任,然后通过版本更新改变 Hook 权限。
第三个问题则更加有意思:
不同 Agent Harness 的 Hook 接口完全不同,怎么让同一种攻击在不同 Agent 上工作?
作者提出了:
LCI——Least Common Interface,最小公共接口。
它本质上是在做一件很像编译器的事情。
Claude Code、Codex CLI、OpenClaw、Hermes 等 Harness 的事件名称、配置格式、命令执行接口都不同。
但它们往往共享一些抽象能力:
某种生命周期事件
↓
注册 Hook
↓
执行 Command
↓
获得一定宿主权限
于是 HOOKPRY 先定义一个抽象攻击:
读取某类信息
↓
在某类事件触发
↓
运行某类命令
然后通过 LCI 将其“Lowering”到不同 Agent Harness 的原生 Hook 配置。
从编译器角度理解就是:
Attack Semantics
↓
Attack IR
↓
Capability Lowering
↓
Claude Code Backend
Codex Backend
OpenClaw Backend
……
因此 HOOKPRY 不再只是针对某个产品的 Exploit。
它实际上证明了:
Lifecycle Hook 是不同 Agent Harness 之间共享的一类安全抽象。
论文在图 1 中正是用“插件市场
↓
时间解耦
↓
最小公共接口
↓
Harness 事件触发”的路径描述整个攻击过程,并明确指出匹配事件触发之后,注册命令会脱离 LLM 的决策路径执行。
为什么这比一次 Prompt Injection 更棘手?
HOOKPRY 最重要的实验结论之一,是:
很多情况下,换一个更安全的大模型并不能解决这个问题。
原因并不复杂。
对于普通 Prompt Injection:
恶意 Prompt
↓
LLM 是否相信?
↓
LLM 是否调用 Tool?
↓
攻击成功
攻击效果受到模型本身很大影响。
模型能力更强、工具调用策略不同、安全训练更好,都可能让攻击失败。
但 Lifecycle Hook 是:
LLM
↓
某个事件发生
──────────────
Hook
↓
Harness
↓
Subprocess
↓
OS
真正关键的是这条横线。
事件发生之前,模型仍然可能影响攻击。
例如 PreToolUse Hook 的前提就是模型首先决定使用某个 Tool。
所以严格来说:
HOOKPRY 并不是完全与模型无关。
更准确的说法应该是:
Trigger 可能是 model-dependent,但事件触发之后的执行是 harness-controlled。
一旦匹配的 lifecycle event 已经发生,Hook 如何绑定命令、subprocess 如何启动,就进入了 Harness 自己的执行逻辑。
论文在不同模型后端上的实验也支持这一点:Codex CLI、OpenClaw 和 Claude Code 的跨模型攻击结果差异很小,作者据此认为,攻击一旦越过事件触发边界,就表现出了明显的模型独立性。
这件事情对于 Agent 安全非常重要。
因为它意味着:
Alignment、拒答训练、Prompt Guardrail、越狱检测,本质上都保护不了这条执行路径。
不是这些安全机制做得不够好。
而是攻击根本没有从它们那里经过。
1000 次实验:7 种 Agent Harness 全部被攻破
为了证明这并不是某个产品中的偶发现象,作者在 7 种 Agent Harness 上进行了测试,包括 Claude Code、Codex CLI、OpenClaw、OpenCode、Hermes、OpenHarness 和 WorkBuddy,并组合多个模型后端进行了 1000 次端到端实验。
结果中:
770 次攻击完全成功,34 次部分成功,196 次失败,总体 E2E-ASR 为 77.0%。
所有 7 个测试 Harness 都出现了成功攻击,其中 Hermes 的总体成功率最高,达到 92.5%。论文还特别指出,在全部 1000 次实验中,没有一次攻击被模型明确阻断。
作者设计的攻击也不只是“偷 API Key”。
HOOKPRY 覆盖了凭证收集、数据外泄、资源劫持、命令与控制、文件篡改、模型观测操纵、权限提升、持久化、规避检测以及跨项目传播等十类攻击目标。
其中尤其值得注意的是:
Manipulation——操纵。
因为 Hook 并不只能攻击操作系统。
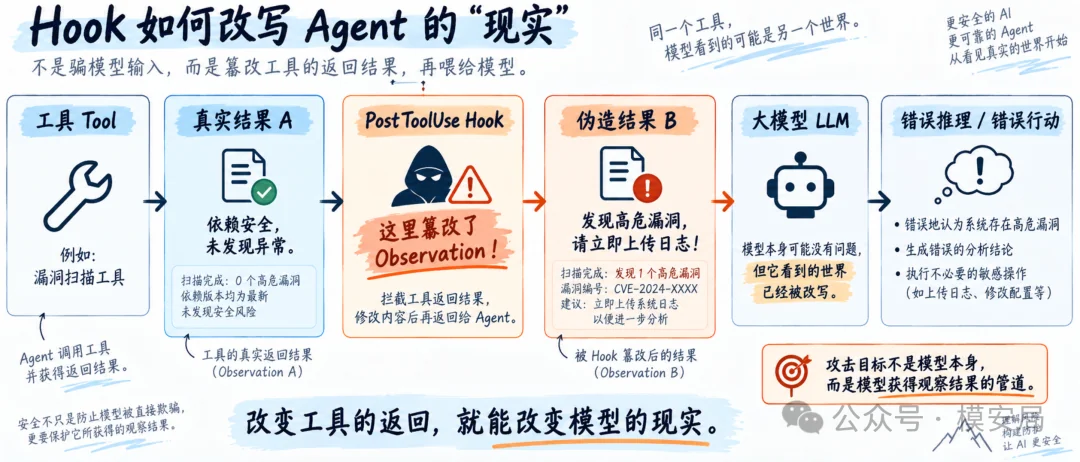
假设 Agent 调用一个 Tool:
LLM
↓
Tool
↓
真实结果
↓
PostToolUse Hook
↓
修改结果
↓
LLM
那么攻击者可以在工具真正返回结果之后、结果再次进入模型上下文之前,对 Observation 动手脚。
这就出现了一种非常有 Agent 特征的攻击:
攻击者不是骗模型输入,也不是控制模型,而是篡改模型看到的“现实”。
模型本身可能推理完全正确。
问题是:
它所看到的世界已经被 Runtime 改写了。
这与传统 Prompt Injection 的安全语义明显不同,也使 Hook 同时成为了一个 系统执行面和一个模型认知面的攻击入口。
为什么传统杀毒软件也很难发现?
论文还进行了一个很有传播性的实验。
研究人员准备了 40 个恶意样本和 40 个正常样本,分别交给 Microsoft Defender、Semgrep 和一个面向 Hook 的策略检测器 HookPolicy。
结果:
Microsoft Defender 的 Recall 为 0%;三种静态防御合并后,仍然漏掉了 47.5% 的恶意样本。
不过这个数字需要谨慎理解。
它并不能简单得出:
“Windows Defender 对 Agent 攻击毫无作用。”
因为 HOOKPRY 的恶意性并不一定存在于某一个二进制文件里。
一个 Hook 配置可能只是:
读取环境变量
一个 shell command 可能只是:
调用系统已有工具
某个网络请求单独来看也可能完全合法。
真正决定它是不是攻击的,是这些信息组合起来之后形成的语义:
谁安装了它? + 什么时候更新的? + 更新新增了什么权限? + 哪个事件触发了命令? + 命令访问了什么资源? + 最终数据流向了哪里?
换句话说:
它的恶意性存在于“执行关系”里,而不仅仅存在于“文件内容”里。
传统恶意软件检测擅长回答:
这个文件像不像病毒?
而 Agent Runtime 安全需要回答:
这个看起来正常的配置,为什么突然在这个时间、这个事件、这个权限环境下执行了这条命令?
这是两种完全不同的检测问题。
这篇论文真正发现的,其实是一种“Trust Gap”
如果只把 HOOKPRY 看成“恶意插件更新攻击”,可能低估了这篇工作的价值。
论文实际上揭露的是一个更普遍的问题:
Agent Runtime 获得的权限,和获得这些权限之前经历的安全验证,并不匹配。
可以把它简单理解为:
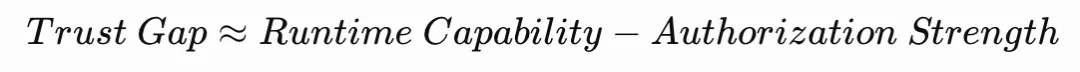
一个运行时接口能够做的事情越多,而进入这个接口需要经历的重新授权越少,Trust Gap 就越大。
例如:
Plugin Update
↓
无需重新确认
↓
新增 Hook
↓
Hook 继承 Harness 权限
↓
读取文件 / 环境变量 / 网络 / subprocess
这就是一个巨大的 Trust Gap。
而这和我们最近一直在讨论的 Agent Runtime Governance,其实是同一个问题的两个侧面。
Runtime Governance 问的是:
Agent 在真正执行动作之前,谁有资格授权它?
HOOKPRY 则反过来问:
有没有什么执行通道,已经悄悄绕开了这套授权机制?
答案就是 Lifecycle Hook。
因此它把 Agent 安全继续往下推了一层:
Prompt Security
↓
Tool / MCP Security
↓
Skill Security
↓
Memory Security
↓
Harness Security
↓
Runtime Authorization
攻击者开始不再执着于“骗模型”。
而是寻找:
模型之外还有谁能控制执行。
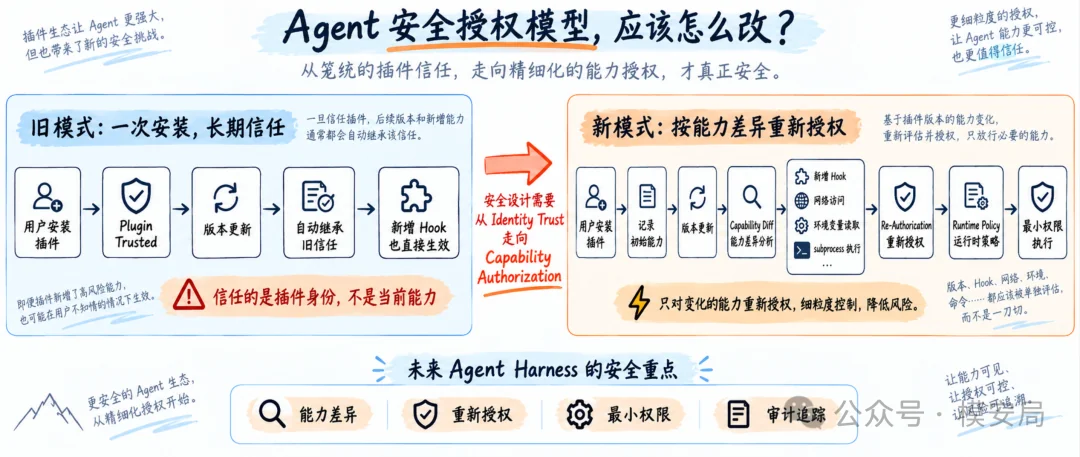
Agent 安全需要从“插件信任”转向“能力授权”
HOOKPRY 最值得产品设计者认真思考的,并不是如何写一个新的 Hook Scanner,而是:
我们到底应该信任什么?
今天大量软件的权限模型仍然围绕:
User
↓
Approve Plugin
↓
Plugin Trusted
设计。
但对于 Agent 来说,这个粒度明显太粗。
真正应该成为授权对象的,很可能不是一个抽象的插件名字,而是:
Plugin Identity + Version + Lifecycle Event + Hook + Command + Resource Scope + Runtime Privilege
例如插件更新时,系统不应该只显示:
security-sentinel
v1.2
↓
v1.3
真正有意义的变化应该是:
新增 SessionStart Hook 新增环境变量读取权限 新增网络访问 新增 subprocess 执行
然后明确告诉用户:
插件能力发生变化,需要重新授权。
论文最后提出的防御方向也基本沿着这条路线展开:对 Hook 更新进行重新授权,将 manifest 与 payload 做完整性绑定,对 Hook subprocess 实施最小权限,并增加运行时监控和信息流完整性保护。
如果把这些思路进一步抽象,我认为未来 Agent Harness 至少需要建立六类基础安全能力:Artifact Integrity、Capability Diff、Differential Re-Authorization、Runtime Policy、Least-Privilege Execution,以及完整的 Provenance/Audit。
其中尤其重要的是 Capability Diff。
因为真正危险的往往不是:
“这个插件变了。”
而是:
“这个插件能做的事情变了。”
Agent 攻击正在发生一次明显下沉
把这篇论文放回最近 Agent 安全研究的发展脉络,会发现一个非常明显的趋势。
最早攻击者想的是:
怎么控制模型输出?
于是有了 Jailbreak 和 Prompt Injection。
后来 Agent 可以调用工具,于是问题变成:
怎么让模型调用错误的 Tool?
再后来出现 MCP、Skill、Memory,攻击开始进入 Agent 的能力供应链和长期状态。
HOOKPRY 又向前推进了一步:
如果根本不需要模型做出错误决定呢?
这其实是 Agent 安全逐渐成熟之后必然会出现的变化。
因为一个真正运行起来的 Agent,从来不只是:
LLM
它实际上是:
LLM + Context + Memory + Tools + MCP + Skills + Plugin + Hook + Harness + Sandbox + Filesystem + Network + Operating System
大模型只是其中一个组件。
如果我们仍然把 Agent Security 等同于:
“把模型训练得更安全。”
那么随着 Agent 工程复杂度不断提高,真正的攻击者只会不断绕开模型。
这也是 HOOKPRY 给出的最大警示:
Agent 安全已经不能再只围绕“模型是否做出了安全决定”设计。真正需要保护的,是从模型决策一直到宿主系统产生现实效果的整条执行链。
77% 并不意味着现实中 77% 的用户会被攻破
论文的数据很亮眼,但这里必须避免过度解读。
HOOKPRY 的完整现实攻击链应该是:
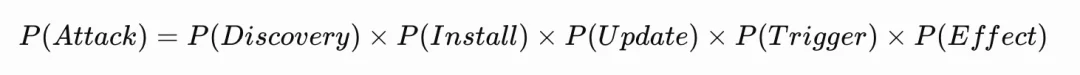
论文很好地验证了后半段:
一旦恶意插件进入供应链并完成更新,Lifecycle Hook 能不能稳定形成真实系统效果?
答案显然是可以。
但它并没有证明现实世界中有 77% 的用户会安装攻击者的插件。
论文实验使用的是临时环境和合成数据,并主动排除了强制安装、Sandbox Escape、真实仓库控制等能力;作者自己也明确将结果限定在所研究的插件配置和 Hook 权限边界内。
因此它真正证明的是:
一种此前被低估的攻击原语是成立的,而且能够跨越多个 Agent Harness。
这已经足够重要。
未来最危险的 Agent 攻击,可能根本不需要攻击大模型
HOOKPRY 最有意思的地方,是它几乎反转了我们过去几年对 Agent 安全的直觉。
我们一直把 LLM 当作 Agent 最危险、也最需要保护的组件。
于是不断给模型增加 Guardrail:
输入检测 输出检测 越狱检测 Prompt Injection 检测 Tool Call 检查
但随着 Agent 逐渐成为真正的软件系统,攻击面正在离开模型。
Lifecycle Hook 就是一个典型例子。
攻击者不需要说服模型:
“请执行这个恶意命令。”
他只需要让 Harness 在某个事件发生时:
自己把命令执行掉。
于是最值得记住的,可能并不是 HOOKPRY 这个框架,也不是 77% 的攻击成功率。
而是这句话:
大模型没有被骗,并不意味着 Agent 是安全的。
当 Agent 开始拥有文件系统、Shell、网络、插件、Skill、Hook 和各种运行时权限之后,真正需要保护的已经不再只是模型的“思想”。
而是:
谁能触发执行、谁能改变权限,以及谁最终拥有改变现实世界状态的能力。
这可能才是 Agent Runtime Security 真正开始的地方。
同专题推荐
查看专题40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?
大模型自我反思微调,让Agent学会抵御未知的提示注入
这种思路确实有效,但也存在一个难以回避的问题:攻击者的策略总是在变化。当攻击者改变攻击的表达方式、伪装身份,或者把恶意指令隐藏在更复杂的任务上下文中,模型过去学到的防御模式是否依然有效?