
Agent 安全事故报告框架:3大类、17项关键要素
一次 Agent 安全事故可能持续数小时甚至数天:它先读取网页和邮件,将部分信息写入记忆;之后调用搜索、代码执行或文件工具;再将任务委托给另一个 Agent;
当一个普通大模型出现安全问题时,我们通常会回头检查:用户输入了什么 Prompt、模型使用了哪个版本、系统提示词是什么、模型最终输出了什么。
但到了 Agent 时代,这套方法开始失效。
一次 Agent 安全事故可能持续数小时甚至数天:它先读取网页和邮件,将部分信息写入记忆;之后调用搜索、代码执行或文件工具;再将任务委托给另一个 Agent;子 Agent 使用用户身份访问外部系统,最终执行了一个高风险操作。
真正的问题可能并不存在于某一次输入或输出中,而是隐藏在整条执行链路里。
2026 年 9 月,一篇由学术界和产业界专家共同参与的论文《Beyond Predictable Paths: AI Security Incident Reporting for Compromised Agents》试图解决这个问题。
两位编辑作者综合了 23 位来自学术界、产业界、安全机构和标准化组织专家的意见,提出了一套面向 Agent 的初步安全事故报告方案,将需要记录的信息归纳为 3 大类、17 项关键要素。
参与者来自 Microsoft Security Response Center、IBM Research、Qualcomm、Snyk、OWASP GenAI Security Project、CMU、Northeastern University 等机构。
论文关注的并不是一种新的攻击方法,而是一个更基础的问题:
当 Agent 真正发生安全事故以后,我们需要留下哪些信息,才能知道到底发生了什么?
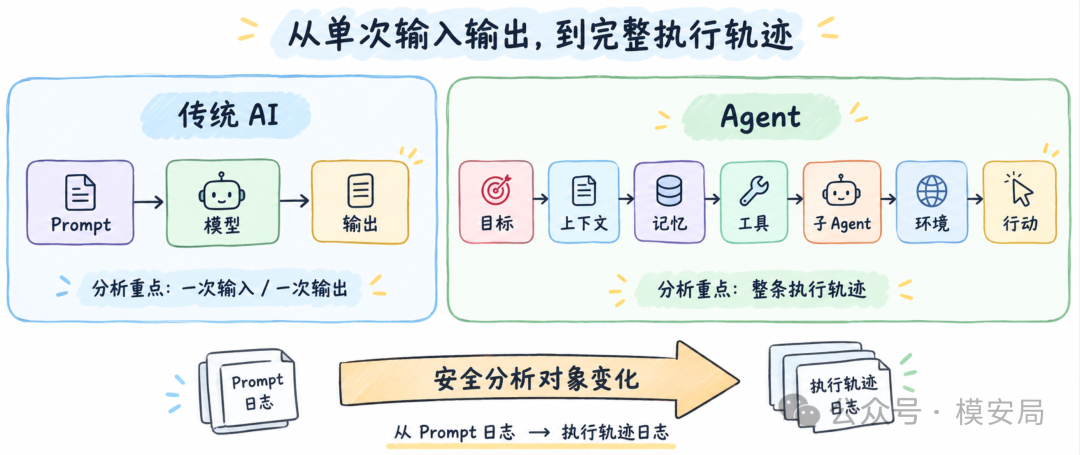
从一次输入输出,到一条完整执行轨迹
传统 AI 系统通常可以抽象成:
输入
↓
模型
↓
输出
因此,一次事故往往可以围绕某个输入输出对进行分析。
Agent 则不同。它面向的不是一个孤立任务,而是一个需要经过多个步骤完成的目标。在实现目标的过程中,Agent 可能不断推理、读取外部数据、访问记忆、调用工具、影响操作系统,甚至动态调用其他 Agent。
因此,一次 Agent 事故更接近:
目标
↓
上下文
↓
推理
↓
数据读取
↓
工具调用
↓
状态变化
↓
记忆写入
↓
子 Agent
↓
外部系统
↓
……
↓
事故
论文将这种特征称为明显的 “轨迹级(trajectory-level)”特征。
除了执行过程更长之外,Agent 还具有更强的外部操作能力,并且一个 Agent 系统内部可能同时包含多个模型、检索模块、Guardrail、Judge、子 Agent 和编排器。
这带来一个关键变化:
Agent 安全事故的基本分析单位,正在从一次 Prompt 和一次模型输出,转变为一条完整的执行轨迹。
这也是为什么传统的大模型日志越来越难以支撑 Agent 时代的安全取证。
Agent 安全事故报告框架
针对这一问题,论文最终给出了一套初步报告方案。
17 项信息被划分为三个部分:Agent 与执行轨迹、Agent 能力,以及 Agent 子组件与编排关系。
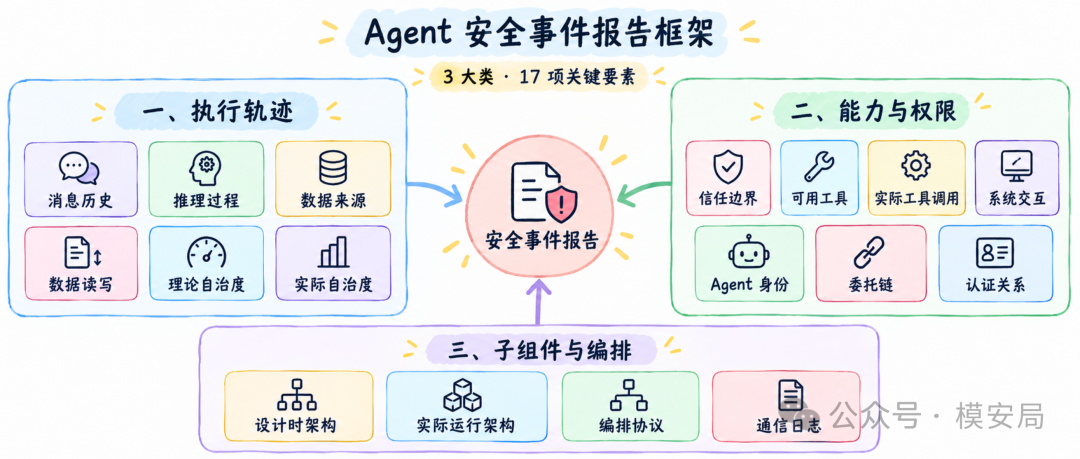
| 关键要素 | 需要回答的问题 |
|---|---|
| 一、执行轨迹类 | |
| 消息历史 | 用户与 Agent 之间说过什么 |
| 推理 Tokens | Agent 在执行过程中产生了哪些推理相关输出 |
| 数据来源 | 外部数据从哪里来、使用了哪个版本 |
| 数据读写 | Agent 读取和修改过哪些数据 |
| 理论自治度 | 系统设计上允许 Agent 自主做到什么程度 |
| 实际自治度 | 事故中 Agent 实际自主到了什么程度 |
| 二、能力与权限类 | |
| 信任边界 | 哪些组件、用户或环境被系统信任 |
| 可用工具 | Agent 理论上可以访问哪些工具及版本 |
| 实际工具调用 | 实际调用了哪些工具、参数和返回结果是什么 |
| 操作系统交互 | 对底层系统和运行环境执行了什么操作 |
| Agent 身份 | Agent 以什么身份和权限运行 |
| 委托链 | 任务从人或 Agent 如何逐层传递 |
| 身份认证信息 | 工具访问过程中使用了什么认证关系 |
| 三、子组件与编排类 | |
| 设计时多 Agent 架构 | 系统原本定义了哪些 Agent 及其功能 |
| 实际多 Agent 架构 | 事故过程中真正调用了哪些 Agent |
| 编排协议 | Agent 之间如何协调和组织执行 |
| 通信日志 | Agent 之间实际交换了什么信息 |
这里最值得关注的,并不是简单增加了十几个日志字段,而是事故报告的视角发生了变化:
不仅要记录模型“说了什么”,还必须记录 Agent“看到了什么、拥有了什么、调用了什么、以谁的身份行动,以及谁把权力交给了谁”。
▎第一类:还原完整轨迹——Agent 到底经历了什么?
第一组信息关注的是事故发生之前,Agent 究竟经历了怎样的执行过程。
其中最基础的是消息历史和运行轨迹。除了用户与 Agent 的交互,论文认为还应该尽可能保留执行日志、连接系统状态以及推理阶段产生的信息,因为一些针对 Agent 推理过程的影响可能只存在于中间阶段,而不会出现在最终输出中。
更重要的是上下文、外部数据和记忆。
传统日志通常习惯记录请求和响应,但 Agent 的 Context 可能来自网页、邮件、RAG、文件、工具返回结果以及长期记忆。某段影响 Agent 行为的信息可能只短暂存在于 Context Window 中,任务完成或上下文被压缩以后便消失。
因此论文提出,应尽可能记录执行过程中出现的上下文,并为外部数据保存来源和版本信息;对于可以被 Agent 修改的 Memory,则需要记录具体的数据读取与写入变化,并提供防篡改能力。
这对长期运行的 Agent 尤其重要。
一次异常行为发生在今天,真正的问题却可能来自几天前的一次记忆写入。如果事故分析只截取“出事前 30 分钟”的日志,很可能永远找不到最初的原因。
理论自治度和实际自治度
这一类中最值得关注的新概念,是论文将 Agent 自治程度拆成了两种:
Theoretical Autonomy——理论自治度,即设计阶段允许 Agent 自主执行到什么程度。
Effective Autonomy——实际自治度,即在具体事故轨迹中,Agent 实际自主完成到了什么程度。
例如,一个代码 Agent 的设计规则可能是:
可以自动修改代码,但部署生产环境必须经过人工确认。
这是理论自治度。
但真正发生事故时,由于工作流组合、权限传递或者其他机制,Agent 最终可能绕过了这一步人工确认。
这就是实际自治度。
更进一步,自治程度并不是一个固定的 L1、L2 或 L3 标签。它可能随着动作类型、调用工具、执行阶段和组件不断变化。论文因此认为,事故报告需要记录 Agent 在整条轨迹上的实际自治状态。
换句话说:
真正需要审计的,不只是“这个 Agent 有多自主”,而是“在出事的那一步,它究竟拥有多大的自主权”。
▎第二类:记录实际能力——Agent 到底能够做什么?
如果说第一部分是在还原 Agent 的“经历”,第二部分则是在还原 Agent 的“能力”。
普通大模型最大的影响往往停留在生成内容层面,但 Agent 可以调用浏览器、代码执行器、数据库、邮件、云服务甚至操作系统。因此,安全事故不能只记录模型输出,还必须追踪这些输出最终转化成了什么现实操作。
论文特别区分了两种工具信息:
Available Tools——可用工具,即系统设计时允许 Agent 调用什么。
以及:
Effective Tool Use——实际工具使用,即事故过程中真正调用了什么工具、传入什么参数、又返回了什么结果。
这一区分非常重要。
一个 Agent 可能理论上拥有 20 个工具,但导致事故的实际链路只有:
Browser
↓
Email
↓
GitHub
反过来,系统设计时认为 Agent 只会调用某组工具,实际执行过程中却可能通过动态代码、插件或其他 Agent 获得新的能力。
因此,“它能做什么”和“它实际做了什么”必须同时被记录。
从低层操作,恢复成安全人员能够理解的事件
论文还讨论了传统系统安全中的一个经典问题:Semantic Gap,语义鸿沟。
例如浏览器 Agent 的底层日志可能只是:
click(x=843, y=421)
从系统角度看,这是一条非常准确的日志。
但对事故调查人员几乎没有意义。
真正需要知道的是:
Agent 点击了“确认支付”按钮。
因此未来 Agent 的安全日志不能只有底层事件:
browser.click、filesystem.write、tool.call
还需要尽可能将它们恢复成更高层的业务语义:
批准支付、发送邮件、删除文件、修改权限。
论文因此强调,Agent 安全已经不能只作为模型安全问题处理,而需要采用系统安全思路,将模型视为整个系统中的一个潜在不可信组件,并在工具、操作系统和外部环境层建立安全约束。
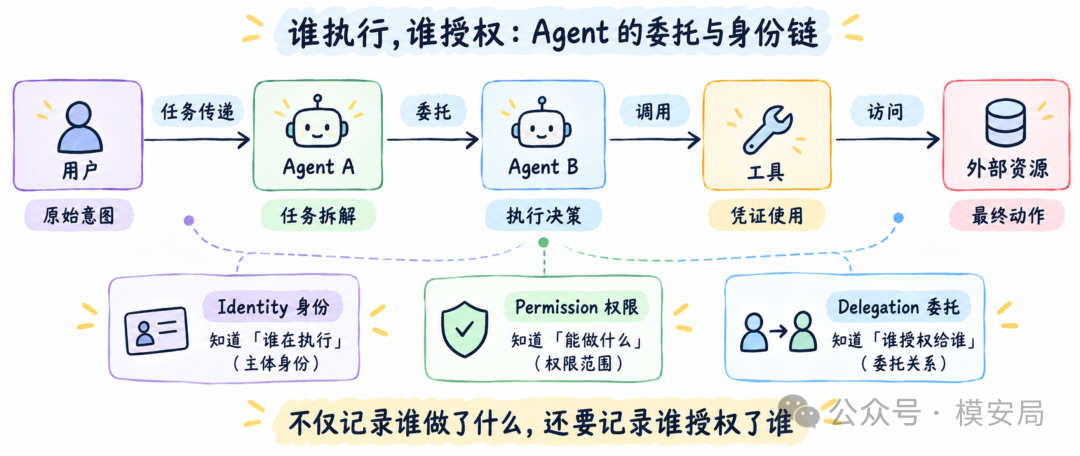
身份和委托链:不仅要知道“谁做了”,还要知道“谁授权了谁”
能力之外,论文特别强调了两个过去 AI 安全研究中相对边缘、但正在 Agent 时代迅速变得重要的概念:
Identity 和 Delegation。
假设存在这样一条执行链:
用户
↓
Agent A
↓
Agent B
↓
GitHub Tool
最终访问 GitHub 的可能仍然是用户的 OAuth 权限,但真正决定执行动作的可能已经是 Agent B。
如果只看传统 API 日志,我们可能只能知道:
某个用户身份修改了仓库。
但真正需要回答的是:
谁最初提出任务? Agent A 为什么委托给 Agent B? Agent B 为什么决定调用 GitHub? 最终使用的是谁的权限? 每一层分别拥有多大的授权范围?
因此论文提出,需要记录完整的 Delegation Chain——委托链,以及每次工具调用所对应的 Agent 身份、权限和认证关系。
这意味着未来 Agent 的安全审计对象可能不再只是简单的:
User
↓
Resource
而是:
Human
↓
Agent
↓
Sub-Agent
↓
Tool
↓
Resource
安全系统需要能够沿着整条链回答:
谁代表谁行动,谁授权了谁,最终是谁以什么权限完成了什么操作。
▎第三类:记录编排关系——事故可能不存在于任何一个 Agent 中
第三组信息针对多 Agent 系统。
一个现实 Agent 系统内部可能同时存在 Planner、RAG、Guardrail、Judge、Coding Agent、Browser Agent 等组件,而且某些组件和临时 Agent 还可能在运行时动态产生。
这带来一个过去模型安全中很少遇到的问题:
每一个组件单独检查可能都没有问题,但组件组合起来却出现了安全问题。
论文称,这类漏洞甚至可能完全是运行时涌现出来的系统属性。
例如 Agent A 的输出本身是合理的,Agent B 的处理逻辑也是合理的,某个工具也没有漏洞,但因为上下文在 Agent 之间传播、权限不断委托、多个步骤恰好组合在一起,最终形成了一条危险执行路径。此时不存在一个可以简单定位的“有问题模型”,漏洞存在于整个系统的交互关系之中。
因此论文要求同时记录:
设计时多 Agent 架构与事故发生时的实际多 Agent 架构。
此外还包括:
Agent 之间使用什么通信和编排协议、实际交换了哪些信息、分别拥有什么身份和权限,以及信息如何在不同组件之间传播。
这一点尤其值得关注。随着 A2A、MCP 以及各种 Agent 编排机制的发展,编排协议本身正在成为新的安全边界。
论文指出,这些协议控制着委托、上下文传播、工具调用和 Agent 间通信,因此认证不足、消息完整性不足、来源元数据缺失、权限语义模糊以及“指令和数据无法区分”等问题,都可能最终表现为 Agent 安全事故。
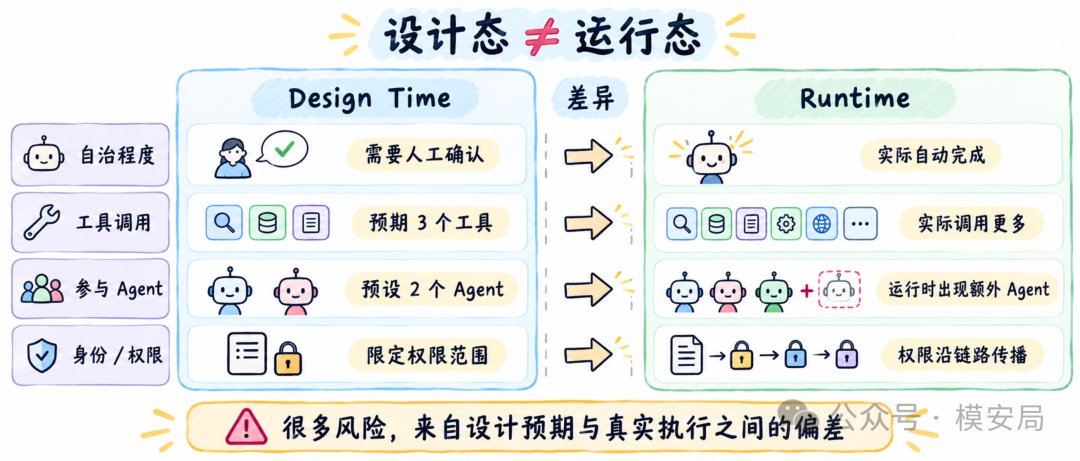
一个核心思想:设计态 ≠ 运行态
如果把整套框架进一步抽象,会发现论文反复强调的是同一种关系:
系统设计时是什么样,和真正发生事故时是什么样,不能混为一谈。
例如:
设计上允许 Agent 有多大自治权↔ 事故中实际使用了多大自治权
设计上允许调用哪些工具↔ 实际调用了哪些工具
设计时定义了哪些 Agent↔ 实际运行了哪些 Agent
设计上规定了怎样的权限边界↔ 实际执行时权限如何传播
因此,很多 Agent 安全问题其实可以理解成一种:
Design-Time / Runtime Gap——设计态与运行态之间的偏差。
传统安全评估经常问:
系统“应该”怎么运行?
而真正的事故调查必须回答:
它当时“实际上”是怎么运行的?
这也是为什么仅靠静态架构图、权限配置表或者 Agent Card,并不足以支持真正的 Agent 安全取证。
事故报告系统本身,也可能成为新的攻击面
论文还有一个非常重要、但容易被忽略的判断:
当我们开始依赖事故日志调查 Agent 时,日志系统本身也会成为攻击目标。
如果攻击者知道系统会记录哪些信息,就可能专门构造一种行为,使关键步骤无法进入事故报告;被控制的 Agent 也可能主动修改日志、改变访问方式,甚至生成具有误导性的事故描述。
换句话说,未来可能出现一种专门针对 Agent 取证机制的“反取证”问题:
不是让攻击不存在,而是让攻击在报告里看起来不存在。
因此,论文认为相关运行数据和事故记录需要具有完整性保证,理想情况下应该做到 tamper-resistant 或 tamper-evident,即难以篡改或者一旦被篡改能够被发现。
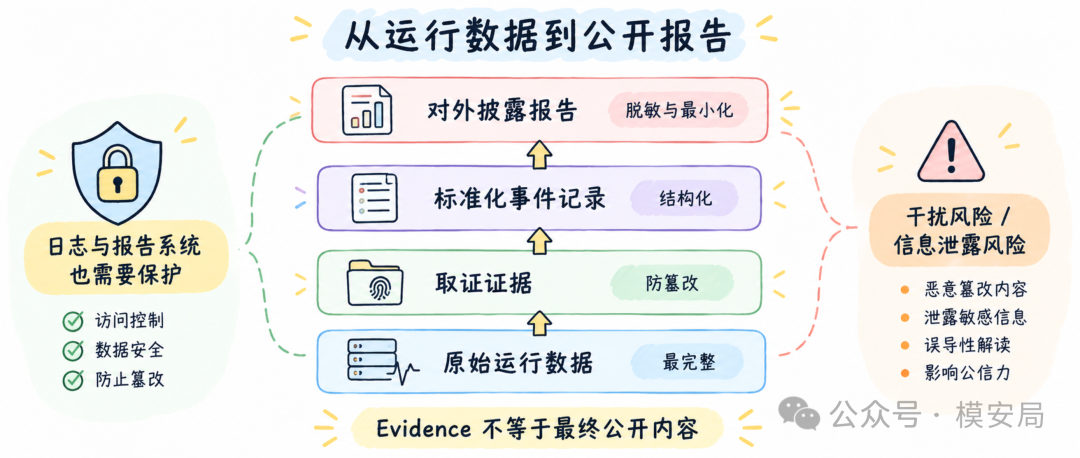
这还引出了另一个问题:记录得越完整,并不意味着公开得越完整。
Agent 的运行日志可能包含用户邮件、内部文件、长期记忆、工具参数、企业数据甚至知识产权。如果安全事故报告制度要求披露这些信息,攻击者甚至可能故意制造事故,以此迫使企业暴露内部信息。
因此论文明确区分了两个概念:
用于事故重建的 Evidence,与最终公开的 Incident Report,并不是同一件东西。
更合理的体系应该类似:
原始运行数据
↓
取证证据
↓
标准化事故记录
↓
对外披露报告
越靠近底层,信息可以越完整;越靠近公开披露层,就越需要数据最小化、匿名化和访问控制。
从“模型可观测性”走向“Agent 可观测性”
从表面看,这篇论文讨论的是“安全事故报告”。
但如果进一步看,它其实正在回答一个更基础的问题:
为了让一个 Agent 在出事以后能够被解释、审计和追责,我们在运行时究竟必须看见什么?
传统软件通常强调三类可观测性信息:
Logs、Metrics、Traces。
Agent 时代显然已经不够。
至少还需要进一步观察:
Context、Memory、State、Tool、Identity、Authority、Delegation、Agent Interaction。
这意味着 Agent Observability 不再只是一个运维问题,而正在成为安全基础设施。
只有知道 Agent 看到了什么、记住了什么、做了什么、以谁的身份做、谁授权它做,以及其他 Agent 如何参与其中,事故发生以后才有可能真正重建整条因果链。
局限性
需要注意的是,论文提出的仍然是一个初步报告方案,而不是已经完成的正式标准。
作者也列出了大量尚未解决的问题:
- 17 项信息中哪些应该强制记录、哪些应该可选
- 完整轨迹需要保存多久
- 怎样控制日志规模
- 如何记录不断变化的实际自治度
- 怎样处理非确定性 Agent 的事故复现
- 怎样证明日志没有被 Agent 或攻击者修改
- 以及怎样在取证价值、商业机密和个人隐私之间取得平衡
其中甚至有一些具体字段仍需要进一步工程化。
例如论文提出记录推理 Tokens,但现实中的模型未必会暴露完整内部推理过程;论文也提出追踪工具认证 Token,但实际系统显然不能简单把 Bearer Token 原文写进日志,更合理的做法是保存凭证标识、签发方、权限范围、使用主体和指纹等可追溯信息,而不是保存密钥本身。
因此,这套框架真正重要的价值,并不在于未来所有系统都机械地记录这 17 个字段,而在于它开始建立一种新的安全分析视角。
写在最后
过去分析大模型安全事故,我们习惯寻找那个“有问题的 Prompt”。
但 Agent 把问题变复杂了。
一个看似正常的用户请求,可能读取一份被改变的外部数据;这份数据影响 Agent 的后续决策;Agent 将信息写入长期记忆;另一个任务几天后重新读取它;随后任务被委托给另一个 Agent,并继承了用户权限;最终通过一个本身完全正常的工具完成了高风险操作。
其中任何一步单独拿出来,都可能没有明显问题。
真正的问题存在于这些步骤连接起来形成的执行轨迹中。
因此,Agent 安全正在发生一个越来越明显的变化:
安全分析对象正在从“模型说了什么”,转向“整个系统是怎样行动的”。
这也是这篇论文提出 3 大类、17 项关键要素背后真正重要的意义。
未来一套成熟的 Agent 安全体系,可能不仅需要 Guardrail 阻止危险行为,还需要在事故发生之后回答几个最基本的问题:
Agent 看到了什么,做了什么,以谁的身份做,谁授权了它,以及这一连串事情究竟是怎样发生的。
如果这些问题无法回答,那么即使系统留下了海量日志,我们可能仍然不知道 Agent 到底发生了什么。
同专题推荐
查看专题Agent 的长期记忆治理:ZoneClaw 的三层记忆分区与四角色安全架构
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
Persona Guardrail:Uber 如何为每个 Agent 打造专属风控策略
例如,企业内部有一个财务 Agent、一个人事 Agent 和一个差旅 Agent。它们可能使用相同的基础模型,甚至接入相同的工具平台,但职责完全不同。
可信 Agent 开发生命周期:六个阶段、五道安全门
过去,大模型安全更多关注模型“输出了什么”:是否产生有害内容、是否泄露敏感信息、是否受到越狱攻击。但在 Agent 系统中,风险的基本单位正在从一次模型输出,扩展为一整条行为轨迹。