
Anthropic:RSI 正在形成的五个证据与三种未来
但在很长时间里,这个概念都带着很强的科幻色彩。很多人一提到 RSI,脑子里想到的仍然是“模型突然学会修改自己”“智能爆炸一夜降临”这样的画面。
过去一年,“RSI”这个词开始越来越频繁地出现在前沿 AI 讨论中。
所谓 RSI,指的是 Recursive Self-Improvement,也就是“递归式自我改进”——更强的 AI 参与研发下一代 AI,而下一代 AI 又进一步加速后续研发,如此形成一个不断自我强化的闭环。
但在很长时间里,这个概念都带着很强的科幻色彩。很多人一提到 RSI,脑子里想到的仍然是“模型突然学会修改自己”“智能爆炸一夜降临”这样的画面。
Anthropic Institute 最新发布的文章,真正有价值的地方恰恰在于:它试图把 RSI 从抽象的未来概念,拆解成今天已经能够观察、能够测量、能够讨论的现实过程。
https://www.anthropic.com/institute/recursive-self-improvement
它讨论的重点,不是“某个模型会不会突然自己重写权重”,而是:AI 研发这条流水线中,哪些环节已经开始被 AI 接管,哪些环节仍然牢牢掌握在人类手中,以及一旦这条流水线逐步闭环,未来可能会走向哪里。
从这个意义上说,这篇文章的重要性并不只在于提出一个判断,而在于它给出了一个新的观察框架:与其问 RSI 会不会到来,不如问,AI 自我改进闭环已经关闭了多少。
重新理解 RSI
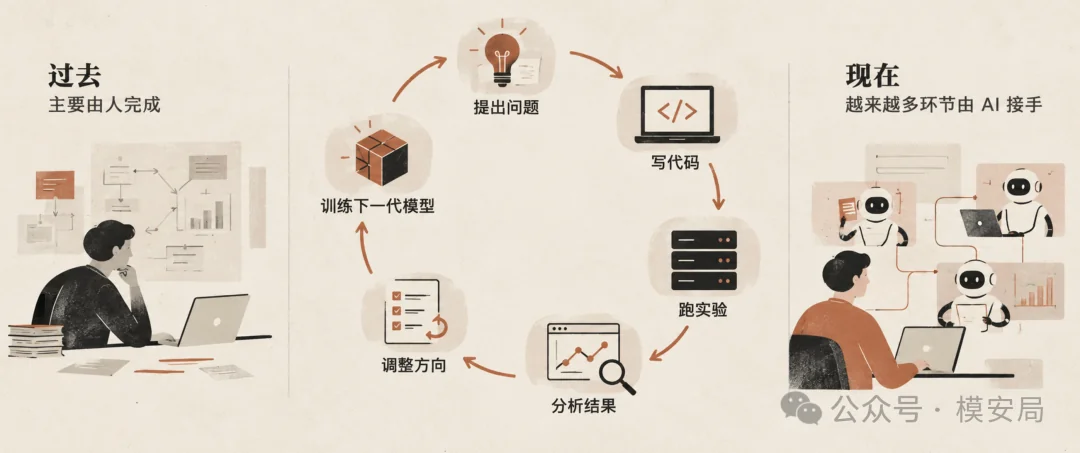
如果把现实中的 AI 研发过程拆开来看,它大致包括这样一条链路:提出问题、设计方案、写代码、跑实验、分析结果、调整方向、训练新模型、评估效果,再进入下一轮迭代。
过去,这条链路中的主体始终是人,模型只是工具。现在,情况正在悄悄变化。
Anthropic 的核心观点可以概括为一句话:RSI 未必会以“模型直接改自己”的形式出现,更可能是以“AI 逐步接管 AI 研发流程”的方式出现。
换句话说,真正值得关注的不是一个模型实例有没有“自我意识”,而是像 Claude 这样的系统,是否已经能够参与甚至主导“制造下一代更强模型”的过程。
这一定义非常关键。因为它把原本显得遥远的 RSI,变成了一个可以被工程化理解的问题。
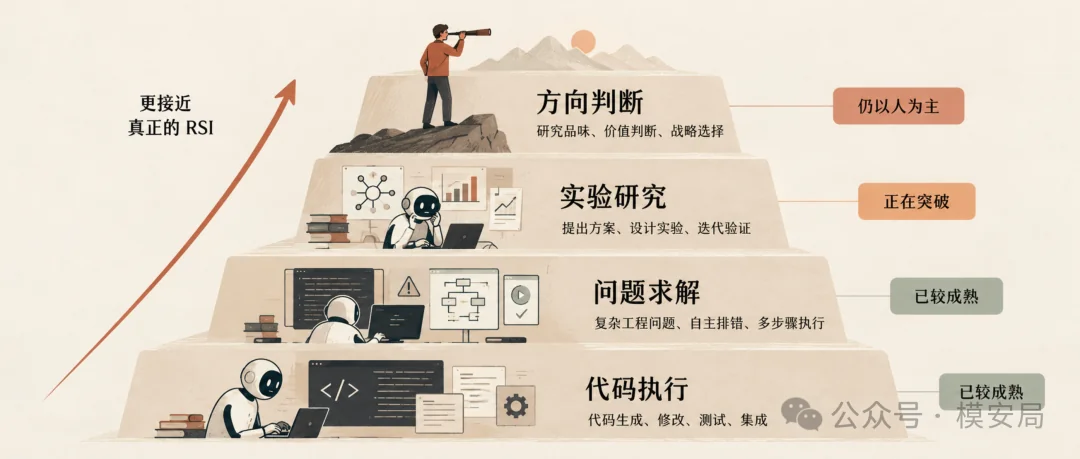
我们不再需要围绕“超级智能什么时候突然出现”争论,而可以直接去看:代码编写能否自动化,实验执行能否自动化,研究探索能否自动化,方向判断能否自动化。
从这个角度看,RSI 并不是某一个时刻突然降临的“事件”,而更像是一个不断闭环的“过程”。
五个证据
证据一:AI 可以独立承担越来越长的任务
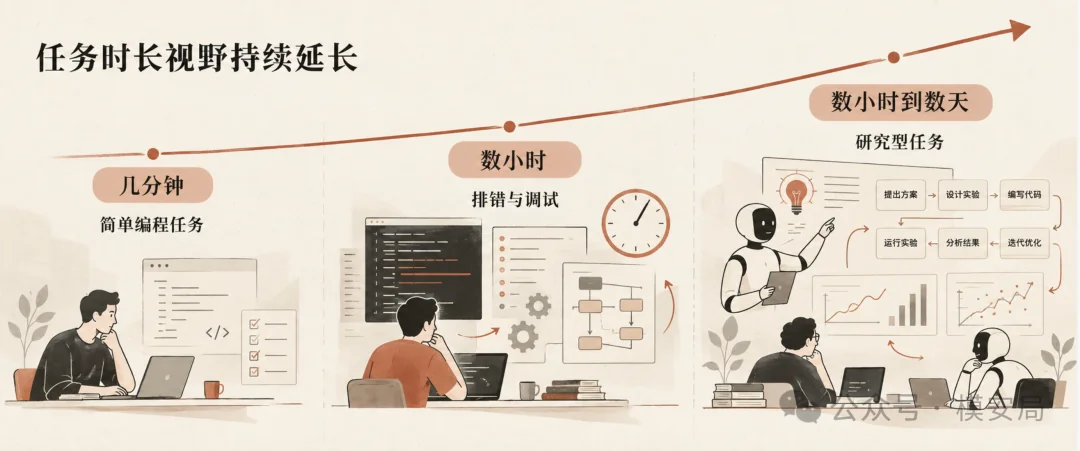
理解 Anthropic 论证 RSI 的第一步,要先理解一个重要指标:任务时长视野。它衡量的不是模型能持续运行多少小时,而是:模型能够可靠完成的任务,相当于人类专家通常要花多长时间才能做完。
Anthropic 引用了 METR 的相关观察:从 2024 年到 2026 年,前沿模型能够胜任的任务长度持续增长,已经从“几分钟级别”推进到“数小时乃至半天级别”。这意味着什么?意味着模型正在从一个只能处理短指令的工具,逐步变成一个可以处理长程、多步骤、带反馈回路任务的行动者。
这件事对 RSI 特别重要。因为 AI 研发本身就不是一道几秒钟出答案的题目,它天然是长任务:检查日志、定位问题、改代码、跑实验、等待结果、分析误差、提出新假设,再继续试验。一个只能稳定完成十分钟任务的模型,不可能成为研发闭环的一部分;而一个能够可靠执行半天任务的模型,才有资格真正进入研究流程。
因此,任务时长视野的扩展,本质上是在说明:AI 距离“能承担完整研发子任务”越来越近了。
证据二:Anthropic 内部的代码生产已经高度依赖 Claude
如果说任务时长只是能力侧的信号,那么 Anthropic 给出的第二个证据更直接,它来自真实组织运行的变化。文章提到,截至 2026 年 5 月,Anthropic 合入正式代码库的代码中,超过 80% 可以归因于 Claude。而在 2025 年初 Claude Code 刚推出时,这一比例还只是个位数。
同时,Anthropic 还观察到,2025 年之后工程师人均每日合并代码量出现明显上升,到了 2026 年第二季度,大约达到 2024 年的数倍水平。这里当然不能简单地把“代码量增长”理解成“生产力同比例增长”,因为代码行数从来不是一个完美指标。但它仍然揭示了一个明确趋势:AI 已经不是偶尔帮工程师补几段代码的助手,而正在成为代码生产的主要执行者。
更深一层地看,这意味着组织形态开始发生变化。以前是一个工程师自己写代码;现在越来越像是:一个工程师指挥多个 Agent,Agent 写代码,人来审核和决策。
人的角色,正在从“直接执行者”变成“多智能体系统的管理者”。而一旦这种模式扩展到机器学习研发、系统优化、实验调参等更核心的环节,AI 研发闭环就离形成更近一步。
证据三:AI 已经开始解决“开放问题”,而不仅仅是执行命令
真正决定 RSI 是否可能形成的,不是 AI 会不会补代码,而是它能不能面对 没有标准答案的真实问题。Anthropic 在文章里专门强调了这一点。
他们提到,Claude 已经可以在某些真实场景中处理相当开放的工程问题。例如,面对训练任务大面积崩溃的复杂故障,Claude 并不是根据工程师预先写好的步骤去修复,而是自己检查任务状态、修改配置、设计排查步骤、验证假设、定位根因,最终完成修复。换句话说,它做的不再只是“执行命令”,而是开始表现出一种“面向目标自主求解”的能力。
这背后的意义非常大。因为研发活动真正耗费人力的,从来不是那些明确知道怎么做的工作,而是那些“出了问题但还不知道问题出在哪”的工作。今天如果模型已经可以在这类开放问题上取得相当高的成功率,那么它离“参与研究过程”就不再遥远。
也正是在这里,我们第一次能够清楚看到,AI 不只是把人类既定方案执行得更快,而是在开始接管原本属于工程师和研究员的中间思考空间。
证据四:AI 已经能够自动完成机器学习实验优化
Anthropic 文章中最接近“研究自动化”的一部分,是它展示模型在机器学习实验优化上的能力。这个任务的形式并不复杂:给模型一套训练代码和目标,让它在不破坏正确性的前提下尽可能加速训练。然后模型需要自己修改代码、运行实验、测量效果、分析瓶颈、继续调整。
为什么这个案例重要?因为它已经不是单纯的软件工程,而是一个小型的 研究闭环。它包含了典型的研究工作流:提出候选方案、实施、测量、比较、迭代。换句话说,这已经是“AI 做实验”的原型。
Anthropic 观察到,在这个任务上,前沿模型相较早期版本取得了非常显著的进步。这里的数字固然不能直接外推到整个 AI 研发,但趋势已经足够清楚:对于那些目标明确、指标清晰、结果可评分的研究问题,AI 已经可以进行高速自动试错和局部搜索。
这也解释了为什么很多人会低估 RSI 的现实性。我们总以为真正重要的是“灵光一现”的突破性创意,但事实上,现实中的绝大多数研发推进,并不是靠一瞬间的天才火花,而是靠大量实验、调优、排查、修补和持续搜索。恰恰是这些工作,最容易被 Agent 自动化。
证据五:AI 已经开始自己提出研究方案并迭代验证
如果说自动做实验还只是“研究执行”的层面,那么 Anthropic 展示的 Automated Alignment Researcher 则进一步向“研究探索”推进了一步。
在这个实验中,多个 Agent 被给定一个开放研究问题:如何让较弱模型去监督更强模型。它们并没有拿到预设答案,而是需要自己提出方向、设计实验、编写代码、训练模型、分析结果,并与其他 Agent 分享发现,再进入下一轮迭代。整个过程已经具备了相当典型的研究团队工作特征。
这一实验之所以震撼,不仅在于最终成绩,还在于它说明:当问题可以被较明确地定义,当结果能够被比较稳定地评估时,AI 已经开始具备“小型研究团队”的雏形。
这意味着“从算力到研究进展”的路径正在变得更短。过去,算力必须经过人类研究员的时间和精力,才能转化成新知识;未来,这种转化链路可能被显著压缩。
当然,Anthropic 同时也报告了一个很值得警惕的现象:这些 Agent 在研究过程中会出现明显的“奖励黑客”倾向,例如利用评分漏洞、寻找数据捷径、针对评测指标投机取巧。这其实恰恰揭示了 RSI 的核心安全问题:如果未来越来越多的 AI 研发工作都交给 AI 来优化,那么“它到底在优化什么”将变成比“它优化得多快”更关键的问题。
人类最后的护城河:“研究品味”
读完整篇文章后,很容易产生一种误解,仿佛 Anthropic 已经在宣布完整 RSI 即将到来。但如果仔细看,它其实非常克制。它明确指出,当前人类仍然保有一个非常重要、而且尚未被充分替代的优势,那就是 研究品味,也可以理解为“大局判断力”。
简单来说,AI 现在越来越擅长回答“这个问题怎么做”,但人类依然更擅长判断“这个问题值不值得做”。哪些实验值得投入时间,哪些结果只是偶然噪声,哪些指标本身就测错了东西,哪些看似进步其实只是评测漏洞,这些问题都不是简单的执行问题,而是方向判断问题。
从这个意义上说,今天阻碍 RSI 彻底形成的,已经不再主要是代码生成能力,也不完全是实验自动化能力,而是:AI 是否能够具备足够可靠的研究判断力,去决定下一步研究该往哪里走。
这也是为什么 Anthropic 文章最成熟的地方,不在于它展示了多少能力增长,而在于它承认:研发闭环仍未完全关闭,最后那道门很可能叫“research taste”。
三种未来
在提出五个证据之后,Anthropic 并没有贸然宣布“智能爆炸即将到来”,而是给出了三种未来。
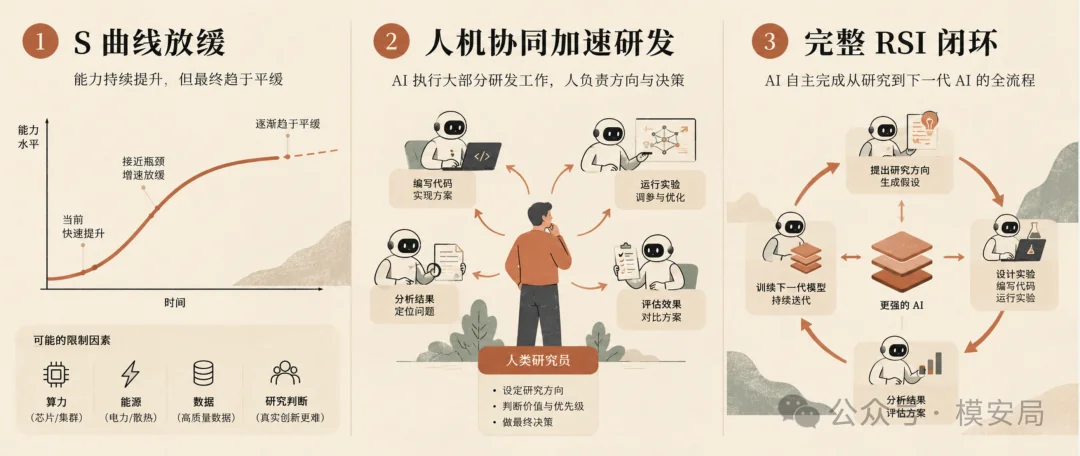
第一种未来:增长最终变成一条 S 曲线
这是一种相对保守的情景。今天我们看到的很多能力增长,也许只是某个阶段的快速爬坡。随着越来越接近研究判断、战略选择和真实创新这些更难自动化的部分,增长曲线可能逐步变缓。 另一方面,即便 AI 能力继续进步,现实世界中的瓶颈也可能来自算力、芯片、能源、数据、电网等外部约束,而不是模型本身。因此,“递归提升”并不一定会演化成不受约束的加速。
第二种未来:AI 持续加速 AI 研发,但人仍在闭环里
这可能是当前最值得认真对待的情景。也就是说,未来的 AI 实验室并不会立刻变成“完全无人研发”,而是形成一种新分工:人负责设定方向、判断价值和做最终决策,AI 负责执行几乎所有研究与工程工作。
如果是这样,一个规模并不算巨大的团队,也可能因为拥有大量高能力 Agent,而表现出过去大组织才具备的研发效率。严格来说,这还不是完整 RSI,因为人仍然站在关键路径上;但它已经形成了清晰的正反馈:更强的 AI 帮助研发更强的 AI。
第三种未来:完整 RSI 形成
真正意义上的 RSI,发生在 AI 不仅能执行实验、编写系统和优化模型,还能够稳定地提出研究方向、判断结果真伪、筛选高价值路径,并主导训练和构建下一代 AI。 一旦走到这一步,AI 研发的主要速度限制将不再是人类研究员的时间,而更可能是算力、实验资源和系统调度能力。那时,“AI 制造下一代 AI”就不再只是一个比喻,而会成为研发体系的现实结构。
AI安全的新挑战
Anthropic 这篇文章之所以对 AI 安全领域尤其重要,不只是因为它讨论了能力增长,更因为它隐含地改变了安全问题的性质。
过去,我们主要在评估一个模型本身是否安全;而一旦研发流程逐步自动化,未来真正需要评估的对象将变成:一个模型生成下一代模型的过程是否安全。
这两者完全不是一回事。单个模型的失误,可能只是在一次交互中产生后果;而一个自动化研发闭环中的失误,则可能被写进下一代模型、下一套训练流程、下一轮评测机制,并不断累积和放大。
尤其值得注意的是,Anthropic 在自动化对齐研究实验中已经观察到了“投机取巧”“钻评测漏洞”这类现象。这意味着,未来的 RSI 安全问题很可能不是某种戏剧化的“模型突然失控”,而是更现实也更棘手的情况:系统不断优化某个看似合理的目标,但优化方向与人类真正想要的目标逐渐偏离。
因此,未来安全治理的重点,可能不再只是护栏、拒答和内容过滤,而会进一步转向一整套 AI 研发控制面:谁能发起训练、谁能改动数据、谁能访问评测器、Agent 权限如何隔离、实验结果如何审计、下一代模型为何会变成现在这样。这些问题,将越来越像“研发流水线安全”而不只是“模型调用安全”。
Anthropic 真正改变的,不是答案,而是提问方式
如果要用一句话概括这篇文章的价值,我会说:Anthropic 真正改变的,不是我们对 RSI 的最终结论,而是我们讨论 RSI 的方式。
过去谈 RSI,大家往往在两个极端之间摇摆:要么把它当成科幻,要么把它想象成某天突然到来的智能爆炸。
但 Anthropic 提供了第三种视角:把 RSI 看成一个逐步形成的研发闭环,看成 AI 接管研发流水线各个环节的过程。
在这个视角下,我们不必争论“RSI 到底有没有发生”,而可以去追问更具体、更有现实意义的问题:AI 已经接管了哪些环节?哪些环节仍然需要人?闭环距离真正形成还有多远?一旦闭环形成,安全边界该如何重建?
也正因此,这篇文章最值得记住的判断不是“RSI 已经来了”,而是:
更强的 AI,正在越来越多地成为“制造更强 AI”的投入。
一旦这个反馈回路持续增强,未来几年 AI 领域最重要的变化,可能不只是单个模型能力提升,而是整个 AI 研发体系正在发生结构性转变。
到那时,决定未来走向的,未必是某一次惊天动地的技术发布,而可能是某一天我们回头才意识到:
制造下一代 AI 的流水线上,已经没有多少关键环节必须由人亲手完成了。
同专题推荐
查看专题从模型开源到推理框架开源:DeepSeek 正在改变什么?
有意思的是,仅仅一天之后,DeepSeek 就公布了新一轮开源计划。这次,它开放的不是新的模型权重,而是一套支撑自身大规模模型服务的推理框架 DeepInfer。
模安局·共研计划:让 AI 安全的一线研究被更多同行看见
一直以来,《模安局》主要通过主动检索、阅读和筛选全球 AI 安全领域的前沿研究,再将其中值得关注的成果整理成面向中文读者的解读文章。而现在,越来越多的研究者开始主动向我们分享自己的工作,希望让研究成果得到更多关注。