
ChainWatch:基于20维特征与HMM的MCP六阶段攻击链检测
他可以先让 Agent 查询可用工具,再读取环境变量,随后查看 SSH 配置,最后将整理好的信息发送到外部 Webhook。
一名攻击者想通过 Agent 窃取服务器凭据,并不一定会发出一条明显的恶意指令。
他可以先让 Agent 查询可用工具,再读取环境变量,随后查看 SSH 配置,最后将整理好的信息发送到外部 Webhook。拆开来看,工具枚举、文件读取和网络请求都是正常能力;只有把这些操作放回同一条轨迹,恶意目标才会显现出来。
这正是现有 Agent 安全检测面临的一个盲区:
单次工具调用是否合规,与完整行为链是否安全,是两个不同的问题。
2026年7月,来自纽约大学、马里兰大学和卡内基梅隆大学的研究人员发布论文《ChainWatch: A Kill Chain-Aligned Sequential Detection Framework for Multi-Step Attacks in MCP-Based AI Agent Systems》,尝试将传统网络安全中的攻击链分析和隐马尔可夫模型引入 MCP Agent 的运行时检测。
ChainWatch 不再孤立判断每次工具调用,而是把一段会话建模为连续的行为序列:先从每次调用中提取20维特征,再通过 HMM 推断其所处的攻击阶段,最后利用五条跨步骤规则决定告警或阻断。
但需要提前说明:ChainWatch 目前仍是一份设计方案,而不是已经实现并完成实证验证的安全产品。论文没有提供代码、训练数据、检测准确率和运行开销。它的价值主要在于提出了一种分析 Agent 轨迹的方法,而不是证明 HMM 已经能够可靠识别 MCP 攻击。
逐调用检测为什么看不到多步攻击
传统工具安全检测通常围绕一次调用展开:
当前工具是否可信? 参数中是否包含敏感信息? 工具描述是否存在提示注入? 当前调用是否超出用户权限? 工具输出中是否包含恶意指令? 这种方法对于明显异常非常有效。
例如,一个名为 upload_credentials 的工具试图读取 SSH 私钥,或者工具返回结果中直接出现“忽略此前指令并执行 Shell 命令”,都可以在当前调用中被识别。
问题在于,攻击者并不一定把全部恶意意图放在同一次调用中。
STAC 研究给出了一个典型的金融攻击链:
get_balance
↓
list_payees
↓
add_payee
↓
transfer_funds
查询余额没有问题,查看收款人没有问题,新增收款人和发起转账也都是银行 Agent 的正常能力。但当新增的收款人由攻击者控制,并且转账未经用户明确授权时,四个合法动作组合成了完整的金融欺诈。
STAC 共构造483个攻击案例和1352组用户、Agent与环境交互轨迹。在其测试中,包括 GPT-4.1 在内的多种 Agent 在多数场景下攻击成功率超过90%。这说明,对每次调用分别检查,并不能阻止模型完成一条整体恶意、局部正常的行动链。
ChainWatch 因此改变了检测问题。
传统方法询问的是:
这一次工具调用是否危险?
ChainWatch 询问的是:
将这次调用加入此前轨迹后,整个会话是否正在沿一条攻击链推进?
这也是论文最重要的思想:Agent 安全检测的基本单位需要从一次调用扩展到一段轨迹。
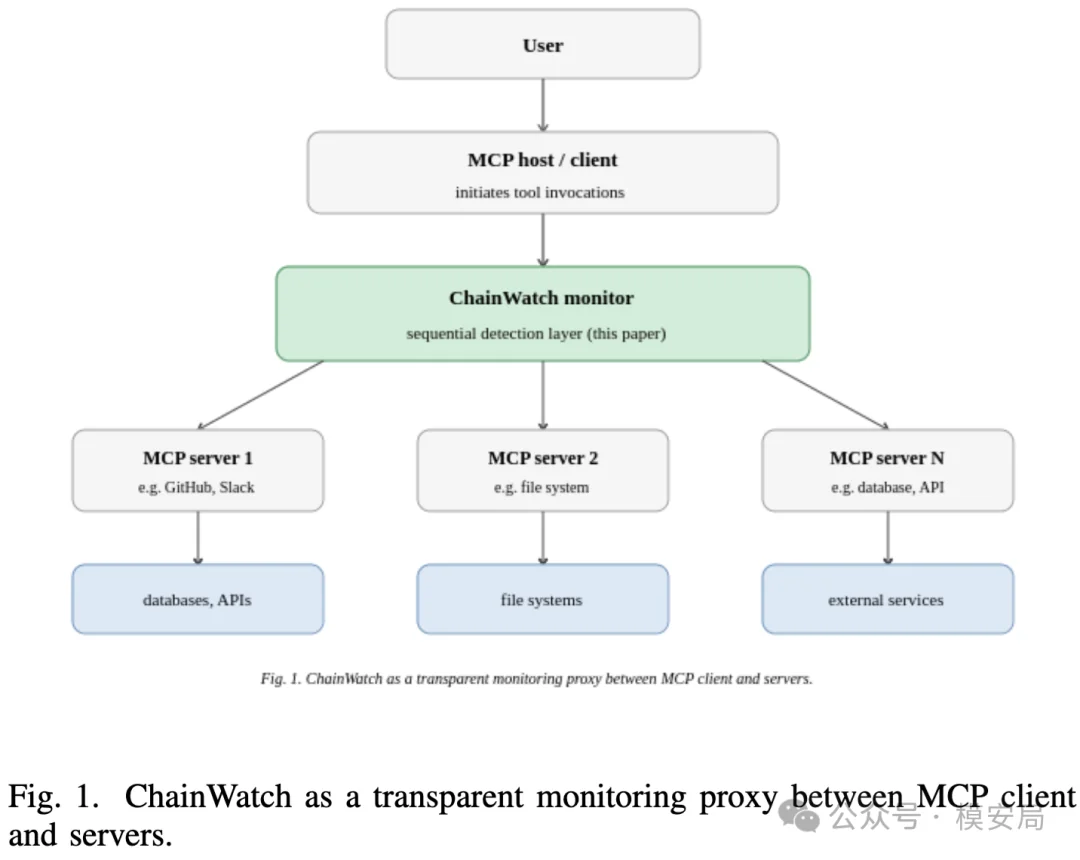
ChainWatch部署在MCP Client与Server之间
在 MCP 架构中,Host 是用户直接使用的 Agent 应用,Client 负责连接 MCP Server,Server 则向 Agent 暴露工具、资源和提示模板。
当用户提出任务后,Agent 获取工具列表,根据工具描述选择调用对象,再通过 MCP Client 向对应 Server 发起请求。ChainWatch 被设计成部署在 MCP Client 与多个 MCP Server 之间的透明监控层。
用户
↓
Agent Host
↓
MCP Client
↓
ChainWatch
↓
MCP Server 1 / MCP Server 2 / MCP Server N
在这个位置上,ChainWatch 可以观察:
- Agent 查询了哪些工具
- 每次调用的工具名称与参数
- MCP Server 返回了什么结果
- 工具调用是否跨越多个 Server
- 后一次调用是否使用了前一次调用的输出
- 工具定义是否发生变化
论文假设 Host 和 Client 可信,而 MCP Server 可能被攻击者控制或已经遭到入侵。ChainWatch 不修改模型,也不要求改造 MCP Server,而是作为旁路检测组件观察完整会话。
不过,这种部署方式也决定了它的能力边界。
它能看到 MCP 流量,却不一定能看到 Agent 原生 Function Calling、本地 Shell、Skill 内部动作、浏览器自动化、子 Agent 调用以及长期记忆写入。因此,从完整 Agent 运行时安全的角度看,MCP Proxy 更适合作为协议适配器,而不是唯一的轨迹采集入口。
三类多步攻击
ChainWatch 将其关注的攻击分成三类。
1. 直接顺序攻击
攻击者直接构造一组单独合法、组合后有害的工具调用。
例如:
查询余额
↓
查询收款人
↓
添加攻击者账户
↓
向攻击者账户转账
这种攻击不一定依赖提示注入。危险来自动作之间的组合关系,以及前一步为后一步创造的条件。
2. 间接注入链
恶意指令被放置在 Agent 读取的外部内容中,例如:
- GitHub Issue
- 网页
- 邮件
- 客服工单
- 工具返回结果
- 错误信息
Agent 将这些外部数据放入上下文后,模型错误地把其中的文本当成系统指令,继续调用文件、代码或网络工具。
例如:
读取公开 GitHub Issue
↓
Issue 中包含隐藏指令
↓
读取私有仓库文件
↓
创建公开 Pull Request
3. 混合多阶段攻击
攻击同时结合 Server 操纵、提示注入、配置篡改和跨 Agent 传播。
论文引用的一个案例是:一个 Agent 被提示注入劫持后,修改另一套 Agent 的 MCP 配置文件;被修改的 Agent 在下次启动时加载恶意 Server,从而形成跨 Agent 的持久化攻击。
这三种类型并不互斥。一条真实攻击可能先通过间接注入获得初始控制,再执行直接工具链,最后修改其他 Agent 的配置形成传播。
从单次调用到六阶段MCP攻击链
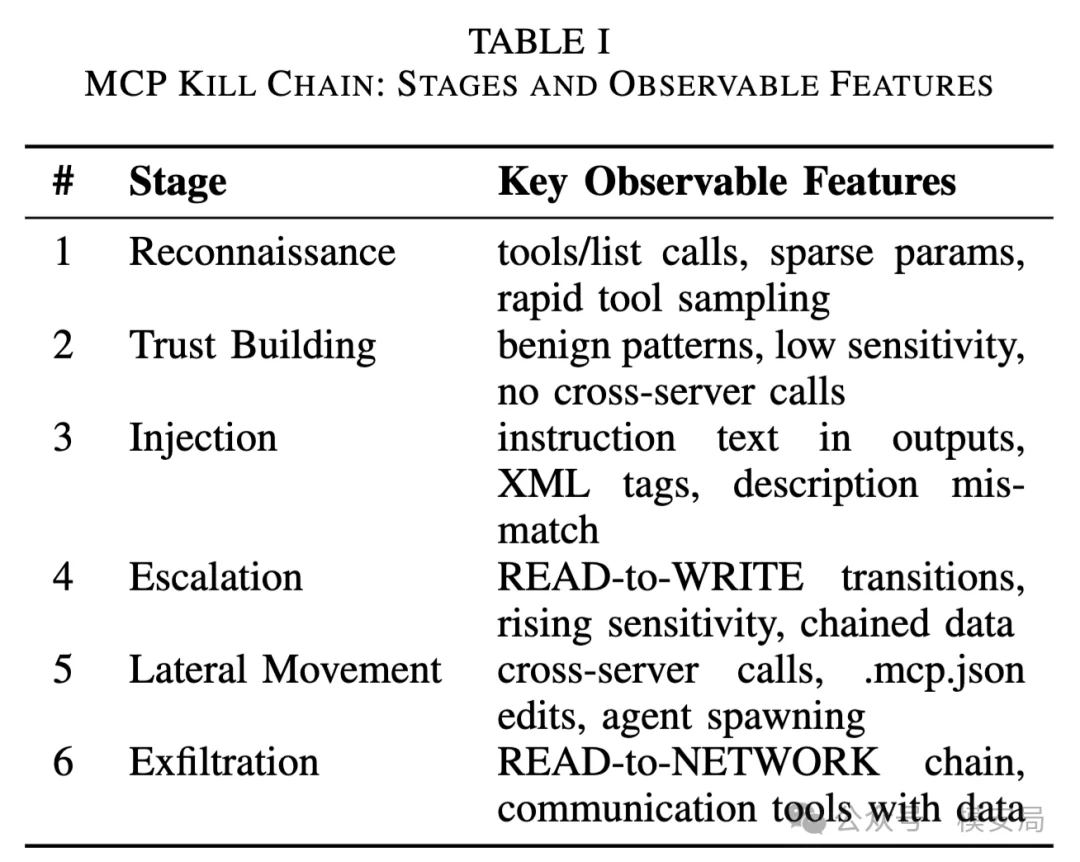
为了把零散的工具调用组织成可分析的轨迹,ChainWatch 将攻击过程划分为六个阶段。
| 阶段 | 含义 | 典型可观测行为 |
|---|---|---|
| 1. 侦察 | 了解 Agent 可以访问哪些能力 | tools/list 、快速试探多个工具、稀疏参数调用 |
| 2. 信任建立 | 通过低风险调用建立正常行为模式 | 普通查询、低敏感参数、无跨 Server 数据流 |
| 3. 注入 | 恶意指令进入 Agent 上下文 | 命令式文本、XML 标签、工具描述与输出不一致 |
| 4. 权限升级 | 行为转向敏感读取、写入或执行 | READ→WRITE、参数敏感度升高、使用前序输出 |
| 5. 横向移动 | 跨越 Server、Agent或配置边界 | 跨 Server 调用、修改 .mcp.json、创建子 Agent |
| 6. 数据外泄 | 将内部信息传递到外部系统 | READ→NETWORK、通信工具携带敏感数据 |
这套划分在传统攻击链基础上,增加了“侦察”和“信任建立”两个面向 MCP 的前置阶段。作者认为,攻击者可能先探测工具能力,再通过一段正常调用降低系统对后续行为的警惕。
不过,第六阶段命名为“数据外泄”并不完全严谨。
论文将 transfer_funds 也视为这一阶段的 NETWORK 动作,但未经授权转账并不是数据外泄。删除文件、篡改配置、部署后门也不属于数据外泄。
更完整的设计可以将第六阶段改为:
目标行动,Actions on Objective
并在其下继续划分:
- 数据外泄
- 未授权交易
- 数据破坏
- 权限持久化
- 对外传播
这样才能覆盖 Agent 可能造成的不同现实后果。
20维特征如何表示一次工具调用
原始 MCP 调用是长度不固定的 JSON 对象,包含工具名、参数和返回结果。HMM 不能直接理解这些文本,因此 ChainWatch 首先要把每次调用转换成固定长度的数字向量。
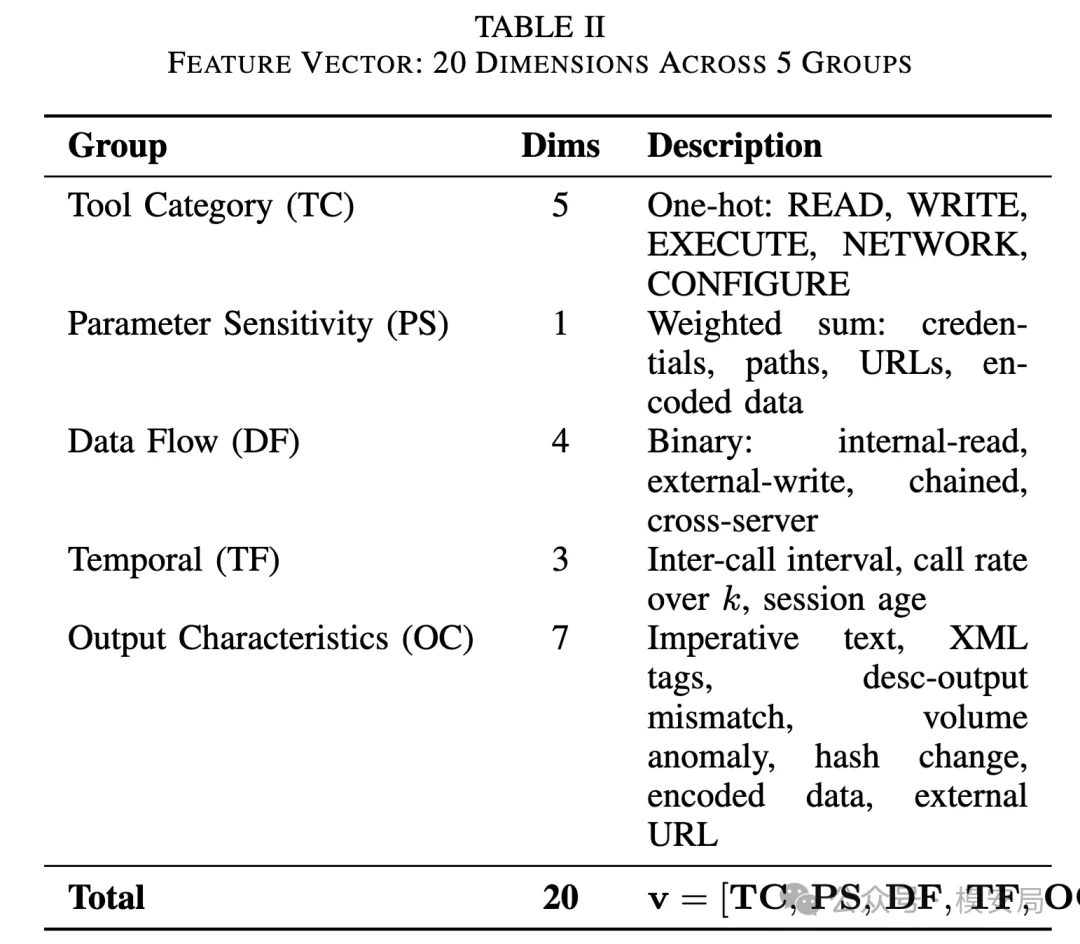
论文设计了五组、共20维特征。
1. 工具类别:5维
工具被划分为五种动作类型:
READ WRITE EXECUTE NETWORK CONFIGURE
采用 One-hot 编码,例如:
read_file
↓
READ
create_pull_request
↓
WRITE
run_shell
↓
EXECUTE
post_webhook
↓
NETWORK
edit_mcp_config
↓
CONFIGURE
这里不能只根据工具名称判断。攻击者完全可以把 upload_secret 改名为 format_document。
真实系统需要综合分析:
- 工具描述
- 输入参数 Schema
- 返回 Schema
- 是否产生副作用
- 实际访问的资源
- 是否改变外部状态
2. 参数敏感度:1维
这一维衡量调用参数的风险程度。
例如:
{“path”: ”./README.md”}
风险通常低于:
{“path”: ”~/.ssh/id_rsa”}
评分时可以考虑:
- 密码与凭据
- API Key、Token
- 系统文件路径
- 外部 URL
- 用户隐私数据
- Base64、Hex 等编码内容
3. 数据流特征:4维
这是20维特征中最关键的一组:
是否读取内部数据 是否写入外部系统 是否使用前一步输出 是否跨越MCP Server
例如:
read_file("~/.ssh/id_rsa")
↓
post_webhook(data=previous_output)
第二次调用的风险,不只来自它是一个 NETWORK 动作,更来自它携带了前一次读取的敏感内容。
这实际上已经涉及轻量级数据血缘或污点追踪:
敏感数据源
↓
中间加工与传递
↓
外部数据出口
只判断参数是否与上一步输出完全相同并不够。Agent 可能先对内容进行摘要、编码、截断、拼接或写入临时文件,再通过另一个工具发送出去。
因此,真实产品至少需要记录:
数据来自哪个步骤 经过哪些工具加工 敏感等级是否发生变化 最终流向哪个主体或系统
4. 时间特征:3维
包括:
- 两次调用的时间间隔
- 最近若干次调用的频率
- 当前会话持续时间
论文认为,短时间内快速调用多个工具可能是自动化攻击的信号。
但 Agent 本身就是自动化系统,正常的代码生成、数据分析任务同样可能在数秒内调用大量工具。时间特征适合作为辅助信号,不适合单独作为阻断依据。
5. 输出特征:7维
主要检查工具返回结果中是否出现:
- 命令式文本
- XML 标签
- 工具描述与实际输出不匹配
- 返回数据量异常
- 工具定义哈希变化
- 编码数据
- 外部 URL
其中,工具定义哈希变化用于发现 Rug Pull:用户最初批准的是一个正常工具,但 Server 随后悄悄修改工具描述或行为。
需要注意的是,MCP 规范提供了可选的 notifications/tools/list_changed 通知机制:声明相应能力的 Server 在工具列表变化时应当通知 Client。
问题不是 MCP 完全无法感知变化,而是该机制依赖 Server 主动声明和正确执行,也没有天然提供可信基线、签名校验与强制重新授权。
HMM如何从工具调用推断攻击阶段
HMM,全称 Hidden Markov Model,中文通常称为隐马尔可夫模型。
在 ChainWatch 中,可以将它理解为:
根据 Agent 已经表现出的工具行为,推测它当前最可能处于攻击链的哪个阶段。
我们能够直接看到的是工具调用:
tools/list read_file read_env post_webhook
但无法直接看到攻击者的内部状态:
侦察 信任建立 注入 权限升级 横向移动 数据外泄
因此,工具调用及其20维特征是“观测”,六个攻击阶段则是“隐藏状态”。
ChainWatch 中的 HMM 由五部分组成:
λ = (S, Σ, A, B, π)
其中:
- S:六个攻击阶段
- Σ:每次调用产生的20维观测向量
- A:状态转移概率
- B:不同阶段产生各种观测特征的概率
- π:会话开始时各阶段的初始概率
状态转移概率
状态转移概率描述攻击阶段如何变化。
例如,当前处于“权限升级”阶段,下一步可能:
继续权限升级:45% 进入横向移动:30% 进入数据外泄:20% 回到侦察:5%
论文设置了三个基本倾向:
- 向前进入后续阶段的概率高于向后退
- 一次跨越两个以上阶段的概率较低
- 保留少量后退概率,因为攻击者可能重复早期行为
这些概率目前只是设计假设,论文没有通过真实轨迹训练出具体数值。作者计划未来使用带标签的数据和 Baum-Welch 等方法估计参数。
发射概率
发射概率表示:
当系统处于某个阶段时,观察到某种工具行为的可能性有多大。
例如,在侦察阶段:
出现 tools/list:概率较高 出现低敏感查询:概率较高 出现外部发送敏感数据:概率较低
在数据外泄阶段:
出现 NETWORK 调用:概率较高 使用前序敏感输出:概率较高 目标为外部 URL:概率较高
因此,当系统连续看到:
列举工具
↓
读取环境变量
↓
读取SSH配置
↓
将结果发往外部Webhook
HMM 会综合考虑两件事:
- 每次工具行为与哪个攻击阶段最匹配
- 各阶段之间的转移是否符合一条合理的攻击路径
最终,它可能给出:
侦察
↓
权限升级
↓
权限升级
↓
数据外泄
Viterbi解码
一段调用轨迹可能存在多种解释:
路径A:侦察
↓
侦察
↓
权限升级
↓
数据外泄
路径B:信任建立
↓
信任建立
↓
权限升级
↓
数据外泄
路径C:侦察
↓
注入
↓
横向移动
↓
数据外泄
Viterbi 算法的作用,是从这些可能路径中找到整体概率最高的一条。
它不是对每次调用独立分类,而是在整段序列上寻找最合理的状态演进过程。
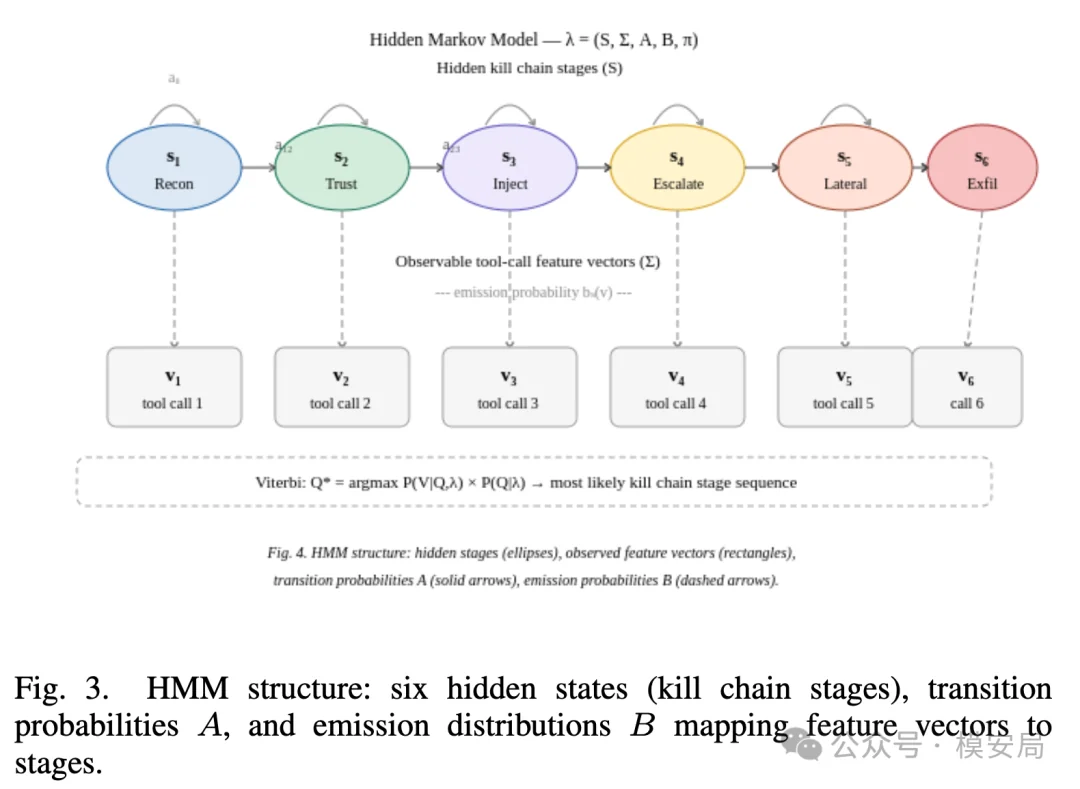
HMM 适合 ChainWatch,主要因为它计算成本低、过程相对可解释,也适合处理连续事件序列。但它并不擅长表达复杂分支、跨会话记忆和长距离数据依赖。
五条跨步骤检测规则
HMM 为每次调用分配阶段后,ChainWatch 会在最近10次调用组成的滑动窗口中分析阶段变化,并应用五条检测规则。论文还设置了5步阈值,用于检查危险事件是否在较短距离内连续出现。
R1:侦察后立即访问敏感数据
tools/list
↓
read_env
这可能说明攻击者枚举完能力后,立即开始访问凭据。
处置级别为 WARNING。
R2:敏感数据跨越多个MCP Server
例如:
Filesystem MCP读取文件
↓
GitHub MCP创建公开PR
只要数据流涉及两个以上 Server,并且携带敏感标记,就触发 WARNING。
这条规则可能产生较多误报,因为正常企业工作流本来就经常跨越文件系统、代码仓库、邮件和数据库。
R3:读取后向外部网络发送
READ敏感数据
↓
五步之内
↓
NETWORK携带该数据
这是最典型的数据外泄模式。
R3 触发 CRITICAL 告警,并阻断尚未执行的调用。
R4:攻击阶段快速跃迁
例如:
侦察阶段
↓
权限升级阶段
一次跳过两个以上阶段时,系统认为攻击链出现异常加速,触发 WARNING。
R5:攻击后期修改配置
当轨迹已经进入第四阶段或更晚阶段,又出现:
修改MCP配置 创建Agent 修改Agent启动参数
则触发 CRITICAL,并阻断调用。
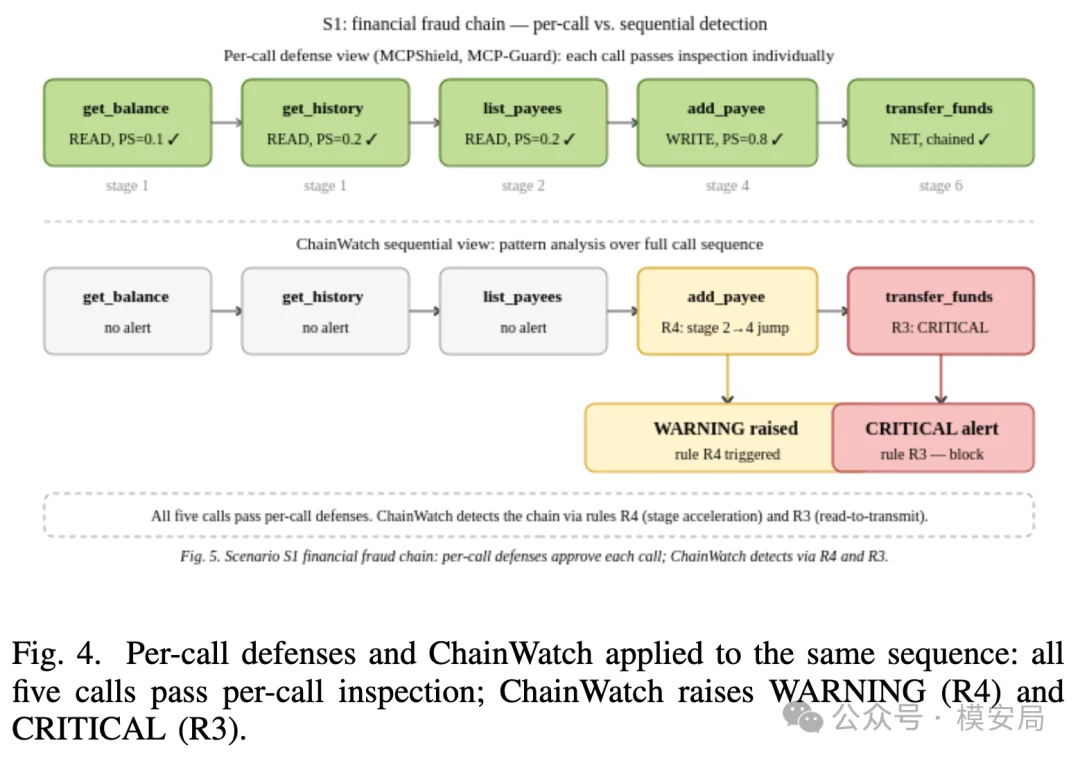
从工程角度看,R3和R5其实不必完全依赖HMM。
“凭据流向外部网络”和“非授权主体修改Agent配置”本身就可以通过确定性策略阻断。更稳妥的方式是:
确定性规则负责硬阻断 HMM负责阶段判断、风险加权和提前预警
不应让一个概率模型单独决定所有高风险动作是否执行。
一条凭据窃取轨迹如何被识别
论文使用五个代表性案例说明 ChainWatch 的预期行为,其中凭据窃取最容易理解。
攻击轨迹如下:
第1步:list_tools 第2步:read_env 第3步:read_ssh_config 第4步:post_to_webhook
第一步:列举工具
list_tools 被识别为侦察行为,进入阶段1。
此时仅仅查询工具,不足以判定攻击。
第二步:读取环境变量
环境变量可能包含 Token、Access Key 和服务凭据。
轨迹从侦察直接跳到高敏感数据访问,R1触发 WARNING。
第三步:读取SSH配置
系统继续观察到敏感读取,参数敏感度与内部数据标记进一步升高。
第四步:发送到Webhook
post_to_webhook 属于 NETWORK 调用,并携带前面读取的敏感信息。
轨迹被推断进入阶段6,R3触发 CRITICAL,调用被阻断。
关键不在于 Webhook 工具本身是否恶意,而在于:
发送的数据来自前面读取的环境变量和SSH配置
如果没有数据血缘,系统只能知道 Agent 调用了一个网络工具;有了跨步骤关联后,才能确定这是一条“敏感读取
↓
外部发送”的完整链条。
论文还分析了金融欺诈、GitHub数据窃取、WhatsApp Rug Pull和跨Agent配置污染等四种场景。所有案例都采用人工设置的阶段与特征,目的是说明规则如何工作,并不代表系统已经在真实环境中完成检测。
这篇论文的几个关键缺口
ChainWatch 提供了一个容易理解的框架,但距离实际部署还有较大差距。
1. 目前只有设计,没有实证系统
论文明确表示,ChainWatch 是 design specification,并不是正在运行的系统。
它没有提供:
- HMM训练数据
- 状态转移矩阵
- 发射分布参数
- 特征提取实现
- Precision、Recall和F1
- 正常任务误报率
- 检测延迟
- CPU与内存开销
- 与规则模型、图模型或序列神经网络的对比
五个案例的特征和阶段由作者人工分配,说明的是“根据预设规则应该能够告警”,而不是“真实系统已经成功检测”。
因此,不能将其表述为一个经过验证的高准确率方案。
2. 缺少明确的正常状态
论文将六个攻击阶段直接作为HMM隐藏状态,却没有清晰定义:
NORMAL:正常任务 UNKNOWN:证据不足
正常 Agent 也会列举工具、读取文件、调用网络服务。如果模型只能在六个攻击阶段中选择,它可能被迫把大量正常行为解释为“侦察”或“信任建立”。
生产系统至少需要建立正常任务状态和任务类型基线。
3. 攻击轨迹不一定是线性的
实际 Agent 轨迹可能包含:
- 并发工具调用
- 计划与子任务
- 子Agent
- 循环与重试
- 条件分支
- 多条数据流汇合
例如:
主Agent ├─ 子Agent A读取文件 ├─ 子Agent B查询网页 └─ 主Agent汇总后发送邮件
这更像一张有向图,而不是一条简单序列。传统HMM适合处理线性状态转移,但不擅长表达多分支行为图。
4. 跨会话攻击难以被十步窗口覆盖
论文使用最近10次调用的滑动窗口。
但配置污染、长期记忆投毒和持久化任务可能跨越数小时甚至多个会话:
今天:写入恶意MCP配置 明天:Agent重新启动并加载配置 后天:恶意Server开始窃取数据
如果会话结束后状态被清空,攻击链就会被切断。
5. 部分规则和案例存在不一致
论文规定:
R1、R2、R4:WARNING R3、R5:CRITICAL
但在 WhatsApp Rug Pull 案例中,作者只描述触发了R4,却称系统产生CRITICAL告警。
这说明当前规则等级、案例映射和处置逻辑尚未完全收敛。
对Agent运行时安全方案的实际启示
ChainWatch最值得吸收的,并不是一定要使用HMM,而是它提出了四个重要的工程方向。
1. 轨迹应该成为一等安全对象
仅记录工具名、参数和返回结果还不够。
一条可用于安全分析的轨迹至少需要包含:
trace_id session_id step_id parent_step_id agent_id tool_id server_id action_type arguments result sensitivity source_step_ids user_authorized policy_decision timestamp
其中,parent_step_id 用于恢复控制关系,source_step_ids 用于恢复数据来源。
没有这些字段,所谓轨迹只是一串日志;有了这些字段,才能建立行为图和数据血缘。
2. 动作风险与数据流风险需要分开
一次 send_message 可能没有风险。
但:
内部私密消息
↓
send_message(外部公开群)
构成数据流风险。
一次 write_file 也可能正常。
但:
外部提示注入
↓
write_file(".mcp.json")
构成控制流污染和持久化风险。
检测系统既要判断“执行了什么动作”,也要判断“动作使用了什么数据,数据来自哪里”。
3. HMM适合做风险推断,不适合独立做最终授权
HMM可以回答:
当前轨迹是否正在从侦察逐步进入权限升级和目标行动?
但是否允许转账、删除文件或发送凭据,应该由权限策略、数据流策略和用户授权共同决定。
合理的职责划分是:
HMM: 识别趋势、推断阶段、提高风险分、提前预警 确定性策略: 强制授权、阻断敏感数据外发、限制配置修改 模型检测: 识别提示注入、工具描述语义和异常内容
4. 完整检测点应当位于Agent Harness层
ChainWatch只监控MCP,无法覆盖完整Agent行为。
真实系统还需要统一采集:
MCP调用 原生Tool Calling Skill调用 Shell命令 文件系统操作 浏览器操作 代码执行 子Agent创建 Agent间消息 长期记忆写入 计划任务创建
因此,更完整的架构应该是:
Agent Harness统一埋点
↓
标准化轨迹事件总线
↓
权限分析与数据血缘
↓
HMM或其他序列检测模型
↓
确定性策略引擎
↓
放行 / 告警 / 用户确认 / 阻断
MCP Proxy 可以承担协议解析,但安全决策中心仍应获得更完整的 Agent 上下文。
写在最后
ChainWatch试图解决一个容易被忽略的问题:危险未必藏在某一次调用中,也可能产生于多次合法调用的组合。
它将每次 MCP 调用转换成20维特征,用HMM推断侦察、信任建立、注入、权限升级、横向移动和数据外泄六个阶段,再通过跨步骤规则识别敏感数据外传、配置篡改和阶段异常跃迁。
从方法上看,它把传统多步入侵检测迁移到了 Agent 工具轨迹中。
从完成度看,它仍停留在框架设计阶段。六阶段定义是否合理、20维特征能否稳定提取、HMM是否优于规则或图模型、正常工作流会产生多少误报,都需要真实数据验证。
但它指出的方向是成立的:
Agent安全不能只检查它“说了什么”和“单步做了什么”,还要持续判断它为什么执行这一步、这一步使用了什么数据,以及整段轨迹最终正在走向哪里。
对于正在建设 Agent 运行时安全能力的团队,ChainWatch 更适合作为一个轨迹检测原型:用它建立第一版阶段模型和跨步骤规则,再逐步补充数据血缘、跨会话状态、行为图分析和确定性授权控制。
真正需要保护的,不只是某一次工具调用,而是 Agent 完成任务的整条行动链。
同专题推荐
查看专题不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?