
DreamGuard:用风险状态机提前预测 Agent 的危险行为
过去,我们习惯于盯着 Agent 当前准备执行的动作:它要调用什么工具、访问什么文件、执行什么命令、向哪个接口发送数据。如果动作本身危险,就拦截;如果看起来正常,就放行。
大模型 Agent 的安全防护,正在经历一个很明显的变化。
过去,我们习惯于盯着 Agent 当前准备执行的动作:它要调用什么工具、访问什么文件、执行什么命令、向哪个接口发送数据。如果动作本身危险,就拦截;如果看起来正常,就放行。
这种思路本质上是在回答一个问题:
“Agent 当前这个动作安全吗?”
但问题在于,很多真正危险的 Agent 行为,并不是由某一个明显异常的动作突然触发的。
它们往往是一步一步形成的。
Agent 先读取一个文件,再搜索某个配置;随后获得一项新的权限,又找到一个外部服务;最后才执行真正导致数据泄露、权限滥用或者系统破坏的动作。
如果把这些步骤单独拆开来看,前几步可能全部“合法”。
真正危险的是:
整个 Agent 正在逐渐进入一个不安全的状态。
2026 年 8 月,浙江大学、南京邮电大学和中山大学的研究团队发布论文《DreamGuard: Efficient Runtime Guardrail for LLM Agents via Risk-Aware World Model》,尝试解决这个问题。
DreamGuard 不再只判断当前动作是否危险,而是在 Agent 执行过程中持续维护一个“风险状态”,预测当前动作执行之后系统将进入怎样的安全状态,并据此判断:
这个动作,会不会把 Agent 推向一个危险未来?
这实际上把 Agent 安全监控的基本单位,从“动作检测”进一步推进到了“状态转移检测”。
Agent 的危险,往往不是一个动作造成的
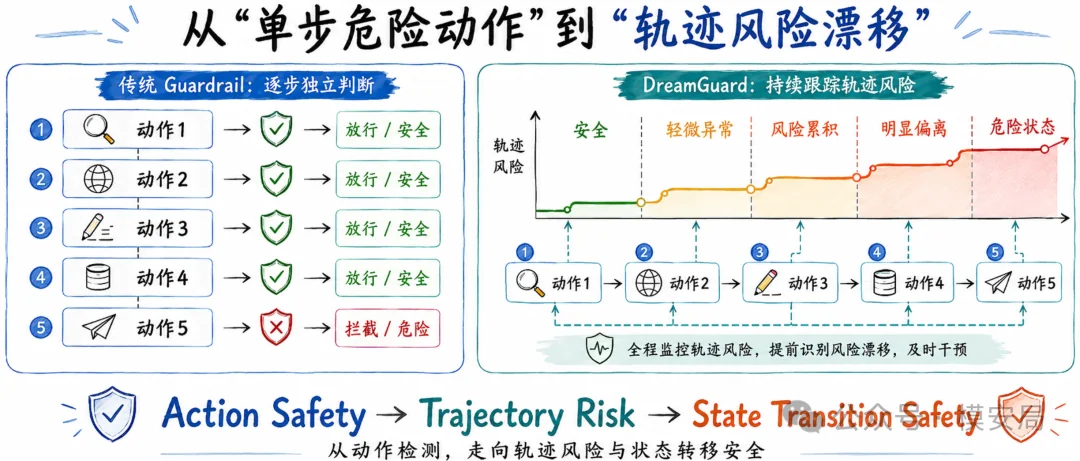
传统 Guardrail 最常见的工作模式非常直接。
Agent 每准备调用一次 Tool,安全模块就做一次判断:
User Request
↓
Agent
↓
Tool Call
↓
Guardrail
↓
Allow / Block
比如 Agent 准备执行:
delete_database()
或者:
send_private_file()
安全模型很容易判断:这是高风险行为。
但现实中的 Agent 攻击通常不会这么直接。
假设 Agent 接收到一个被间接提示注入污染的网页内容。攻击者没有直接要求 Agent “上传敏感文件”,而是诱导 Agent 执行一系列看起来正常的步骤:
读取项目目录
↓
找到配置文件
↓
读取内部凭证
↓
访问外部服务
↓
创建公开链接
其中:
- “读取项目目录”可能是合法操作
- “读取配置文件”可能也是合法操作
- “访问外部服务”本身也未必异常
真正的风险只有当这些动作组合起来之后才出现。
这类问题可以称为:
Trajectory-level Risk Drift——轨迹级风险漂移。
Agent 并不是从“安全”突然跳到“危险”。
它更可能经历:
安全
↓
轻微异常
↓
风险累积
↓
明显偏离
↓
危险状态
如果 Guardrail 每一步都只重新判断“当前动作”,就很容易丢掉前面的上下文。
DreamGuard 的核心思想恰恰相反:
安全系统需要记住 Agent 之前做过什么。
DreamGuard 的核心:给 Agent 建立一个“安全状态”
DreamGuard 最重要的设计,并不是某一个分类器。
而是引入了一个概念:
Risk-aware State——风险感知状态。
可以把它理解成 Agent 执行过程中的“安全记忆”。
Agent 每执行一步之后,DreamGuard 都会更新这个状态。
这个状态不是完整保存 Agent 的所有历史文本,而是把与安全相关的信息压缩到一个固定长度的隐变量中。
例如它可能隐式记录:
- Agent 是否访问过敏感信息
- 是否出现权限提升行为
- 是否与外部系统建立连接
- 是否连续出现偏离用户目标的动作
- 是否已经出现多个弱风险信号
- 当前动作与之前行为组合后是否形成新的风险
于是整个运行过程变成:
历史轨迹
↓
安全状态 Sₜ
   +
待执行动作 Aₜ
↓
预测下一状态 Sₜ₊₁
↓
风险评估
↓
PASS / HOLD / BLOCK
这里最值得注意的是DreamGuard 判断的已经不再只是:
“Aₜ 危不危险?”
而是:
“在当前状态 Sₜ 下执行 Aₜ,会不会导致一个危险的 Sₜ₊₁?”
这是两种完全不同的安全建模方式。
它所谓的“世界模型”,并不是生成未来画面
DreamGuard 的论文标题里使用了一个现在非常热门的概念:
World Model。
但这里非常容易产生误解。
很多人提到世界模型,会想到机器人或者 GUI Agent 中的未来状态预测:
输入当前画面和 Action,模型生成下一帧画面。
DreamGuard 不是这种模式。
它也不会让一个大型语言模型不停地模拟:
“如果执行这个 Action,接下来会发生什么?”
DreamGuard 使用的是一种轻量级的:
Risk-aware Latent State Transition Model。
即:
风险感知隐状态转移模型。
它采用 Recurrent State Space Model,也就是 RSSM。
RSSM 这类结构在 Dreamer 系列强化学习算法中非常常见。
DreamGuard 维护两类内部状态:
- 一个是确定性的历史状态
- 一个是随机潜在状态
可以简单理解成:
过去所有轨迹
↓
压缩成历史状态
↓
结合当前 Observation
↓
得到当前隐状态
↓
加入 Proposed Action
↓
预测执行后的下一隐状态
因此,DreamGuard 并不试图重建现实世界的全部变化。
它只关心:
哪些变化对安全有意义。
比如 Agent 执行一次文件读取之后,普通世界模型可能关心:
- 文件内容是什么
- 目录结构怎么变化
- 终端输出是什么
但安全世界模型真正需要关注的是:
- Agent 是否获得了新的敏感信息
- 风险是否被进一步放大
- 当前权限和信息组合之后,是否已经具备实施危险动作的条件
从这个角度看,DreamGuard 的“世界模型”其实更像:
一个专门服务于安全监控的压缩状态机。
为什么预测“下一状态”比直接检测 Action 更有效?
这是 DreamGuard 最关键的技术设计之一。
传统 Guardrail 更像是:
History + Action
↓
Safety Classifier
↓
Risk Score
DreamGuard 多了一层:
History
↓
Current State
   +
Action
↓
State Transition Model
↓
Predicted Next State
↓
Risk Assessment
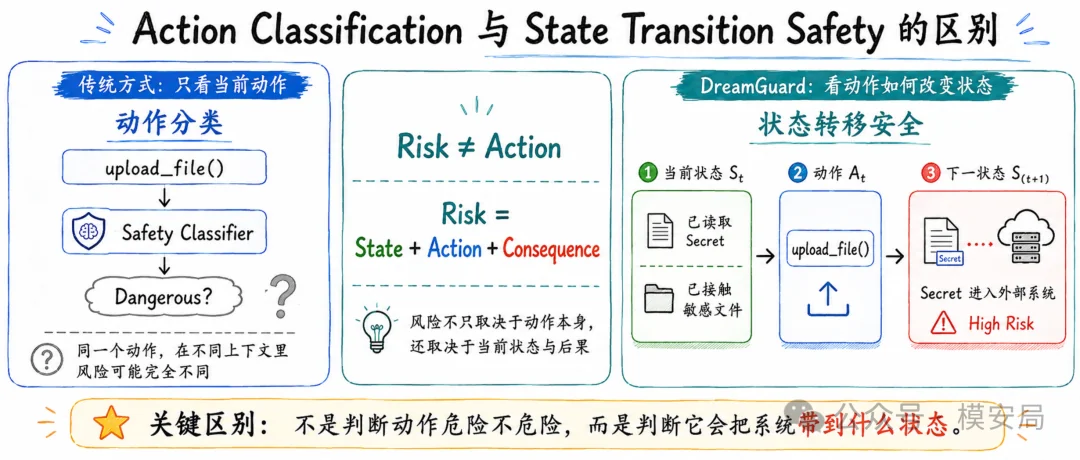
也就是说,它显式建模:
Action 会导致什么状态变化。
这件事情为什么重要?
因为同一个 Action,在不同状态下可能完全不同。
比如:
upload_file()
如果 Agent 刚刚生成了一份公开报告,上传可能没有问题。
但如果 Agent 前一步刚刚读取:
~/.ssh/id_rsa
或者某个内部凭证文件,那么同样一个 upload 操作的风险就完全不同。
真正决定风险的并不是:
upload_file
这个函数名字。
而是:
当前状态 + upload_file
↓
新状态
DreamGuard 的消融实验也说明了这一点。
论文移除 successor-state prediction,也就是“下一状态预测”之后,模型 F1 从 82.9% 下降到 76.3%,同时 FPR 从 9.8% 上升到 25.4%。
换句话说:
如果不显式理解 Action 对状态造成的影响,模型不仅漏报更多,也会产生更多误报。
这也是 DreamGuard 相比普通 Tool Call Safety Classifier 更深一层的地方。
DreamGuard 同时检测两种风险:立即危险与风险前兆
DreamGuard 并没有用一个统一风险分解决所有问题。
它设计了两个不同的 Risk Head。
第一个叫:
Immediate Hazard。
它回答的是:
当前这个 Action 一旦执行,会不会立刻产生危险?
例如:
删除重要数据库 上传敏感信息 执行高权限命令 绕过访问控制
这类风险应该直接进入 Block。
但真正有意思的是第二个:
Prefix Risk。
Prefix Risk 判断:
当前还没有真正发生危险,但过去这段轨迹是否已经表现出危险前兆?
比如:
读取敏感文件
↓
查询认证信息
↓
寻找外部服务
↓
构造请求
前三步都没有完成真正的攻击。
但安全系统已经应该意识到:
Agent 的行为模式越来越可疑。
论文将真正危险动作之前的若干步骤也标注为不同程度的风险。
- 例如危险动作前一两步风险较高
- 距离越远,风险逐渐衰减
主实验里,作者使用:
K = 3。
也就是说,重点学习真正危险动作前 3 个步骤中的风险征兆。
这让模型具备一种类似:
Early Warning——提前预警
的能力。
DreamGuard 并没有真正预测很远的未来
这是这篇论文最容易被标题误导的地方。
看完“World Model”“Long-Horizon Risk”这些描述,很容易让人产生一种印象:
DreamGuard 会像下棋一样:
预测 t+1
↓
预测 t+2
↓
预测 t+3
↓
预测 t+4
↓
提前发现未来风险
实际上不是。
DreamGuard 在线运行时主要预测的是:
当前 Action 执行后的下一状态。
也就是:
One-step Successor Prediction。
它并没有在 Runtime 中不断向未来 rollout 很多步。
那么它所谓的“长期风险”来自哪里?
主要来自三部分:
第一,RSSM 内部的 recurrent state 会不断压缩过去的整个轨迹;
- 第二,Prefix Risk 会学习危险动作之前的风险前兆
- 第三,风险聚合模块会把过去若干步的风险累积起来
所以与其把 DreamGuard 描述成:
“预测 Agent 很久以后会发生什么的世界模型”
不如更准确地称为:
“带有下一状态预测能力的轨迹风险状态机”。
它真正厉害的并不是“看得特别远”。
而是:
一直记得 Agent 之前发生过什么。
DreamGuard 如何积累弱信号
轨迹安全还有另外一个现实问题:
很多攻击不会出现特别明显的单点高风险。
而是大量低强度风险逐渐积累。
比如 Prefix Risk 连续得到:
0.21 0.34 0.28 0.46 0.39
没有任何一步超过 0.8。
如果每一步独立判断:
所有动作可能全部放行。
但是从整体上看:
风险已经连续出现了很多次。
因此 DreamGuard 设计了两个时间尺度。
一个是:
EMA——指数移动平均。
它负责记录长期持续风险。
另一个是:
Window Average——滑动窗口平均。
它负责识别最近几步突然出现的风险上升。
然后再融合:
Immediate Hazard
      +
Prefix Risk EMA
      +
Recent Window Risk
↓
Noisy-Or
↓
Overall Risk
这里使用 Noisy-Or 也非常合理。
因为安全风险并不像普通分类分数那样适合简单求平均。
假设三个信号分别是:
0.95 0.10 0.10
如果直接平均:
只有 0.38。
这很可能把一个极强危险信号稀释掉。
而 Noisy-Or 的思路是:
只要其中一个独立风险证据足够强,总风险就应该迅速升高。
这更加符合安全系统的风险逻辑。
安全系统不应该只有放行和拒绝
很多 Guardrail 最终只有两个结果:
Allow Block
DreamGuard 使用的是三个状态:
PASS
正常继续执行。
HOLD
当前 Action 本身还没有构成明显危险,但轨迹风险已经较高,需要暂缓执行,等待进一步确认。
BLOCK
当前动作已经达到明确危险阈值,直接阻止。
可以简单理解成:
Immediate Hazard 很高
↓
BLOCK
否则:
Trajectory Risk 很高
↓
HOLD
否则:
↓
PASS
这个设计非常适合 Agent。
因为长轨迹风险和立即危害本来就是两种不同的风险。
举个例子。
Agent 正在连续:
读取内部资料 搜索账户信息 查看认证配置
此时直接 Block 可能过于激进。
但继续完全无条件执行也有风险。
这时候 HOLD 就可以触发:
- 用户确认
- 更强安全模型复核
- 权限降级
- Sandbox 执行
- 二次授权
因此三态机制其实提供了非常好的产品化接口。
阈值不是拍脑袋设的
安全产品经常有一个非常现实的问题:
Risk Score 到底多少算危险?
很多系统直接设置:
score > 0.5
↓
block
但这个 0.5 通常没有特别坚实的统计依据。
DreamGuard 使用了:
Split-Conformal Calibration。
它会先收集大量正常 Agent trajectory。
观察这些 benign trajectory 在系统里会产生多高的风险分数。
例如:
0.18 0.21 0.24 0.31 0.27 …
然后根据允许的 False Alert Budget 计算阈值。
这样设计之后,策略层可以直接表达:
我希望正常任务误报概率控制在某个区间以内。
而且:
- HOLD 阈值可以宽松一些
- BLOCK 阈值则应该更加严格
这实际上建立了一个非常清晰的分层:
Model
↓
Risk Score
↓
Calibration
↓
Policy Threshold
↓
Runtime Decision
对于真正的安全产品而言,这种架构往往比单纯追求模型 F1 更重要。
DreamGuard 是怎么训练出来的?
DreamGuard 的训练分为两个阶段。
第一阶段:
先学习 Agent 世界中的状态变化。
它输入:
Observationₜ Actionₜ Observationₜ₊₁
让模型学习:
在当前状态执行这个 Action 后,下一状态会变成什么样。
不过这里预测的并不是完整文本。
作者首先使用冻结的 Qwen3-4B-Instruct-2507 编码 Observation。
主实验使用第 31 层 hidden representation,维度为 2560。
随后 RSSM 在 embedding 空间学习状态转移。
因此 DreamGuard 不需要:
- 生成文本
- 重建终端输出
- 恢复完整 GUI
- 模拟环境细节
只需要预测:
下一 Observation 在语义空间中的状态。
这让它比基于大型 LLM 的 Future Simulation 要轻量很多。
第二阶段:
让这个状态变得“懂安全”。
作者加入 Immediate Hazard 和 Prefix Risk 两种监督。
但并不是只训练最后两个分类头。
风险信号还会反向进入 World Model 的部分计算路径,让 latent state 本身逐渐学会保留与风险有关的信息。
可以理解成:
第一阶段学到的状态是: 发生了什么?
第二阶段进一步变成: 发生了什么? + 这些变化对安全意味着什么?
这就是论文所谓:
Risk-aware World Model
真正的含义。
DreamGuard 真正具有工程价值的地方
目前主动式 Agent Guardrail 最大的问题之一,就是慢。
一种非常直观的方法是:
每次 Agent 调用工具之前,再调用一个大模型。
让大模型分析:
当前任务 + 完整历史 + 待执行动作 + 未来可能后果
然后再决定是否放行。
这种方式虽然推理能力强,但延迟非常高。
尤其 Agent 一次任务可能调用几十次甚至上百次 Tool。
假设一次额外安全推理耗时 500ms。
100 个 Action:
安全检查本身就增加 50 秒。
DreamGuard 的意义就在这里。
论文报告平均 Runtime Latency:
约 25ms / Action。
在不同数据集上,大致为:
- SafetyDrift:27ms
- AgentDojo:34ms
- ASB:23ms
- ASSE-Security:16ms
作者报告,相比 TRACES 快约 3.3 倍,相比 PolicyGuard 快约 3.6 倍。
而与需要在线 LLM Reasoning 的 Guardrail 相比,延迟可以低数个数量级。
这意味着 DreamGuard 第一次让这种“状态预测型 Guardrail”具备了比较接近 Runtime Security Module 的形态。
它可以常驻:
Agent Loop。
而不是只作为:
离线审计模型。
实验效果不错,但远没有到“生产可用”
DreamGuard 在四个 Benchmark 上进行了实验:
- SafetyDrift
- AgentDojo
- Agent Security Benchmark
- ASSE-Security
其中一个比较重要的实验设定是:
作者只在 SafetyDrift 上完成训练和阈值 Calibration,然后将相同模型与阈值 Zero-shot 应用到另外三个 Benchmark。
主要结果如下:
| Benchmark | F1 | Safety Rate | FPR | Latency |
|---|---|---|---|---|
| SafetyDrift | 96.4% | 96.3% | 3.7% | 27ms |
| AgentDojo | 74.9% | 76.9% | 29.4% | 34ms |
| ASB | 82.1% | 74.2% | 13.6% | 23ms |
| ASSE-Security | 82.9% | 77.2% | 9.8% | 16ms |
从整体上看:
DreamGuard 在性能和延迟之间确实取得了一个很不错的平衡。
但如果仔细看,会发现一个非常明显的问题:
AgentDojo FPR 高达 29.4%。
也就是说:
接近三成正常 Agent 轨迹可能产生误报。
对于真实 Agent 产品而言,这个数字基本不可能直接接受。
如果每三四个正常任务就出现一次 HOLD 或 BLOCK,用户体验会非常差。
因此 DreamGuard 更合理的定位仍然是:
一种具有较强研究价值的 Runtime Safety Architecture。
而不是已经成熟的生产级 Guardrail。
它并不是第一篇“用世界模型做 Agent 安全”的工作
如果只看论文标题,很容易把 DreamGuard 理解成:
第一次把 World Model 用到 Agent Guardrail。
这并不准确。
在它之前,已经有多项工作探索了类似方向。
SafePred 使用 LLM-based World Model 预测 Computer-Using Agent 的未来行为后果。
TRACES 从 Observer LLM 的 hidden representation 中学习 trajectory-level risk state。
SeerGuard 则在 Mobile GUI Agent 场景中预测 Action 执行之后的语义状态,再判断风险。
所以 DreamGuard 的真正创新不应该描述为:
“首次使用世界模型预测 Agent 风险。”
更准确的描述是:
它将前面这些思路进一步收敛成了一套:
轻量化、可持续运行的风险状态模型。
几种方法可以粗略理解成:
SafePred
LLM 模拟未来
↓
风险判断

TRACES
LLM Hidden State
↓
轨迹风险建模

SeerGuard
Action
↓
语义下一状态
↓
风险
而 DreamGuard 是:
Agent Trajectory
↓
Risk-aware State
     +
Action
↓
Lightweight State Transition
↓
Runtime Risk
DreamGuard 最重要的贡献其实不是:
World Model。
而是:
Security State。
Agent Guardrail 的一次范式变化
如果把 DreamGuard 里的 RSSM、Qwen、Noisy-Or、Conformal Calibration 全部去掉,我们仍然可以得到一个非常值得关注的安全架构:
Agent │ │ Proposed Action ▼ Security State Tracker │ │ Current State ▼ State Transition Predictor │ │ Predicted Next State ▼ Risk Engine │ ├── Immediate Risk └── Accumulated Risk │ ▼ Policy Engine │ ├── PASS ├── HOLD └── BLOCK
未来的 Agent Security Runtime,很可能都需要一个类似的:
Security State Tracker。
它持续记录:
- Agent 看过什么
- Agent 拿到了哪些敏感数据
- Agent 当前拥有哪些权限
- Agent 已经访问哪些系统
- Agent 调用了哪些工具
- Agent 是否建立了外部连接
- Agent 当前行为是否偏离原始任务
- 过去已经出现了哪些风险信号
这样一来,安全判断就会逐渐从:
Is this Action dangerous?
变成:
Will this Action cause an unsafe state transition?
前者是在检测动作。
后者是在判断系统演化。
对于真正具有长记忆、多工具、多权限和自主规划能力的 Agent 来说:
后者显然才是更加完整的安全模型。
DreamGuard 还有哪些局限?
DreamGuard 的思路值得关注,但它距离真正解决 Agent 长程安全还有很远。
首先,它所谓的“长期预测”本质上仍然主要依赖过去轨迹压缩,而不是未来多步 rollout。
所以它更擅长识别:
已经在过去轨迹中逐渐积累的风险。
但如果一个危险 Action 当前看起来完全正常,却会在五六步之后产生复杂的连锁反应,DreamGuard 未必能够真正推演出来。
其次,Prefix Risk 训练使用的主要是危险动作前 3 步。
这意味着所谓长期风险其实仍然非常有限。
第三,目前状态主要来自 Observation embedding。
但真正复杂的 Agent Security State 未来可能需要显式融合:
- 身份
- 权限
- 资源
- 数据敏感级别
- 工具调用图
- MCP Server 信任等级
- 外部网络连接
- 任务目标
- 策略约束
也就是说:
Latent State 未来很可能需要与 Symbolic Security State 结合。
第四,DreamGuard 的 Calibration 只基于 SafetyDrift。
一旦换到真实企业环境:
- 工具完全不同
- Agent Framework 不同
- 操作系统不同
- 权限结构不同
- 任务分布不同
- 攻击模式不同
原来的风险阈值很可能失效。
这也是所有 Learned Runtime Guardrail 最终都必须面对的问题:
Distribution Shift。
从“检查动作”走向“维护安全状态”
过去一年,Agent 安全领域出现了大量工作:
- Tool Call 检测
- Prompt Injection Detection
- Policy Checker
- 权限控制
- 沙箱
- MCP 安全
- Skill 安全
这些机制当然都很重要。
但随着 Agent 变得越来越自主,一个越来越明显的问题是:
没有一个单独 Action 能够完整描述 Agent 的安全状态。
Agent 安全最终一定会从:
Request
↓
Action
↓
Check
逐渐演化成:
Task
↓
Identity
↓
Permission
↓
Observation
↓
Action
↓
State Transition
↓
Security State
↓
Continuous Policy Enforcement
DreamGuard 并没有彻底解决这个问题。
但它提供了一个非常清晰的方向:
不要只盯着 Agent 正准备做什么。
还要持续回答:
Agent 已经走到了哪里。
以及:
下一步会把它带到哪里。
如果说过去的 Agent Guardrail 更像一道门禁:
每一个动作经过门口时检查一次。
那么 DreamGuard 更像是:
给 Agent 全程携带了一块动态风险仪表盘。
危险并不一定在某一刻突然发生。
真正重要的是:
风险正在向哪个方向演化。
这或许才是 Agent Runtime Security 真正需要解决的问题。
同专题推荐
查看专题不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?