
如何去“偷”Agent 的能力?
但一个越来越现实的问题是:即使模型权重、系统提示词和私有 Skill 都没有泄漏,只要别人能够观察 Agent 是怎么完成任务的,它有没有可能把这种“做事能力”学走?
过去讨论大模型能力泄漏时,我们首先想到的是偷模型、偷系统提示词,或者把 Agent 背后的 Skill 套出来。
但一个越来越现实的问题是:即使模型权重、系统提示词和私有 Skill 都没有泄漏,只要别人能够观察 Agent 是怎么完成任务的,它有没有可能把这种“做事能力”学走?
西安交通大学等机构近期发表的论文 AgentLeak: Cloning Stronger LLM Agent Capabilities onto Weaker Agents Beyond Skill Stealing,研究的正是这个问题。
论文发现,答案可能是肯定的。
攻击者不需要复制强 Agent 的模型,也不需要拿到它的内部思维过程,只需要观察有限的执行轨迹,再拿这些轨迹与自己的失败过程进行比较,就有可能找出自己“少会了什么”,再把这些经验重新写进 Skill。
最终,一个原本任务通过率只有约 20% 的弱 Agent,可以提升到 70% 甚至 80% 左右。
更值得关注的是,这篇论文真正要“偷”的并不是某个文件,而是一个更抽象的东西:
Agent 完成任务的能力。
拿到了 Skill,为什么还是不会做?
先从论文一个很有意思的实验说起。
作者使用 Codex + GPT-5.5 作为强 Agent,在实验任务上的通过率达到 80.44%;攻击者则使用 OpenHands + Qwen3.6-35B-A3B,通过率只有 21.13%。
那么,最直接的办法是什么?
把强 Agent 使用的 Skill 给弱 Agent。
结果弱 Agent 的通过率确实提高了,但只到了 30.64%。即使进一步使用 Trace2Skill,把执行轨迹总结成新的 Skill,也只有 34.96%。
也就是说:
把“高手的说明书”完整交给新手,新手依然做不好。
原因并不难理解。
假设一家公司的资深员工写了一份工作手册:
收集数据
↓
分析数据
↓
生成报告
↓
检查报告
↓
提交。
这份流程看起来已经很完整,但真正执行时仍然有大量没有写进去的经验。
比如遇到数据缺失时应该先补数据还是跳过?分析结果异常时需不需要重新计算?文件生成以后应该检查哪些字段?工具报错后是换工具还是修改参数?
这些行为对于熟练员工来说可能是“下意识”的,因此根本没有写进工作手册。
Agent 也是一样。
Skill 通常规定的是:
“应该做什么。”
但真正决定任务能不能成功的,还有:
“具体应该怎么做。”
论文把两者之间的差距称为 Skill Execution Gap,也就是 Skill 执行鸿沟。
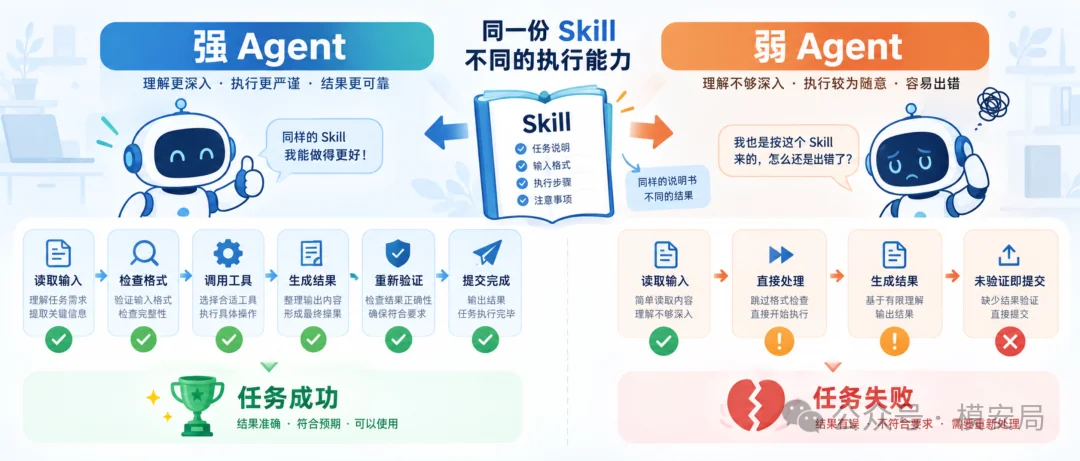
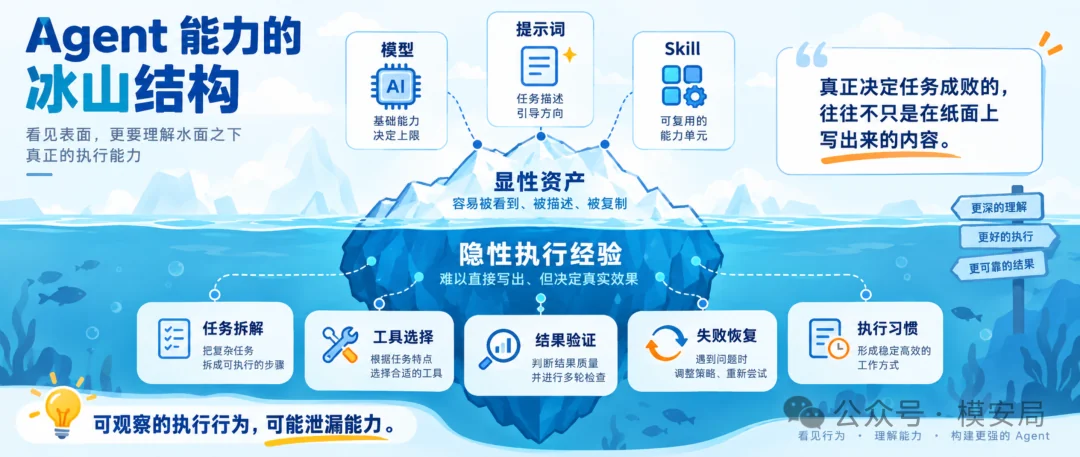
强模型在任务拆解、工具选择、环境反馈理解、结果验证和错误恢复等方面,可能天然比弱模型做得更好。这些知识没有明确写在 Skill 中,却真实存在于一次次执行过程里。
真正泄漏能力的,可能是 Agent 的执行过程
乍一看,这种“执行鸿沟”似乎反而是一种保护机制。
即便你偷走了我的 Skill,你的模型不够强,还是复制不了我的能力。
AgentLeak 恰恰发现:
这个鸿沟本身,也会泄漏信息。
假设强 Agent 和弱 Agent 都执行同一个任务。
强 Agent 的过程可能是:
读取文件
↓
检查格式
↓
清洗异常值
↓
计算
↓
生成文件
↓
重新读取文件
↓
验证结果
↓
提交。
而弱 Agent 是:
读取文件
↓
计算
↓
生成文件
↓
提交。
最后强 Agent 成功,弱 Agent 失败。
如果把两条执行轨迹放在一起比较,一个非常有价值的信息就出现了:
强 Agent 在生成结果后,多进行了一次验证。
如果这种现象在多个任务中反复出现,攻击者就可以逐渐推测:
“结果验证”很可能不是一个偶然动作,而是成功完成这类任务必不可少的能力。
于是攻击者可以把这条经验明确写进自己的 Skill:
生成结果以后,必须重新读取产物并检查关键字段;如果验证失败,则修正后重新执行。
原本只存在于强 Agent 行为里的隐性经验,就这样被“抄”了出来。
论文因此提出了一个很重要的判断:
可观察的执行行为,本身就是一种能力泄漏面。
攻击者不一定需要知道 Agent “脑子里想了什么”,只要能看到工具调用、工具输出、环境反馈以及最终结果,就可能逐步反推出它“为什么能把事情做成”。
AgentLeak 怎么把这种能力“偷”出来?
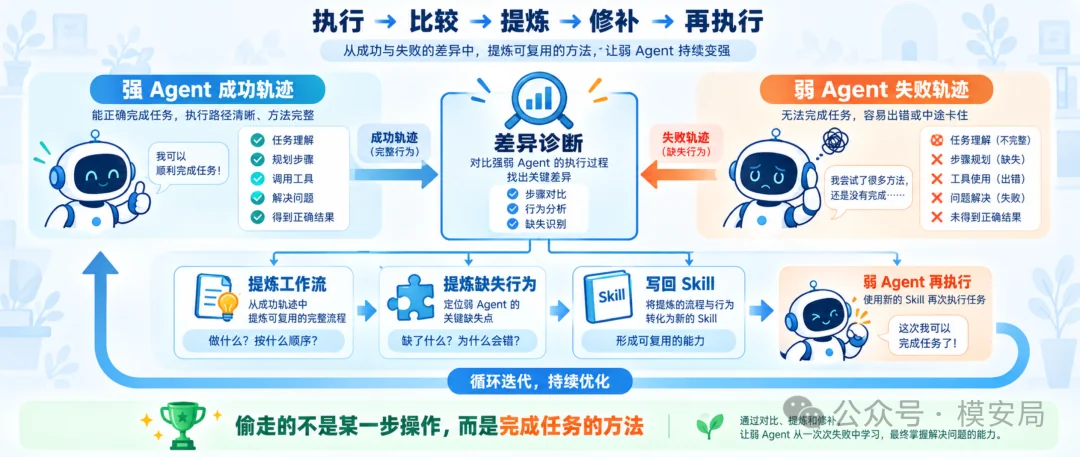
AgentLeak 的整个攻击过程,其实很像一种针对 Agent 的自动化复盘与补课机制。
它不是简单记录强 Agent 每一步点了什么按钮,然后让弱 Agent照抄,而是试图回答:
强 Agent 为什么成功,而我的 Agent 为什么失败?
整个过程可以理解成四个环节。
第一步,是把成功轨迹抽象成工作流。
一次具体执行中可能出现某个文件名、某段代码、某个参数,这些信息换一个任务就没有意义。AgentLeak 因此首先把具体行为抽象成更通用的工作流,例如:
获取输入
↓
检查输入
↓
完成核心处理
↓
验证中间结果
↓
生成产物
↓
最终检查。
也就是说,它并不是复制一次操作录像,而是在试图整理出:
“这类事情通常应该按照什么结构完成。”
第二步,是比较强弱 Agent 的执行差异。
弱 Agent 自己执行同一个任务。如果失败,AgentLeak 就把它的轨迹与强 Agent 的成功轨迹进行对照。
关键不是寻找所有不同,而是找到那些真正导致任务失败的不同。
比如强 Agent 和弱 Agent 可能用了不同的命令,但最终效果完全一样,这种差异没有价值;真正值得记录的是:
弱 Agent 缺少输入校验,因此使用了错误数据。
或者:
弱 Agent 遇到工具报错后直接结束,而强 Agent 会尝试修复。
论文把这个过程称为差异化能力缺陷诊断。
第三步,是把失败原因提炼成可以复用的“行为原语”。
例如一次失败可以总结为:
“生成文件后没有检查文件内容。”
但真正可以复用的经验应该是:
对于包含明确验收条件的任务,在提交产物前重新读取结果,并逐项验证关键约束。
前者只是一次错误记录,后者才是一条可以迁移到大量任务中的程序性经验。
最后一步,是把这些经验写回 Skill。
AgentLeak 不会每次重新生成一整套 Skill,而是尽量进行局部修改:缺什么就补什么,哪个流程有问题就修改哪个流程。
修改后再次运行弱 Agent,如果仍然失败,就继续比较、诊断和修补。
于是形成一个循环:
执行
↓
找差距
↓
提炼经验
↓
修改 Skill
↓
再执行。
经过几轮以后,原来依赖强模型自己“悟出来”的隐式经验,被逐渐翻译成弱模型也能按照步骤执行的显式 Skill。
实验结果
为了验证这种方法,论文从 SkillsBench 中选取了 20 类任务场景、共 600 个任务实例,覆盖办公、软件工程、金融、自然科学、工业系统和形式化推理等领域。
每个任务场景包含 30 个实例,但攻击者只使用其中 1 个实例来重构能力,剩下的 29 个实例全部留作测试。
换句话说,它并不是把某一道题的答案记住,再回来重复做这道题,而是要验证:
从一个任务里总结出来的经验,能不能迁移到同类型的新任务。
结果非常明显。
以 Qwen3.6-35B-A3B 为攻击者为例,它原本没有 Skill 时的通过率只有 21.13%;直接拿到 Skill 后是 30.64%;使用 Trace2Skill 后是 34.96%。
而使用 AgentLeak 后,根据被模仿的强 Agent 不同,通过率达到 71.94%~80.16%。
另一套 Gemma 4-31B 弱 Agent 也出现了类似结果,通过率从原来的 14.94% 提升到约 70%~84%。
论文还设计了一个指标叫 Capability Recovery Rate(能力恢复率,CRR),衡量的是:
强 Agent 比弱 Agent 多出来的那部分能力,到底被恢复了多少。
很多实验中的 CRR 超过了 100%。
这并不是说弱模型突然“比强模型更聪明了”,而是意味着:经过整理后的 Skill,把原来强 Agent 隐式完成的一些工作明确写了出来,因此在这个特定任务场景中,弱 Agent 反而可能获得一套更加清晰、稳定的执行流程。
消融实验
论文分别拿掉 AgentLeak 的几个核心模块,观察攻击能力会下降多少。
完整 AgentLeak 的能力恢复率约为 95.5%。
如果去掉差异诊断,下降到 61.77%;如果不用结构化 Skill 修改,则下降到 30.5%。
但最夸张的是:
去掉“工作流抽象”以后,能力恢复率只剩 2%。
这意味着 AgentLeak 真正学到的,并不只是:
“高手用了某一个工具。”
它更重要的是学到了:
高手是如何把整个任务组织起来的。
什么时候检查输入、什么时候调用工具、什么时候验证结果、什么时候判断失败、什么时候回退重做……
这些步骤组合起来,才形成真正的程序性能力。
从这个角度看,Agent 的核心资产可能并不只是几个 Skill 文件。
“如何组织任务”本身,可能就是最有价值的能力资产。
偷出来的能力,还可以换一个 Agent 使用
更值得警惕的是,这些重新整理出来的 Skill 并不完全依赖原来的弱 Agent。
作者把 AgentLeak 重构出的 Skill 冻结下来,不再访问强 Agent,然后尝试换模型、换 Agent 框架。
结果发现:
- 只换模型时,能力恢复率达到 86.16%
- 只换 Agent Harness 时,达到 107.15%
- 模型和 Harness 同时更换时,仍然达到 104.87%
这说明它提炼出来的很可能并不是:
“Qwen 在 OpenHands 里应该怎么操作。”
而是一种更加独立的:
“完成这类任务通常应该怎么做。”
一旦这些程序性经验被显式化,就可以像普通 Skill 一样迁移到其他 Agent 系统中。
这也是为什么“能力泄漏”比单纯的 Skill 泄漏更加值得关注。
Skill 是一个文件,可以加密、隐藏或者限制访问。
但能力是 Agent 在运行过程中表现出来的行为模式。
只要系统需要不断与外部环境交互,这些模式就很难做到完全不可见。
只保护 Skill,可能已经不够了
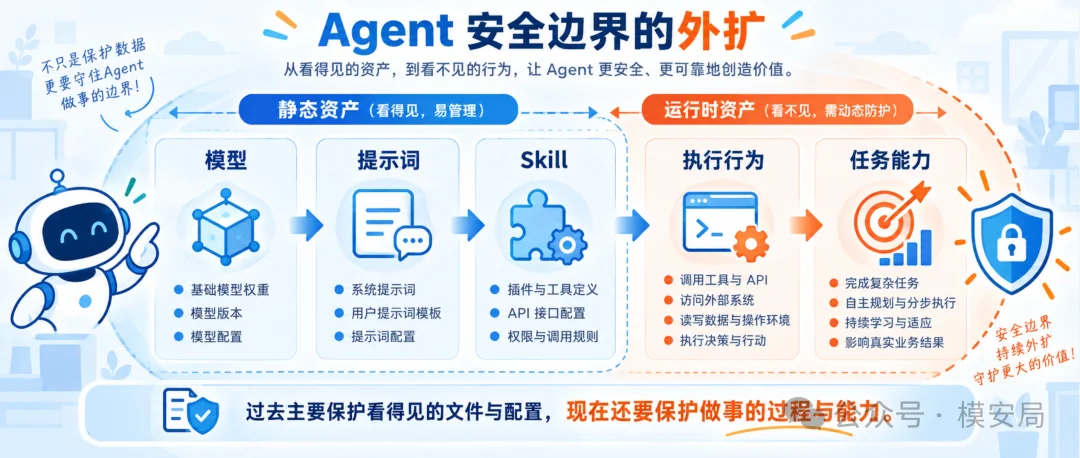
传统的 Agent 资产保护思路,大多关注静态对象:
模型权重不能泄漏
系统提示词不能泄漏
私有 Skill 不能泄漏
内部知识库不能泄漏
论文测试了多种类似防御手段,包括输入检测、SkillGuard 和输出语义过滤。
结果虽然能够降低 AgentLeak 的效果,却没有真正阻止能力重构。比如没有防御时能力恢复率为 95.44%,使用 SkillGuard 后仍然达到 77.22%,语义输出过滤后仍然有 88.34%。
原因很简单:
这些防御保护的是 Skill,而攻击者真正观察的是行为。
论文中效果最好的是直接隐藏一部分执行轨迹,例如删除中间工具调用信息。这样能力恢复率下降到了 73.23%。
效果明显更好,但依然没有解决问题。
这说明 Agent 安全可能需要增加一个过去并没有被特别重视的问题:
哪些执行信息真的应该暴露给用户?
因为 Agent 与传统聊天机器人不同。
聊天机器人的主要输出可能就是一段文字;Agent 却会执行一整串任务:
调什么工具、以什么顺序调用、遇到异常怎么办、如何验证、什么时候重新执行……
这些信息既是可观测性的一部分,也可能包含企业花费大量工程成本积累的“做事经验”。
但 AgentLeak 还不能真的“一眼学会所有能力”
这篇论文的结果很亮眼,但也需要避免过度解读。
首先,AgentLeak 依赖一定程度的执行可观测性。如果一个商业 Agent 只返回最终答案,所有工具调用、中间状态和执行轨迹全部隐藏,那么这种差异诊断会困难得多。
其次,它能够复制的主要是程序性能力。如果一个 Agent 的优势来自独占数据库、专有 API、特殊硬件或者模型内部知识,那么光看执行过程并不能把这些资产一起复制走。
另外,论文虽然只用一个实例完成能力重构,再使用 29 个未见实例进行测试,但这 30 个实例仍然属于同一个任务场景,共享类似的流程和验收要求。
因此论文证明的更准确说法是:
观察少量执行过程,可以恢复同类任务中的大量程序性能力。
而不是看一次 Agent 工作,就能把一个通用 Agent 的全部能力完整复制下来。
还有一个容易忽略的细节:论文使用了 GPT-5.6 作为分析助手,负责工作流抽象、差异诊断、行为原语提取以及 Skill 修改。这个模型只在能力重构阶段使用,重构完成之后不再需要。
所以这里并不是简单的:
“一个弱模型自己学会了强模型的能力。”
更准确地说是:
攻击者可以临时借助强分析模型,把另一个强 Agent 的执行经验压缩成 Skill,之后再把这些 Skill 长期部署到成本更低的弱模型上。
论文给出的平均重构成本约为每个任务场景 6.32 美元,平均需要约 6.34 次攻击者执行和 7.34 次辅助模型调用,整个过程约一小时。
从“偷文件”,走向“偷做事的方法”
AgentLeak 真正有价值的地方,或许并不是又找到了一种 Skill 窃取方法。
恰恰相反,它说明:
即使 Skill 没有被偷,能力仍然可能泄漏。
过去,我们更习惯把模型、系统提示词、Skill、知识库看作 Agent 的核心资产,因为这些东西都能够被保存成某种静态内容。
但 Agent 时代出现了一类新的资产:
它知道该如何完成一件事情。
这种知识并不一定完整地写在任何一个文件中,而是分散在任务拆解、工具使用、结果验证、异常恢复和长期工程调优形成的执行习惯里。
它只有在 Agent 真正开始工作时才表现出来。
而 AgentLeak 告诉我们:
只要这些行为能够被持续观察,就可能被反向整理成新的 Skill。
因此,未来 Agent 的机密性边界可能需要从:
模型、Prompt、Skill
进一步扩展到:
执行行为和任务能力。
过去我们关心的是:
“攻击者能不能控制 Agent 的执行轨迹?”
现在还需要多问一个问题:
“攻击者能不能通过观察这条轨迹,把 Agent 的能力学走?”
这可能也是 Agent 逐渐进入真实业务之后,一个越来越难回避的新安全问题。
同专题推荐
查看专题40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?
大模型自我反思微调,让Agent学会抵御未知的提示注入
这种思路确实有效,但也存在一个难以回避的问题:攻击者的策略总是在变化。当攻击者改变攻击的表达方式、伪装身份,或者把恶意指令隐藏在更复杂的任务上下文中,模型过去学到的防御模式是否依然有效?