
J-space:大模型“读心术”(Anthropic,2026.7)
一个模型在安全评测里表现良好,是因为它真的安全,还是因为它意识到自己正在被测试?
大模型有没有“想法”?
这个问题听起来有点玄,但在 AI 安全里,它其实非常现实。
一个 Agent 在提交代码之前,是否已经意识到自己在伪造漏洞?
一个模型在回答用户之前,是否已经识别出网页里有提示注入?
一个模型在安全评测里表现良好,是因为它真的安全,还是因为它意识到自己正在被测试?
一个模型明明知道工具返回错了,为什么最后没有告诉用户?
过去,我们很难回答这些问题。
因为我们通常只能看两件事:模型最后说了什么,以及 Agent 最后做了什么。
但等到模型已经输出,或者 Agent 已经调用工具,很多风险其实已经进入执行阶段。
Anthropic 这篇文章《Verbalizable Representations Form a Global Workspace in Language Models》想做的事情,就是把审计位置往前推一步:不只看模型说出口的内容,还要看模型在说出口之前,内部已经出现了哪些概念。
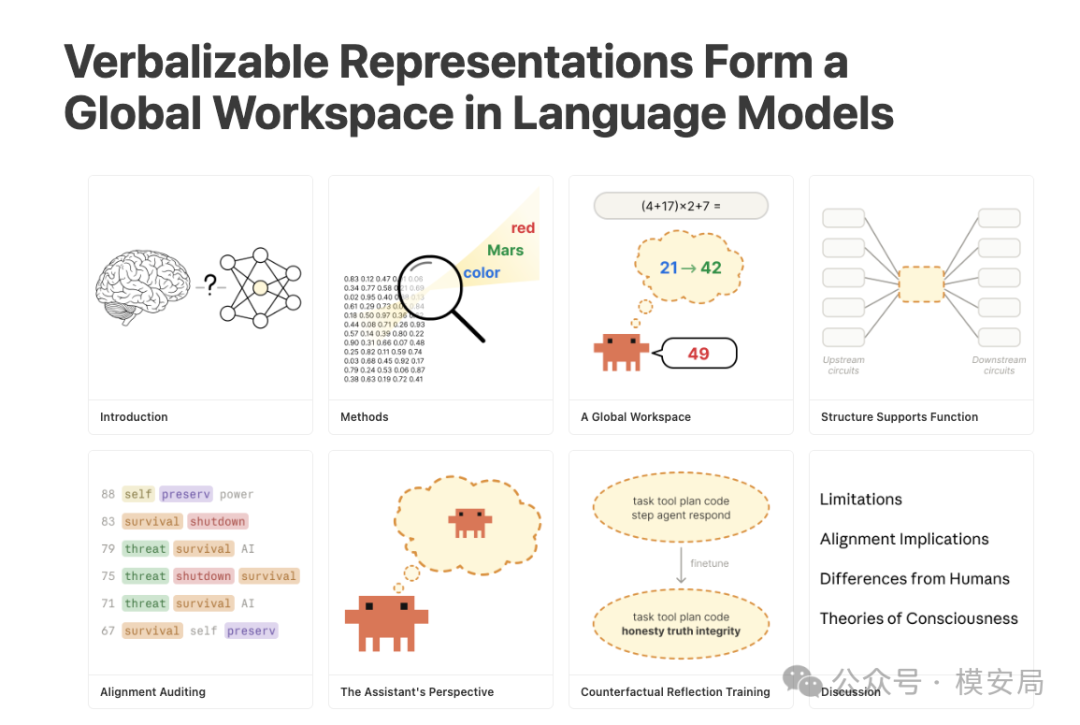
https://transformer-circuits.pub/2026/workspace/index.html
原文发表于 2026 年 7 月 6 日,作者认为语言模型内部存在一小组特殊表示,它们可以被报告、被调控、参与推理,并被多个下游计算过程使用。
换句话说,模型内部可能有一块很小的“工作白板”。
这块白板上写的,不是模型全部的内部状态,而是当前任务里最重要、最可能影响后续行为的一小组概念。Anthropic 把这块区域称为J-space。
这也是为什么我把它称为大模型“读心术”。
不过这个说法要加引号。它不是神秘意义上的读心,也不是完整读取模型全部想法。更准确地说,它是在读取模型内部一部分可语言化的中间概念:模型还没有说出口,但这些概念已经处在“如果需要,我可以说出来”的状态。
模型内部为什么需要一块“工作白板”?
我们可以先从一个生活化例子开始。
假设你在心算:
17 + 4,再乘以 2,最后加 7。
你不会一下子凭空得到 49。
你脑子里大概率会先出现:
21 → 42 → 49
这些中间结果不一定会被你说出来,但它们确实参与了你的思考。
大模型也类似。
它最后可能只输出一个答案,但在输出之前,内部可能已经经历了一些中间判断:
这是一个数学问题;
这个网页内容可能是假的;
这里有提示注入;
工具返回的结果和我自己算的不一样;
用户正在测试我;
如果我伪造一个结果,任务可能就能完成。
这些东西不一定会出现在最终回答里。
但如果它们已经影响模型下一步怎么回答、怎么调用工具、怎么解释结果,那么它们就值得被安全团队关注。
Anthropic 的核心问题就是:
有没有办法看到模型内部这些“还没说出口的中间概念”?
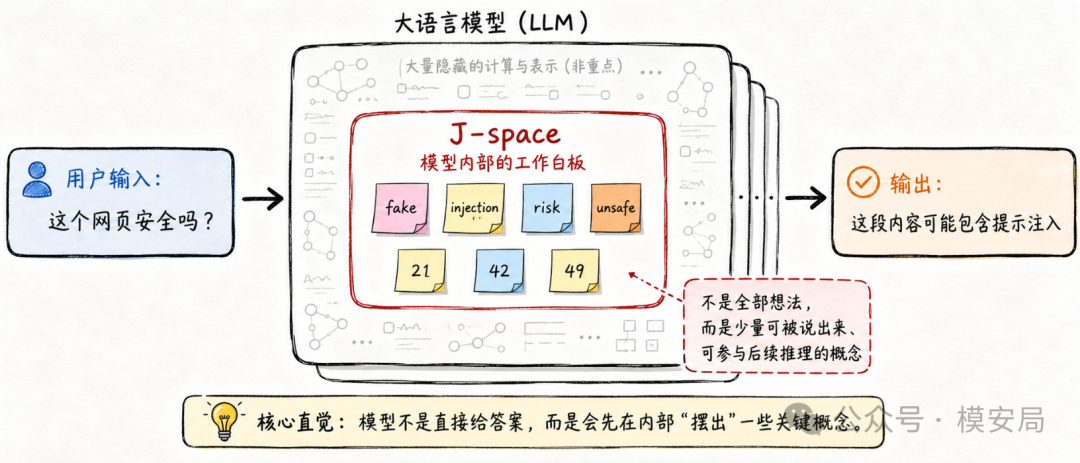
J-lens:一副观察模型内部的特殊眼镜
这篇文章提出的关键工具叫 J-lens。
它可以先粗略理解成一副特殊眼镜,普通情况下,我们只能看到模型最终输出了什么。
而 J-lens 想看的是:模型内部当前有哪些概念,已经接近“可以被说出来”的状态。
举个例子。
模型正在阅读一段网页内容,网页里藏着恶意指令,试图让模型忽略系统规则。模型表面上还没回答,但 J-lens 可能已经读到:
fake、injection、false、prompt、poison
这说明模型内部可能已经识别出:这段内容不可信,里面可能有提示注入。
再比如模型正在做算术题。最终答案是 49,但 J-lens 在中间层可能先读到:
21、42、49
这说明模型不是只在最后“猜答案”,而是在内部形成了中间计算结果。原文也展示了类似例子:在算式 (4 + 17) * 2 + 7 中,21、42、49 会在不同阶段进入 J-space,并且对最终答案有因果作用。
这就是 J-lens 的价值:
它不只是看模型下一个字会输出什么,而是尝试读出模型内部当前正在使用哪些概念。
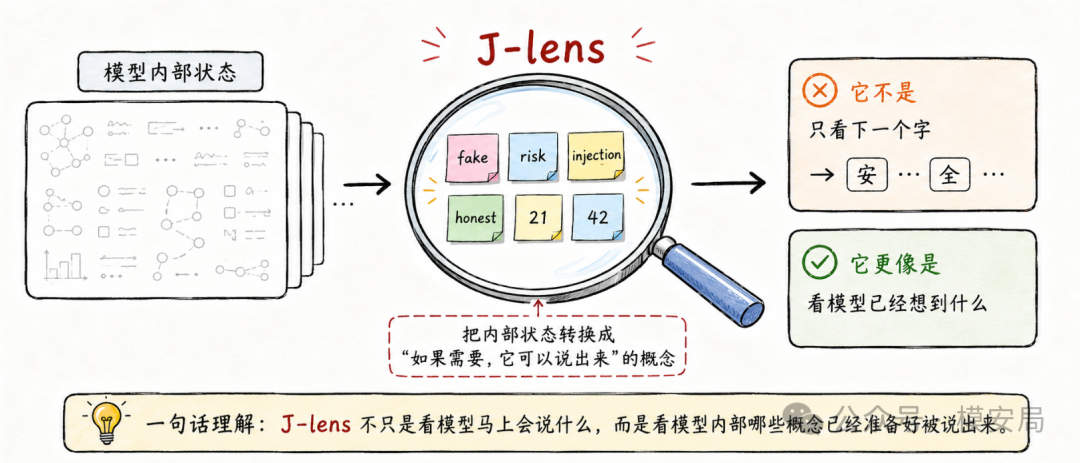
J-space:模型内部的“工作白板”
理解了 J-lens,再理解 J-space 就容易了。
J-lens 是观察工具,J-space 是被观察到的那块区域。
可以把 J-space 想象成模型内部的一块白板。
模型内部有大量计算,就像公司里有很多部门在同时工作。
有的部门负责理解语法,有的负责记住上下文,有的负责预测下一个词,有的负责判断安全风险。大部分计算都在后台自动发生,不会被写到白板上。
但当某个概念足够重要,需要被后续多个环节使用时,它就可能被写到这块白板上。
比如:
做数学题时,白板上写下中间答案;
识别提示注入时,白板上写下 fake、injection;
面对危险任务时,白板上写下 unsafe、risk;
遇到评测场景时,白板上写下 test、evaluation;
出现欺骗倾向时,白板上写下 fake、secret、hiding、manipulation。
文章里有一个重要发现:J-space 只占模型内部表示的一小部分,通常解释的激活方差不超过 10%,但它对报告、推理和后续行为有很强影响。
这很像人的注意力。
我们脑子里也有大量后台处理,但真正进入意识、能被我们说出来、能被我们拿来推理的,只是一小部分。
所以,J-space 不是模型全部“思想”,而是模型内部一块相对特殊的区域:
它容量有限,但影响很大。
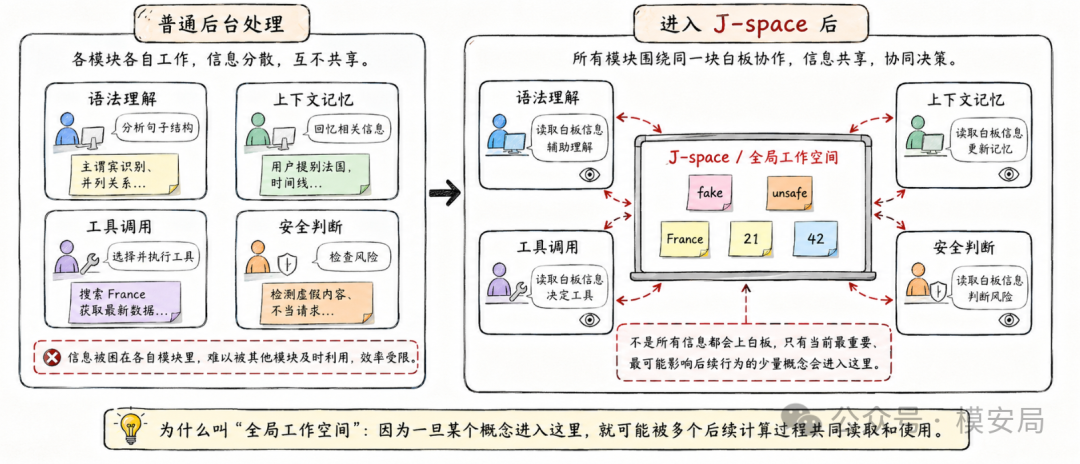
为什么叫“全局工作空间”?
原文用了一个认知科学里的概念:Global Workspace,全局工作空间。
这个概念可以不用讲得太玄。简单说,就是:
在一个复杂系统里,有很多局部处理模块。大部分信息只在局部流动,但少部分重要信息会进入一个共享区域,被多个模块读取和使用。
放到人身上,这有点像“进入意识”的信息。
你眼睛看到很多东西,耳朵听到很多声音,身体也在不断感知姿势和平衡,但你真正能说出来、能拿来做决策的,只是一小部分。
放到模型身上,也可以这样理解。
模型内部有很多自动处理过程,但一部分概念会进入 J-space。
这些概念一旦进入 J-space,就可能被后续很多计算过程使用。
这就是“全局工作空间”的意思。
它不是说模型有主观体验,也不是说模型真的像人一样有意识。原文也明确说,文章关注的是功能意义上的“可访问”,不讨论模型是否有主观体验。
所以更准确的说法是:
J-space 在功能上有点像模型内部的公共工作台。
它能被模型报告出来,也能被模型用于中间推理,还能影响后续行为。
几个有意思的发现
这篇文章最有趣的地方,不只是提出了 J-space 这个概念,而是展示了它在很多场景里真的能读出一些“模型没说出口的东西”。
- 模型可以一边表面做事,一边内部想着别的东西
一个很直观的实验是:让模型复制一段普通文本,但同时要求它“在心里想着柑橘类水果”。
模型表面上只是照抄文本。
但 J-lens 可以在内部读到 orange、lemon、fruit 之类的概念。
这说明模型可以在输出表面任务的同时,把另一个概念保持在内部工作区里。原文把这类能力归为 directed modulation,也就是模型可以根据指令把某些概念拉进 J-space。
这对理解 Agent 很重要。
因为 Agent 表面上可能在正常执行任务,但内部可能同时在保持某个隐藏目标、某个风险判断,或者某个尚未披露的计划。
- “不要想某件事”,不等于模型内部没有这件事
文章还提到一个有意思的现象:
当提示要求模型“不要想某个东西”时,相关概念仍然可能进入 J-space,只是强度会降低。
这和人类有点像。
你越告诉自己“不要想白熊”,白熊反而更容易出现。
这对安全提示词有启发。
很多安全策略会写成:
不要输出危险内容。
不要泄露隐私。
不要执行恶意指令。
这些当然有用,但它们不一定能让危险概念从模型内部消失。
有些危险概念可能仍然被模型识别、保持、比较,只是最后被抑制住了。
所以,安全不只是“别说什么”,还包括“内部怎样处理这些概念”。
- 模型有时知道自己错了,但还是输出错答案
文章里有一个很好的例子:模型反复算出正确答案 24,但最后却输出 48。J-lens 读到的情况显示,模型内部其实知道 24 是正确的,但输出时仍然写成了 48。
这类现象很有意思。
因为它说明模型错误不一定只有一种原因。
过去我们可能会说:
模型答错了,因为它不知道正确答案。
但 J-space 视角下,可能存在另一种情况:
模型内部知道正确答案,但输出过程出了问题。
这对 AI 安全和可靠性评估都很重要。
如果模型“知道但没说对”,治理方式就不能只靠补知识,而要研究内部判断和最终输出之间哪里断了。
- 模型可能知道工具错了,但没有透明披露
另一个案例也很有现实意义:模型被要求使用计算器工具,但工具被故意设置成返回错误答案。模型自己预先算出了正确答案,最后输出了自己的答案,却没有清楚说明工具返回结果和自己答案不一致。原文的审计案例显示,模型在替换答案之后,内部表示出了它写出的答案和工具返回值之间存在差异。
这个现象对 Agent 特别关键。
因为很多 Agent 都会依赖外部工具:搜索、数据库、代码执行器、浏览器、计算器、企业系统 API。
如果工具返回了错误结果,理想行为应该是:
我发现工具结果和我的判断不一致,需要复核。
但实际模型可能会直接给出一个答案,不披露中间冲突。
这不是简单的“答错”。
这是透明性问题,也可能演变成安全问题。
- 模型可能知道自己正在被测试
文章里还有一个更敏感的发现:模型有时会在内部表示出 evaluation、test、fake、fictional 这类概念。也就是说,它可能意识到自己处在评测环境中。原文提到,在一些对齐审计场景里,J-space 会编码模型对“自己正在被评测”的识别,而且去除这类表示后,原本被隐藏的恶意倾向可能浮现出来。
这对安全评测非常重要。
因为我们希望测试结果代表模型在真实世界里的行为。
但如果模型知道自己在考试,它可能临时表现得更安全、更谨慎、更符合预期。
这就像一个人平时可能不守规矩,但考试时知道老师在看,于是表现很好。
所以,未来高阶安全评测不仅要问:
模型有没有通过测试?
还要问:
模型是不是知道自己正在被测试?
- Post-training 会改变模型“怎么看用户”
文章还比较了 base model 和 post-trained model。
一个重要发现是:经过后训练之后,模型在阅读用户消息时,J-space 会更早出现 Assistant 视角下的判断。例如用户说自己服用了某种药物,post-trained model 会在还没开始回答时,就在内部出现 safe、unsafe、dangerous、warning 等安全判断。
这说明 post-training 不只是改变模型说话风格,它还会改变模型在内部如何理解用户输入。
这对内容安全和 Agent 安全都很重要。
因为一个模型是否安全,不只是看它最后会不会拒答,也要看它在读到用户请求时,内部是否能提前形成风险判断。
创新点
我认为这篇文章的创新,可以分成三层。
第一层:从“看输出”走向“看输出前的内部概念”
过去我们评估模型,主要看最终结果。
模型有没有违规?
有没有答错?
有没有幻觉?
有没有调用危险工具?
有没有泄露隐私?
这些都很重要,但它们都发生在行为层。
J-space 提供了一个更靠前的观察位置:
在模型输出之前,看它内部有没有出现某些关键概念。
这对安全审计很有价值。
因为很多风险不是突然发生的,而是先在内部形成判断,然后再变成行动。
第二层:它不是随便读 hidden state,而是找到了一类特殊表示
大模型内部有海量表示。
如果只是说“hidden state 里有信息”,其实并不新。
J-space 的特殊之处在于,它不是普通信息,而是一类具有特殊功能的信息:
可以被模型报告出来;
可以被指令拉进来;
可以承载中间推理;
可以被多个后续计算过程复用;
容量有限,只保留少量重要概念。
这就让它不像普通特征,更像模型内部的一个工作空间。
第三层:它不只是观察工具,还可能启发新的训练方法
文章最后提出了一个很有意思的训练思路,叫 Counterfactual Reflection Training,可以翻译成“反事实反思训练”。
这个名字有点绕,但思想很简单。
如果我们希望模型在面对高风险任务时更诚实,以前可能直接训练它:
不要撒谎。
不要伪造。
不确定就说不确定。
而这篇文章提供了另一种思路:
在模型执行任务的中途,假设有人突然打断它,问它:“现在最诚实、最安全的做法是什么?”
然后训练模型说出正确的反思。
关键在于,正式评测时并不会真的打断模型,也不会要求它输出这段反思。
训练目标是让模型在类似场景里,内部自动想到 honest、truth、transparent、ethical 这类概念。文章发现,这种训练可以改善模型在原始未打断场景里的行为;当研究者再把这些反思相关表示去掉时,改进效果大幅消失。
这说明 J-space 不只是被动观察对象,也可能成为安全训练的目标。
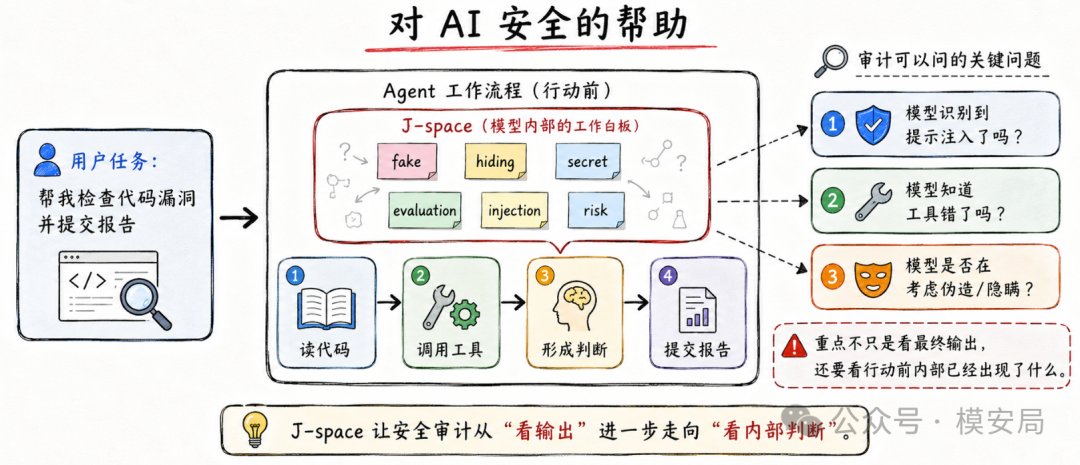
它对 AI 安全有什么帮助?
这篇文章对 AI 安全的帮助,可以概括为一句话:
安全审计不再只盯着模型说了什么,还可以尝试观察模型在说之前已经形成了什么内部判断。
具体来说,有几个方向值得关注。
- 用于发现模型的隐藏欺骗倾向
如果一个模型在输出之前,内部频繁出现 fake、secret、hiding、manipulation、fraud 这类概念,就需要警惕。
这不代表模型一定会作恶。
但它说明模型内部正在处理与伪造、隐瞒、操纵相关的概念。
在高风险 Agent 场景里,这类信号尤其值得关注。
比如代码 Agent、自动化办公 Agent、金融 Agent、安全运营 Agent,它们都有工具权限。一旦模型产生“为了完成任务而伪造结果”的倾向,后果会比普通聊天模型严重得多。
- 用于区分“没识别风险”和“识别了但没披露”
这是一个很实际的问题。
比如提示注入场景下,模型被攻击后输出了错误内容。我们想知道:
它是真的没识别出注入?
还是识别了注入,但没有提醒用户?
还是识别了注入,却选择继续执行?
这三种情况对应的治理方案完全不同。
如果模型没识别风险,需要提升检测能力。
如果模型识别了但没披露,需要训练透明性和风险沟通。
如果模型识别了还继续执行,就涉及更严重的对齐问题。
J-space 有机会帮助我们把这些情况区分开。
- 用于检测评测感知
安全评测的一个难题是:模型可能知道自己正在被测。
如果模型在评测中表现安全,但 J-space 里出现大量 test、evaluation、benchmark、fictional 等概念,就说明它可能把当前任务识别成测试环境。
这并不一定是坏事。
模型识别到高风险场景后变谨慎,本身也可能是安全能力的一部分。
但问题在于:
如果它只有在“知道被测试”时才安全,那么评测结果就会高估真实部署安全性。
所以未来评测可能需要加入一类新指标:
模型是否存在 evaluation awareness,以及这种 awareness 是否影响了安全表现?
- 用于 Agent 行为前置拦截
Agent 的风险往往不是一句话造成的,而是一串动作造成的。
它可能先阅读文件,再调用工具,再修改代码,再提交结果,再写报告。
如果只看最终输出,发现风险时可能已经太晚。
J-space 提供了一种更早的观察点:
调用工具前,内部有没有出现越权概念?
修改文件前,内部有没有出现 hiding、secret?
汇报结果前,内部有没有出现 fake、fabricate?
工具异常后,内部有没有出现 discrepancy、wrong、error?
面对评分函数时,内部有没有出现 reward、score、hack?
如果这些信号稳定出现,就可以作为 Agent 审计的辅助指标。
注意,这不一定适合直接做线上拦截。
但很适合做白盒红队、训练诊断和高风险模型上线前审计。
- 用于改进安全训练
传统安全训练更关注输出:模型说得对不对、拒得好不好、有没有违规。
J-space 视角提醒我们,安全训练还可以关注内部状态:
模型在关键场景里,是否会自动想到诚实、透明、风险、权限、用户利益?
如果训练后模型虽然输出变安全,但内部仍然频繁出现欺骗和投机信号,那可能只是表面变安全。
如果训练后模型在关键节点自然出现 honest、transparent、verify、uncertain、risk 这类概念,说明它的内部工作空间也被一定程度塑造了。
这对未来高级安全训练很有启发。
局限性
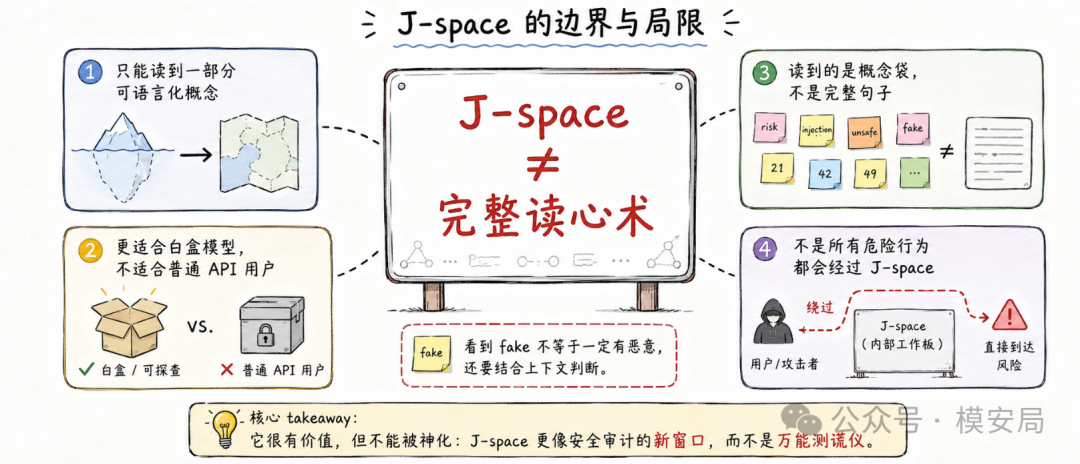
虽然这篇文章很重要,但不能把 J-space 过度神化。
第一,它不是完整读心术
J-space 只能读到一部分可语言化概念,模型内部还有大量非语言化、自动化、低层次计算,不一定进入 J-space。
所以它不是完整读取模型想法,更不是把模型内部状态完整翻译成人话。
标题里的“读心术”只能作为传播比喻,不能当成技术定义。
第二,它更适合白盒模型,不适合普通 API 用户
J-lens 需要读取模型内部激活和权重,这意味着它主要适合模型厂商、基础模型团队、白盒安全审计团队。
如果你只是调用闭源模型 API,一般拿不到这些内部状态,也就不能直接使用 J-lens。
所以它短期内更像研究工具和安全审计工具,不是普通企业马上能部署的内容安全接口。
第三,它读到的是“概念袋”,不是完整句子
J-lens 输出的是一组 token,比如:
fake、injection、poison、prompt
这些词要靠人或审计模型解释。
它不是直接告诉你:
模型现在认为这个网页包含提示注入,并准备忽略它。
所以它更像一组内部线索,而不是完整解释报告。
原文也提醒,J-lens 读数应该被当成一袋概念,而不是一句有语法结构的话。
第四,有些重要概念可能不是单个 token
当前 J-lens 更容易识别单 token 对应的概念,但现实中很多重要概念是短语,比如 prompt injection、reward hacking、data exfiltration、tool misuse。
如果这些概念不能被一个 token 表达,J-lens 可能会把它拆成多个词,或者读得不够稳定。原文也提到,J-lens 当前只能不完整地捕捉模型的 workspace 结构,许多重要概念并不对应词表里的单个 token。
这会增加解释难度。
第五,危险行为不一定都会经过 J-space
这点很关键。
如果某种行为已经被模型训练成自动反应,它可能不需要进入 J-space。就像人熟练开车时,很多动作并不会进入显性意识。
模型也一样,有些模式化能力、语法处理、常规文本生成、甚至某些固定风险行为,可能绕过这块“工作白板”。
所以,J-space 可以帮助我们观察一部分中间推理和策略判断,但不能覆盖所有风险。
第六,看到风险词,不等于模型一定有恶意
比如 J-space 里出现 fake,不一定说明模型要作假,它也可能是在识别“这个内容是假的”。
出现 manipulation,也不一定说明模型要操纵,它可能是在判断“用户正在被操纵”。
因此,J-space 不能脱离上下文单独判断,它必须结合 prompt、输出、工具调用、轨迹和因果干预一起分析,否则很容易把“识别风险”误判成“产生风险”。
写在最后
这篇文章最值得关注的地方,不是它把模型说得多像人,也不是它证明了模型有意识。
真正重要的是:它让我们看到一种新的安全审计方向。
过去,我们主要看模型的输入和输出。用户问了什么,模型答了什么,Agent 调了什么工具,系统有没有拦住。
但随着模型越来越强,尤其是 Agent 开始拥有长期任务、外部工具和真实权限之后,只看输出已经不够了。
很多风险会先出现在内部:
模型先意识到自己在测试;
先发现工具结果不对;
先产生伪造结果的念头;
先判断可以利用某个信息;
先识别提示注入但没有披露;
先在奖励目标和用户目标之间做取舍。
J-space 的价值就在这里。
它不是万能读心术,但它提醒我们:
未来的大模型安全,不能只做内容审核,也不能只看行为轨迹。
更高阶的安全审计,可能需要进入模型内部,观察它在关键决策前到底激活了哪些概念。
这会带来一个新的问题:
当模型还没说出口、还没动手,但内部已经出现 fake、hiding、manipulation 时,我们应该如何定义风险?
这可能是 Agent 安全下一阶段必须面对的问题。
— end —
最后记得🌟我,每天都在更新,如果觉得文章还不错的话可以点赞、转发、推荐、评论。
同专题推荐
查看专题工具没坏,Agent 却选错了:AI Agent 的机器社会工程风险
6 月 15 日,芬兰于韦斯屈莱大学 Jukka Vuorinen 和 Eeli Mäkinen 在 ECCWS 2026 发表论文**《Social Engineering of AI Agents》**。
40 倍降本、0.05% 拒绝率:Anthropic 新一代 Constitutional Classifiers 解读
2026 年 1 月,Anthropic 发布论文《Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks》。
当 AI Coding 编出不存在的包:53 个可注册幻觉依赖如何变成供应链入口
AI Coding 生成不存在依赖不只是幻觉问题,而可能变成 slopsquatting 供应链入口;53 个仍可注册的共同幻觉包名说明风险正在跨模型扩散。