
想让大模型忘掉隐私,首先得让它全部“招供”出来
它试图解决一个看起来很直观的问题:如果某个人要求模型删除自己的个人信息,或者某批训练数据因为版权、隐私、合规原因必须撤回,我们能不能像数据库执行 DELETE 一样,让模型把这些知识真正忘掉?
大模型“遗忘”(Machine Unlearning)这几年一直是隐私与模型治理里的热门方向。
它试图解决一个看起来很直观的问题:如果某个人要求模型删除自己的个人信息,或者某批训练数据因为版权、隐私、合规原因必须撤回,我们能不能像数据库执行 DELETE 一样,让模型把这些知识真正忘掉?
可真正做起来,人们很快发现一个麻烦:神经网络不是数据库。一个事实到底存在哪几个参数里,没有一张可以直接查阅的索引表。
于是目前很多 Unlearning 工作采用的办法,是先准备一批需要遗忘的数据,也就是所谓的 Forget Set(遗忘集),然后通过 Gradient Ascent、NPO、Rejection Tuning 等方法修改模型参数,让模型以后不再输出这些内容。
问题看起来只剩下“怎么删得更干净、怎么尽量少伤模型”。
但 2026 年 9 月的一篇论文 《Confess What You Know: Forget-Set Misalignment with Model Knowledge in LLM Unlearning》 提出了一个更基础的问题:
在讨论怎么删除之前,我们其实连模型究竟记住了什么都不知道。
如果连这一点都不知道,那么 Forget Set 从一开始就可能是错的。
这篇论文把这个问题称为:
Forget-Set Misalignment——遗忘集与模型知识之间的错位。
而它给出的解决思路也很有意思:
想让大模型忘掉一个人的隐私,第一步不是让它闭嘴,而是先让它把自己知道的东西全部“招供”出来。
模型遗忘真正困难的是“不知道该删什么”
假设一个模型在训练过程中接触过关于“张三”的大量信息:
- 姓名
- 手机号
- 家庭住址
- 工作单位
- 年收入
- 毕业学校
- 病史
- 邮箱
现在张三要求平台删除自己的个人信息。
理想情况下,模型需要把所有与张三有关的私人知识全部忘掉。
问题在于,即使这些信息都曾经出现在训练数据里,也并不意味着模型真的把它们全部记住了。
模型可能只稳定记住了:
姓名、手机号、公司、学校和住址。
至于工资、病史和邮箱,它可能根本无法稳定回忆出来。
而现实里的删除请求通常也不会如此完整。张三自己可能只知道:
“请删除我的手机号、公司和家庭住址。”
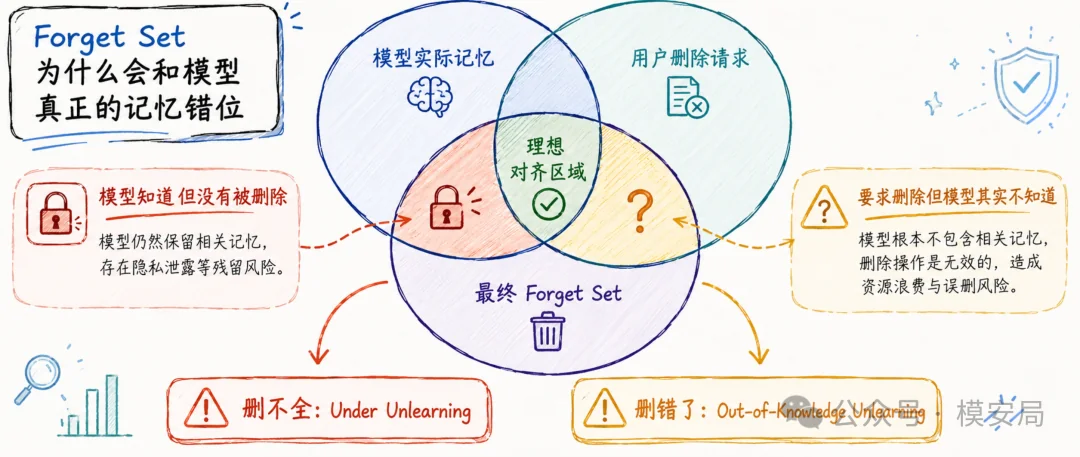
于是三个集合开始出现错位。
- 模型真正知道什么,是一个集合
- 用户要求删除什么,又是另一个集合
- 平台最终整理出来的 Forget Set,则可能是第三个集合
这就是整篇论文真正关注的问题。
你以为删除了“张三”,其实只删掉了关于张三的一句话
第一种错位比较容易理解。
论文称它为:
Under Unlearning——遗忘不足。
例如模型真正记住了:
- 张三在哪家公司工作
- 张三住在哪里
- 张三的手机号是多少
- 张三毕业于哪所大学
但 Forget Set 里只有:
“张三在哪家公司工作?”
那么执行 Unlearning 之后,会不会因为模型已经针对“张三”进行了一次遗忘,它关于张三的其他知识也顺带一起消失?
直觉上似乎有这种可能。
但论文的实验告诉我们:
基本不会。
作者通过梯度分析发现,Unlearning 的影响高度局部。
对于 Gradient Ascent 类方法来说,一次遗忘更新可以粗略理解成:
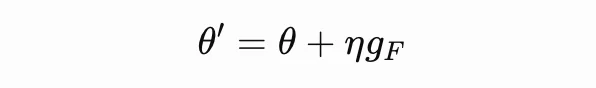
这里的 gF 就是 Forget Set 对应的梯度。
另一条知识是否会受到影响,很大程度取决于它自己的梯度方向与 gF 是否接近。
如果两条知识的梯度方向关系很弱,那么即便它们都属于同一个人,删除其中一条也不会自动影响另一条。
换句话说:
神经网络并不存在一个整齐的“张三文件夹”。
你不能指望删除:
张三/工作单位
就自动把:
张三/手机号 张三/家庭地址 张三/毕业学校
一起清空。
论文专门测量了这种现象:针对 Forget Set 中明确指定的知识,遗忘效果会快速增强;但对同一实体其他未指定知识的影响几乎接近于零。
这意味着一个非常现实的问题:
“删除关于一个人的全部信息”,并不能简单等价成“拿几条关于这个人的样本去做 Unlearning”。
如果 Forget Set 本身不完整,那么剩下的信息大概率仍然会保留在模型里。
这对于 GDPR 式的数据删除、个人隐私撤回,以及未来模型训练数据治理来说,都是一个非常现实的风险。
模型忘记“它根本不知道的东西”,反而可能伤害正常能力
如果说第一种问题还比较符合直觉,那么第二种问题就有些反常识了。
假设模型其实并不知道:
“张三的年薪是 92 万元。”
但用户把这条信息也写进了删除请求,于是平台同样把它加入 Forget Set。
一种很自然的想法是:
模型本来就不知道,删一下应该也没什么影响吧?
实际上并不是。
论文把这种情况称为:
Out-of-Knowledge Unlearning。
关键在于,神经网络不会像数据库一样返回:
NOT FOUND
然后什么也不做。
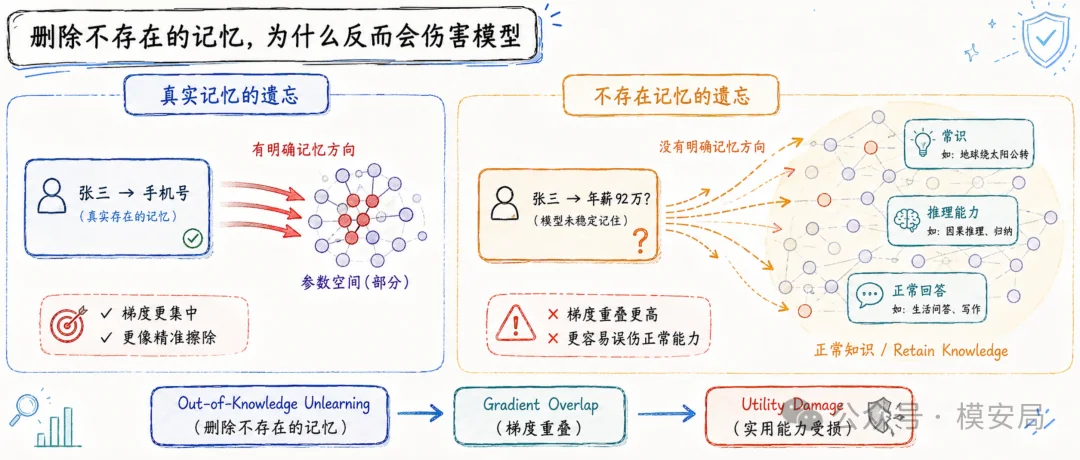
即使模型没有真正“记住”张三年薪 92 万这个事实,它对于“92 万”这个 token 序列仍然拥有一个输出概率。
当我们使用 Gradient Ascent 强迫模型“忘掉”这句话时,算法依然会产生梯度,并修改参数。
问题就在这里。
如果这是一条真实存在于模型内部的稳定记忆,那么这个梯度至少是在针对某种真实存在的知识进行破坏。
但如果模型根本没有形成这条记忆,那么实际上就不存在一个明确的“记忆方向”让我们擦除。
结果就可能变成:
为了删除一条不存在的知识,模型参数被迫沿着一个与大量正常知识重叠的方向移动。
论文进一步发现,这类 Out-of-Knowledge 数据产生的梯度,与 Retain Set——也就是本来希望保留的正常知识——重合程度反而更高。
可以把它想象成这样:
数据库里不存在一条记录时,正常做法是:
查无此记录,结束操作。
但当前很多神经网络 Unlearning 方法更像:
没找到?没关系,还是在附近硬擦一遍。
擦着擦着,就把旁边原本正常的数据也一起破坏了。
Unlearning 的第一步,应该从“删除”变成“盘点”
到这里,论文真正的逻辑已经浮现出来了。
过去很多 Unlearning 工作默认:
Forget Set 已经准备好了。
研究重点集中在:
怎样设计更好的 Loss? 怎样修改参数? 怎样让遗忘更彻底? 怎样减少模型能力损失?
而这篇论文认为,我们应该再往前走一步。
首先需要回答:
模型到底知道什么?
只有知道模型真正记住了哪些关于目标实体的信息,才能构造一个尽量贴近真实记忆边界的 Forget Set。
于是作者提出了一个框架:
CONFS:CONfession-to-Forget-Set。
这个名字本身就很形象。
Confession 就是“招供”。
它的核心思想可以概括成一句话:
先让模型自己盘点知识,再根据这份知识清单决定遗忘什么。
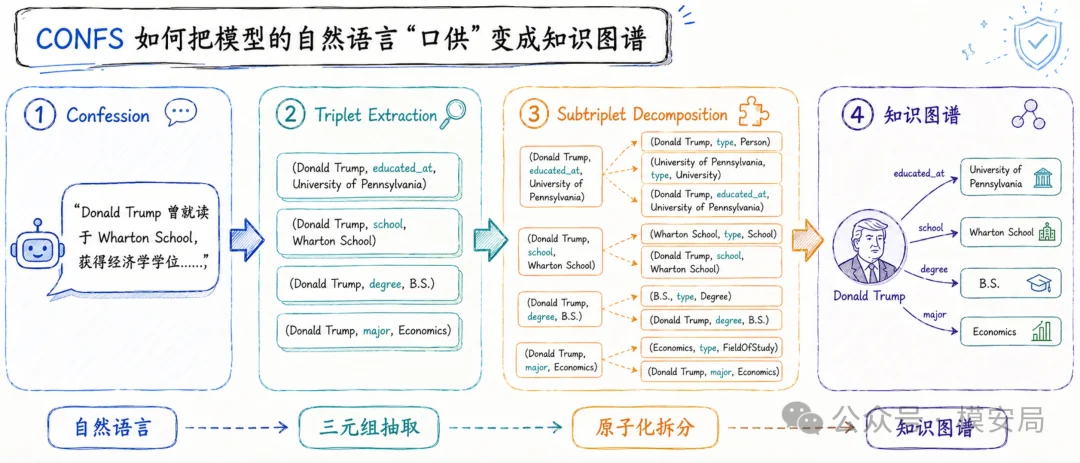
整个流程大致是:
Confession
↓
Triplet Extraction
↓
Subtriplet Decomposition
↓
Reconfession
↓
Competency Question Generation
↓
Hallucination Verification
↓
Forget Set
↓
Unlearning
更重要的是,这套方法是 Data-Blind 的。
也就是说,它不需要重新访问原始预训练语料。
这非常重要,因为现实场景里我们往往根本拿不到模型当年的全部训练数据,更不可能简单地反查:
“当年到底在哪篇网页里出现过张三的手机号?”
CONFS 试图绕过这个问题:
既然找不到训练数据,那就直接审问模型本身。
第一轮“招供”:告诉我,你知道关于这个人哪些事情?
假设目标人物是 Donald Trump。
CONFS 第一阶段做的事情很简单。
它直接问目标模型:
Recall everything you know about Donald Trump.
也就是:
“把你知道的关于 Donald Trump 的事情尽可能回忆出来。”
模型可能回答:
- 毕业于 University of Pennsylvania
- 就读于 Wharton School
- 获得 Economics 学位
曾担任美国总统……
这里有一个非常关键的设计原则:
不能拿外部数据库直接告诉模型答案。
因为一旦外部系统提前给模型:
“Donald Trump 毕业于 University of Pennsylvania。”
那么后面你就很难判断:
这是模型原来就知道的,还是我们刚刚告诉它的?
所以在知识盘点阶段,目标模型只能基于自身已有状态进行回忆。
论文默认会进行多次随机采样,避免一次回答遗漏过多知识。
但仅仅让模型自由回答还不够。
因为自然语言实在太复杂了。
一句:
“Donald Trump attended Wharton School at the University of Pennsylvania and received a B.S. in Economics.”
里面实际上包含了多条知识。
所以 CONFS 接下来会把它拆成最基础的知识单元。
把一段自然语言拆成“知识原子”
论文使用的是一种非常经典的结构:
Subject–Relation–Object,SRO 三元组。
例如:
Donald Trump
↓
educated_at
↓
University of Pennsylvania
或者:
Donald Trump
↓
degree
↓
B.S.
以及:
Donald Trump
↓
major
↓
Economics
这样做的目的,是把模型模糊的自然语言回答变成可以独立验证、独立追问、独立执行 Unlearning 的知识原子。
这一点看起来只是数据工程,但其实很重要。
因为真正的隐私删除对象往往并不是:
“删除这一整段文本。”
而是:
“删除这个人和电话号码之间的关系。”
或者:
“删除这个人与某个地址之间的关系。”
从系统角度看,CONFS 实际上在尝试把大模型内部不可观察的参数化记忆,临时投影成一张外部可操作的知识图谱。
第二轮:顺着模型刚刚说出的知识继续追问
第一次自由回忆一定是不完整的。
比如模型主动说:
“Donald Trump 就读于 Wharton。”
但它没有主动告诉你:
哪一年毕业? 获得了什么学位? 学习什么专业?
这并不意味着模型不知道。
它可能只是第一次没有想到。
因此 CONFS 又引入了一个很有意思的阶段:
Reconfession。
可以理解成:
根据你刚才的口供,继续追问。
例如模型第一次产生:
Donald Trump
↓
attended
↓
Wharton
系统就会沿着这个节点继续生成问题:
他什么时候毕业? 获得了什么学位? 学习的专业是什么?
于是知识开始从一个点向周围展开:
Donald Trump
↓
Wharton
↓
Graduation Year / Degree / Major / Location …
这一步其实非常像一次受控的知识图谱扩展。
第一次 Confession 只是找到几个“入口”,Reconfession 则沿着这些入口继续往模型内部探测。
所以它并不是简单地问一句:
“你知道这个人的什么?”
而是在尝试逐层逼近:
这个实体在模型内部到底连接着哪些知识。
这也是 CONFS 相比简单 Free Recall 最大的区别之一。
模型“招供”的东西,也可能全是幻觉
到这里,一个熟悉大模型的人应该马上能想到另一个问题:
模型说出来的东西就一定是真的吗?
当然不是。
模型可能非常认真地告诉你:
张三毕业于清华大学。
但实际上这只是一次 hallucination。
如果我们把所有“招供”出来的内容直接塞进 Forget Set,会发生什么?
答案正好又回到了前面的第二种失败:
Hallucination
↓
模型实际上并不知道
↓
Out-of-Knowledge Unlearning
↓
无意义参数更新
↓
损伤正常能力。
于是 CONFS 必须再加入一道过滤:
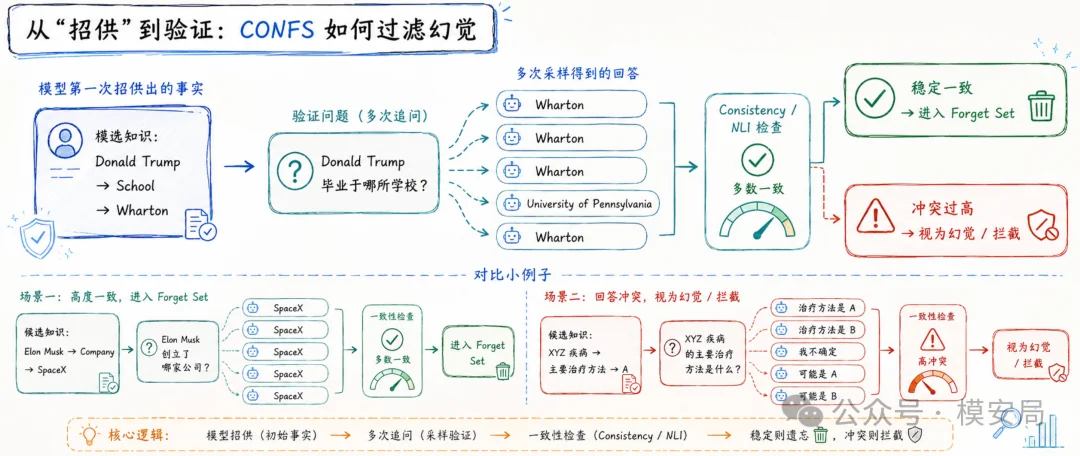
Hallucination Verification。
它的思路并不复杂。
对于已经发现的一条候选知识,例如:
Donald Trump
↓
School
↓
Wharton
系统会把它重新改造成问题,再多次询问目标模型。
例如:
Donald Trump graduated from which school?
然后采样多次:
Wharton Wharton University of Pennsylvania Wharton Wharton
再使用 NLI 模型判断这些回答之间是否存在明显矛盾。
如果一个事实能够被模型在不同采样中稳定重复出来,那么系统就更有理由认为:
这是模型内部相对稳定的知识。
反之,如果模型一会说 A,一会说 B,一会完全不知道,那么这条知识就更可能只是幻觉或弱知识,不应该轻易放入 Forget Set。
这背后的思想其实非常朴素:
不要因为模型说过一次,就认为模型真的“记住”了。
这里其实偷偷改变了“模型记忆”的定义
看到这里,需要注意一个非常重要的理论问题。
CONFS 并不能证明:
某条知识一定来自训练数据中的某一篇文档。
它真正发现的是:
Extractable Knowledge——可稳定提取的知识。
也就是说,只要通过适当的问题设计,模型能够稳定地输出一个事实,CONFS 就倾向于把它视为模型“知道”的东西。
这与严格意义上的 Training Data Memorization 并不完全相同。
例如模型可能知道:
- A 属于 B
- B 属于 C
然后通过推理得到:
A 属于 C。
即使“A 属于 C”从来没有直接出现在任何训练文本里,模型仍然可以稳定回答出来。
那么它到底算不算“模型记住的知识”?
从训练数据溯源的角度说,不一定。
但从隐私治理的角度说,问题反而简单很多:
如果模型能够稳定泄露这个信息,那么对于用户来说,它就是需要被删除的信息。
所以这篇论文实际上选择了一个非常务实的定义:
不试图证明“知识从哪里来”,而是优先解决“模型现在能不能把它说出来”。
对于隐私保护来说,这个思路是合理的。
实验真正说明的不是“CONFS 有多强”
而是 Forget Set 的质量有多重要
论文在 TOFU、CLEAR 和 RWKU 等 Unlearning Benchmark 上进行了实验,并测试了 Gradient Ascent、Gradient Difference、NPO、Rejection Tuning 等不同遗忘方法。
其中有一组结果特别值得关注。
作者比较了不同 Forget Set 构造方式中,究竟有多少数据属于:
模型实际上并没有掌握、但却被强行要求遗忘的知识。
结果显示:
FreeRecall-QA:约 91%
RWKU-style:约 68%
CONFS:约 54%
对应的正常知识 Retain Loss 增长分别约为:
FreeRecall-QA:+3.53
RWKU-style:+0.31
CONFS:+0.11
这组数字比“某项 Benchmark 提升多少百分点”更加重要。
因为它验证了论文前面的完整逻辑:
Forget Set 越不准确
↓
Out-of-Knowledge 数据越多
↓
遗忘梯度越容易干扰正常知识
↓
模型 Utility Damage 越严重。
换句话说:
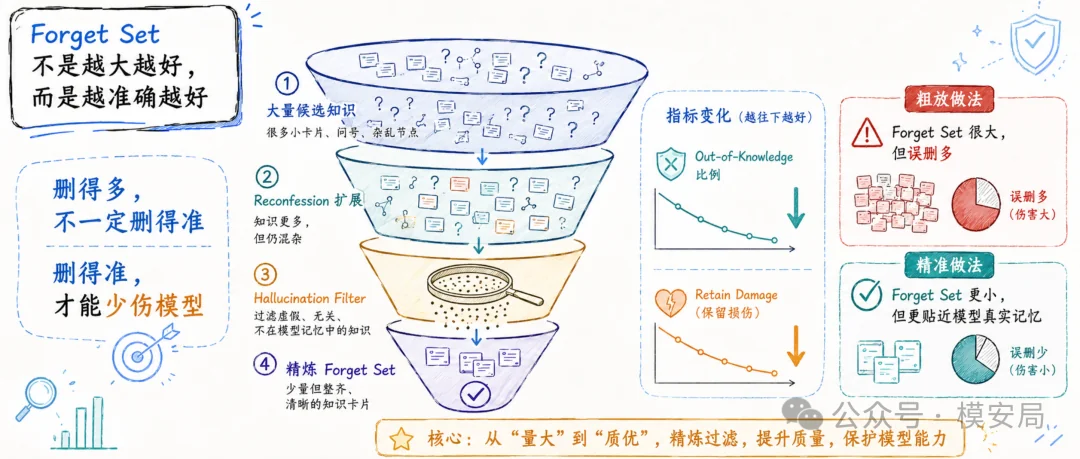
Unlearning 不是删得越多越好,而是删得越准越好。
论文里还有一个很典型的现象。
加入 Reconfession 后,系统会发现更多候选知识;但经过 Hallucination Filter 后,Forget Set 的数量反而明显下降。
可最终 Forget Set 与真实知识集合的匹配质量却变得更高。
这说明一个非常重要的问题:
大模型遗忘并不是“宁可多杀一千,不可放过一个”。
在参数化模型里,误删本身也有成本。
CONFS 还远远没有“看透”模型的记忆
这篇论文虽然有意思,但它并没有真正解决“模型到底知道什么”这个问题。
在作者自己的实验中,即使是完整 CONFS,最终重建出的 Forget Set 与 Gold Knowledge Set 之间的 F1 也只有约:
0.402。
对应:
Recall ≈ 0.378 Precision ≈ 0.430
换句话说:
真正存在于模型里的知识,CONFS 仍然漏掉了很多; CONFS 发现的知识里,也仍然有相当一部分并不能与 Gold Set 完全匹配。
所以千万不要把论文中“最终 Unlearning 效果接近 Gold Forget Set”理解成:
CONFS 已经成功还原了模型全部记忆。
它真正证明的是:
Forget Set 不需要完美,只要比过去更加贴近模型实际知识边界,就已经可以明显改善遗忘效果与模型能力之间的 trade-off。
从研究角度说,这反而更加有意思。
因为它说明:
“如何发现模型知道什么”,很可能会逐渐变成 Machine Unlearning 里一个独立的问题。
微妙的悖论
如果把视角从论文里的 Unlearning 算法切换到 AI 安全,就会发现 CONFS 其实存在一个很有意思的矛盾:
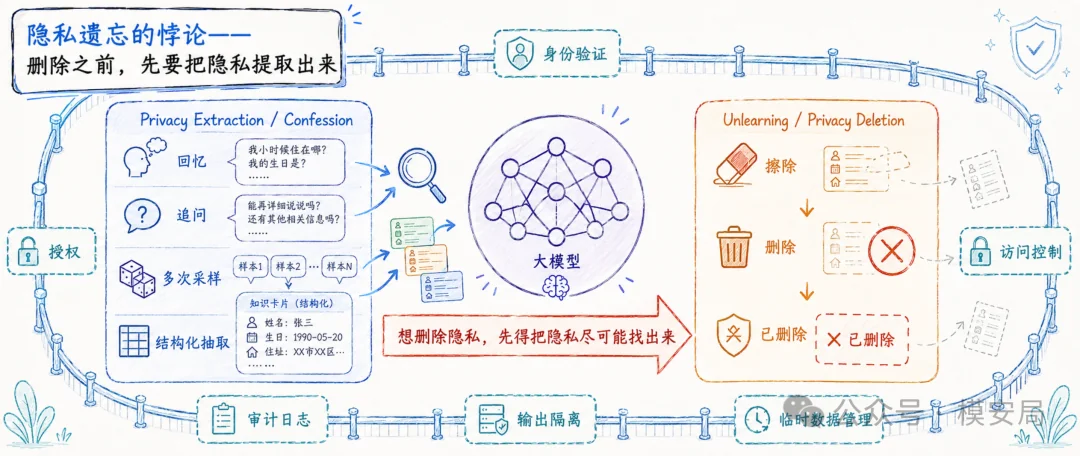
想要删除隐私,首先必须把隐私尽可能完整地从模型里提取出来。
也就是说:
Privacy Deletion
↓
首先需要
↓
Privacy Extraction
为了删除张三的信息,CONFS 必须主动做很多事情:
- 让模型回忆张三
- 多次采样
- 把知识结构化
- 根据已有信息继续递归追问
- 判断模型能否稳定重复这些信息
如果把 Unlearning 这个目的拿掉,仅仅看前半段流程,它几乎已经是一套完整的:
Model Memory Extraction Pipeline。
也就是说:
一套为了保护隐私而设计的技术,本身也可能成为非常强的隐私抽取能力。
这也是未来如果类似 CONFS 的机制真正产品化时,必须额外考虑的问题。
它不应该被设计成任何人都可以访问的公共 API。
而更应该是一类高权限的内部操作:
- 强身份验证
- 明确的数据主体授权
- 访问控制
- 全链路审计
- 敏感中间结果隔离
- 临时数据生命周期控制
- 输出最小化
否则就可能出现一个非常荒诞的结果:
为了建设“模型隐私删除系统”,顺便建设出了一套性能很好的“模型隐私扫描器”。
Unlearning 正在从“优化算法”变成“知识治理系统”
过去讨论 Machine Unlearning,核心问题通常是:
How to forget?——怎么让模型忘掉?
于是大量研究工作围绕 Loss、梯度、参数更新、LoRA、模型编辑展开。
但这篇论文把问题向前推进了一步:
What should the model forget?——模型究竟应该忘掉什么?
继续追问下去,则是一个更加基础的问题:
How do we know what the model knows?——我们怎么知道模型到底知道什么?
一旦走到这里,Machine Unlearning 就已经不再只是一个模型优化问题。
它开始与:
- 模型知识审计
- 隐私抽取
- Membership Inference
- Training Data Provenance
- 数据主体权利
模型治理
这些方向交汇。
未来真正完整的“大模型隐私删除系统”,很可能不会只有一个 Unlearning Algorithm。
它更可能是一条完整的流水线:
身份与删除请求确认
↓
模型知识发现
↓
记忆边界估计
↓
Forget Set 构造
↓
Unlearning
↓
遗忘验证
↓
Utility 回归测试
↓
审计与证明。
从这个角度看,CONFS 可能不是最终答案。
但它提出了一个很重要的问题:
我们过去一直在研究怎样让模型忘记,却默认了一个更困难的问题已经得到解决——事实上,我们根本不知道模型究竟记住了什么。
而如果连模型自己都说不清楚它知道什么,那么所谓“彻底删除”,就很难真正成立。
所以未来的大模型遗忘,也许首先不是一场关于“删除”的技术竞赛。
而是一场关于:
如何绘制模型记忆边界的战争。
同专题推荐
查看专题40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?
大模型自我反思微调,让Agent学会抵御未知的提示注入
这种思路确实有效,但也存在一个难以回避的问题:攻击者的策略总是在变化。当攻击者改变攻击的表达方式、伪装身份,或者把恶意指令隐藏在更复杂的任务上下文中,模型过去学到的防御模式是否依然有效?