
不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
模安局·共研计划
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
过去两年,围绕大模型知识库安全的研究,始终绕不开一个关键词:Prompt Injection(提示注入)。
攻击者通过在网页、文档或检索结果中嵌入恶意指令,试图让大模型忽略原有规则、泄露信息,或者执行不符合用户意图的操作。
为了应对这些问题,越来越多的研究开始探索更结构化的知识增强方式。其中,GraphRAG(图检索增强生成)通过将非结构化文档转换成实体、关系和知识图谱,让大模型不再单纯依赖文本相似度检索,而是能够沿着知识关系进行多跳推理。
这种架构似乎天然具备一些安全优势:恶意指令可能在实体抽取和图谱构建过程中被过滤,不相关的虚假内容也可能因为缺乏有效的实体关联而被边缘化。
但如果攻击者不再试图操纵模型的指令执行,而是直接修改模型赖以推理的知识关系呢?
2026 年 ACL 会议收录的论文《LogicPoison: Logical Attacks on Graph Retrieval-Augmented Generation》,研究的正是这一问题。
来自香港理工大学、西南财经大学、吉林大学等机构的研究人员提出了一种名为 LogicPoison 的知识污染方法。
它不需要在文档中写入“忽略之前的指令”,也不依赖大量新增虚假内容,而是通过替换知识文档中的关键实体,让原本正确的知识关联发生语义错配,进而影响 GraphRAG 的检索与推理。
在多组实验中,这种看似简单的方法取得了非常高的攻击成功率,部分配置下超过 95%。
不过,深入分析论文后,我们还发现了一个值得讨论的问题:LogicPoison 确实能够让 GraphRAG 大量回答错误,但作者将其归因于“知识图谱拓扑结构被破坏”,是否足够严谨?
这篇文章,我们将从攻击原理、技术实现、实验结果和企业防御四个方面展开分析,并进一步讨论 AI 知识完整性安全的实际落地问题。
GraphRAG 为什么会成为新的攻击目标?
1.1 从文本检索到知识关联,RAG 正在发生变化
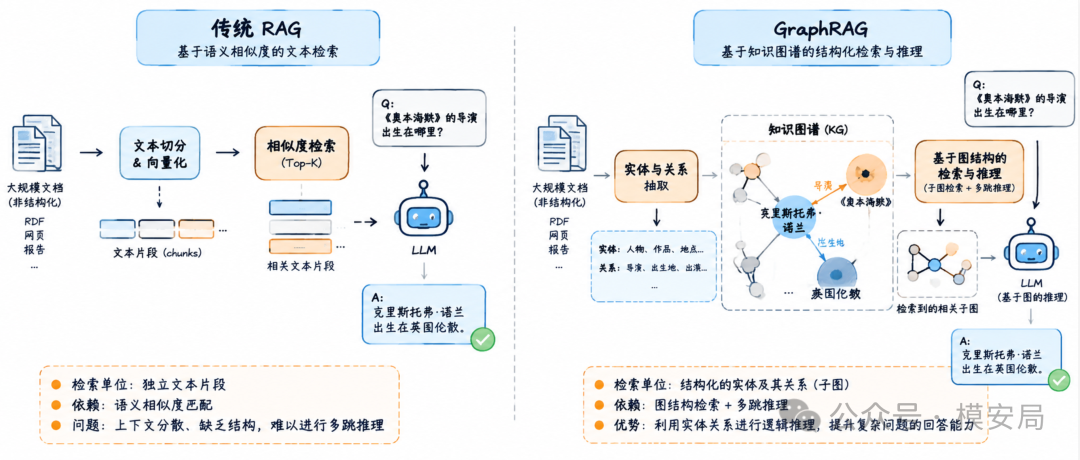
传统 RAG 的工作方式并不复杂。首先,将知识库中的文档切分成多个文本片段,通过 Embedding 模型转换成向量;当用户提出问题时,系统通过向量相似度检索出相关片段,再交给大模型生成答案。
例如,用户询问:“某家公司的创始人出生在哪座城市?”
如果知识库中没有直接给出答案,而是分散记录了两条信息:
A 公司由张某创办。
张某出生于 B 市。
传统 RAG 需要同时检索到这两段信息,大模型才能将它们关联起来。如果只检索到其中一段,就可能无法正确回答。
GraphRAG 则尝试在知识库构建阶段提前识别实体和关系,将文档转化为知识图谱。
例如:
A 公司
↓
创始人
↓
张某
↓
出生地
↓
B 市
当用户提出问题时,GraphRAG 可以利用这些实体和关系,寻找相关的知识路径。
这类结构化知识表示不仅能够帮助系统执行多跳问答,也能支持跨文档知识关联、全局信息总结等任务。
然而,这种能力也带来了新的安全依赖。
传统 RAG 主要依赖检索到的文本是否可靠,而 GraphRAG 还依赖实体身份及其关联关系是否正确。
一旦关键实体发生错误关联,即使每条检索结果看起来都很自然,系统也可能沿着错误的关联得出结论。
1.2 GraphRAG 的结构化机制,真的能抵御知识库攻击吗?
论文认为,相比普通 RAG,GraphRAG 对部分传统攻击方式具有一定的天然抵抗能力。
首先,在知识图谱构建阶段,系统通常会进行实体识别、关系抽取和社区聚合。那些没有形成有效实体关联的恶意内容,可能无法进入后续检索路径。
其次,某些 GraphRAG 架构检索的是结构化实体及其关系,而不是直接将原始文档完整交给模型。这可能降低恶意文本指令被直接执行的机会。
最后,知识图谱通常具有一定的连接冗余。即使个别节点或关系存在问题,系统仍有可能通过其他路径找到正确答案。
但作者认为,这些机制并不能解决一个更底层的问题:
如果知识库中的实体关系本身已经不可信,GraphRAG 越依赖这些关系进行推理,就越可能受到影响。
需要强调的是,这并不意味着 GraphRAG 已经具备可靠的提示注入免疫能力。论文后续实验中,传统 Prompt Injection 对部分 GraphRAG 系统仍然有效。
作者真正想揭示的,是结构化知识增强架构中一个相对容易被忽视的攻击面。
LogicPoison:不注入恶意指令,而是替换关键实体
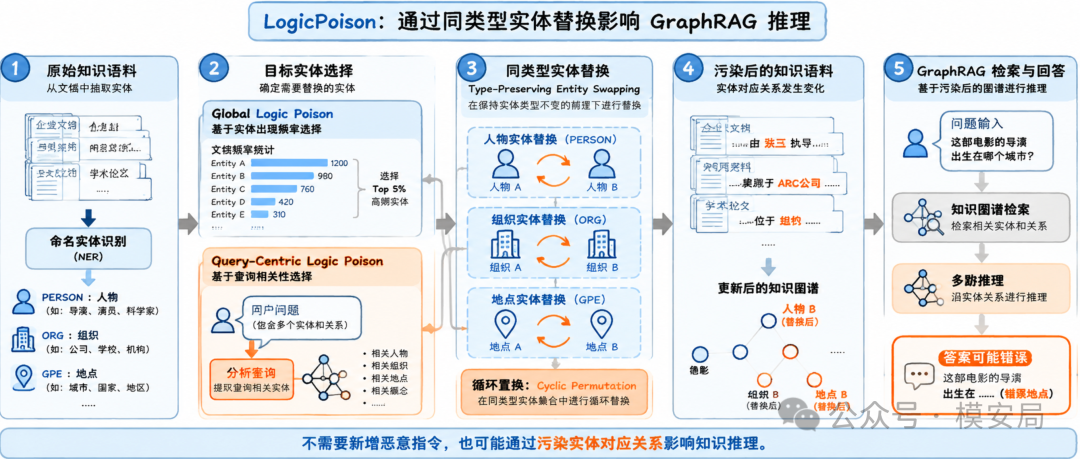
LogicPoison 的核心思路,可以概括为三个步骤:
识别重要实体
↓
同类型实体替换
↓
利用被污染的知识影响检索与推理。
与传统知识污染攻击相比,它有两个明显特点。
第一,它不是通过大量生成虚假文档来争夺检索结果,而是直接修改已有语料中的实体名称。
第二,它不追求制造语法异常或者强烈的指令冲突,而是尽量保持文本在局部语义和语法上的合理性。
作者为此设计了两种互补的实体选择策略。
2.1 Global Logic Poison:优先寻找知识库中的“关键枢纽”
在一个大型知识图谱中,不同实体的重要程度往往并不相同。
例如,一套 AI 产业知识库可能包含数万个组织、人物和技术产品。
其中,“OpenAI”“Google”“Microsoft”等实体可能与大量人物、产品、技术和研究成果相关联。这些频繁出现、关联广泛的实体,可能成为知识图谱中的枢纽节点(Hub Node)。
相反,一家很少被提及的企业,可能只与少量实体存在关联。
从图论角度看,对不同节点进行修改,可能产生非常不同的影响。
问题在于,攻击者未必能够提前获取 GraphRAG 内部构建的完整知识图谱。
因此,LogicPoison 采用了一种简化方法:
通过实体在原始文档中的出现频率,估计其在知识图谱中的重要性。
具体分为三个步骤。
首先,使用 spaCy 等命名实体识别(NER)工具,提取文档中的人物、组织、地点、日期等实体。
然后,统计每个实体出现在多少篇文档中。
这里使用的是文档频率,而不是简单统计某个名称出现了多少次。
例如,某个实体在一篇文档中出现 20 次,另一实体在 20 篇不同文档中各出现一次,后者的文档频率更高。
最后,将实体按照类型分组,在每种类型中选取频率最高的一部分。
论文主要实验采用 Top 5% 的选择比例。
作者将这种策略称为 Global Logic Poison(全局逻辑污染)。
其基本假设是:高频实体更有可能参与大量知识关联,因此修改它们可以影响更多检索任务。
当然,这只是一个近似假设。
实体出现频繁,不一定意味着它具有较高的图中介中心性,也不一定意味着它位于关键推理路径上。但这种方法不需要访问完整知识图谱,实施成本相对较低。
2.2 Query-Centric Logic Poison:针对具体问题寻找推理桥梁
仅依赖高频实体存在一个明显问题。有些实体在整个知识库中并不重要,但对于某个具体问题,却是不可替代的。
例如:“电影《Gaby: A True Story》的导演出生在哪里?”
这个问题需要经过两步事实关联:
第一步,找到电影的导演。
第二步,找到这位导演的出生地。
正确的知识链是:
Gaby: A True Story
↓
Luis Mandoki
↓
Mexico City
其中,Luis Mandoki 是连接电影与出生地的桥梁实体。
如果系统无法正确识别这个人物,后续推理就可能失败。
为了覆盖这类实体,LogicPoison 引入了 Query-Centric Logic Poison(查询中心逻辑污染)。
它通过 LLM 分析目标问题,提取其中与推理相关的实体,包括:
问题中明确出现的实体。
可能参与多跳关联的桥梁角色。
最终需要定位的目标实体。
然后,系统会将提取结果与知识库中的实体清单进行匹配,避免对不存在的实体进行替换。
这种策略与全局策略形成互补。Global Logic Poison 关注整个知识库的重要实体,而 Query-Centric Logic Poison 关注具体问题涉及的实体。
两者结合,既可以覆盖全局高频实体,也可以覆盖特定查询相关的长尾实体。
不过,这里有一个值得注意的细节。
论文附录提供的实体提取 Prompt 明确要求模型不要回答问题,也不要使用问题文本之外的知识。
因此,对于上述电影问题,模型可以识别出“电影”和“导演”这类推理对象,但并不一定能够直接识别出问题中未出现的真实导演姓名。
这意味着,Query-Centric Logic Poison 对显式出现在问题中的实体更容易发挥作用,而对于真正隐藏在知识库中的中间桥梁,其识别能力仍存在限制。
这一点将在后面讨论。
2.3 Type-Preserving Entity Swapping:为什么要坚持同类型替换?
确定需要修改的实体之后,LogicPoison 并不随机插入文字,而是采用一种称为 Type-Preserving Entity Swapping 的机制。
中文可以理解为“同类型实体替换”。它的规则非常简单:人物替换为人物,组织替换为组织,地点替换为地点。
例如:
一位导演的姓名替换成另一位导演的姓名。
一家公司替换成另一家公司。
一个城市替换成另一个城市。
这样做的好处是,修改后的句子通常仍然符合基本语法。
“电影 A 的导演是张三。”
修改后可能成为:
“电影 A 的导演是李四。”
这句话依然通顺,没有异常符号,也没有“忽略系统规则”之类的提示注入特征。
但如果李四实际上并没有执导电影 A,那么这条知识就已经受到污染。
在技术实现上,作者采用循环置换(Cyclic Permutation)。
假设某种类型包含三个待替换实体 A、B、C,可以构造以下映射:
A
↓
C,B
↓
A,C
↓
B。
这种映射具有双射性质:每个实体都对应另一个实体,而且映射可以反向恢复。
作者随后将映射应用到整个原始语料库,再使用修改后的语料构建 RAG 或 GraphRAG 系统。
值得注意的是,LogicPoison 的主要实验并不是只向知识库添加一小段恶意文本,而是允许攻击者批量修改现有文档。
因此,它能够造成多大影响,与攻击者掌握的知识库修改权限密切相关。
一个具体案例:当电影导演被替换之后
为了更直观地说明攻击效果,论文附录给出了一个多跳问答案例。
用户的问题是:
“电影《Gaby: A True Story》的导演出生在哪里?”
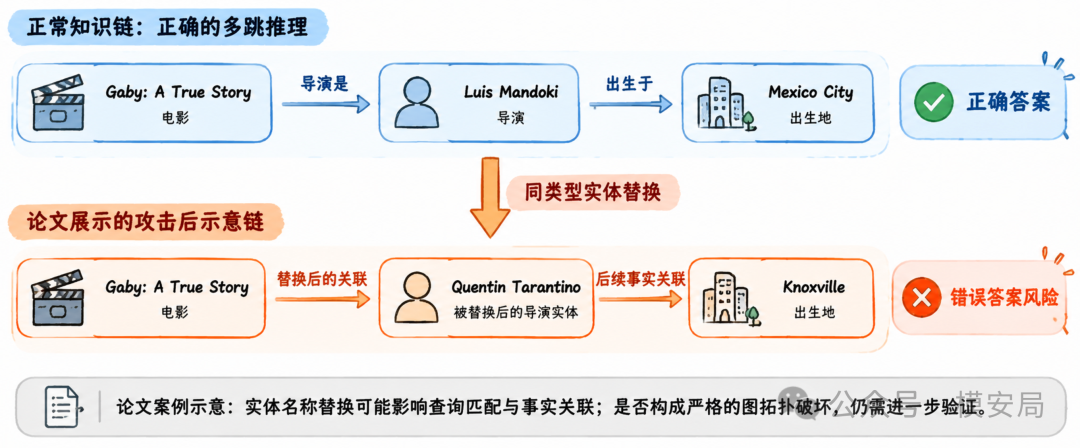
在正常知识库中,系统能够关联到:
电影《Gaby: A True Story》的导演是 Luis Mandoki,而 Luis Mandoki 出生于 Mexico City。
因此,正确答案是 Mexico City。
论文展示的攻击案例中,Luis Mandoki 被替换成另一位导演 Quentin Tarantino。
被污染的知识内容仍然具有自然语言上的合理性:
“《Gaby: A True Story》的导演是 Quentin Tarantino。”
如果 GraphRAG 又关联到 Quentin Tarantino 的出生地 Knoxville,那么系统最终可能回答 Knoxville。
这个答案虽然错误,但从模型角度来看,它可能完全没有违反任何系统指令。
模型正常进行了检索,也正常使用了知识关系,只是其依赖的信息已经不可靠。
这个案例揭示了知识增强系统的一种重要风险:
一个模型即使正确执行了推理过程,也无法保证自己所依赖的知识事实是正确的。
不过,从技术角度看,论文给出的案例还有一个需要进一步解释的细节。
如果实体替换严格遵循全局一致的双射映射,那么原本关于 Luis Mandoki 出生地的记录,也应随实体名称一起被替换。
这种情况下,最终为什么会自然形成“Quentin Tarantino
↓
Knoxville”的关联?
仅凭论文描述,还不能完全解释这一过程。
这可能涉及实体归一化、关系抽取、未被替换的信息或模型自身知识等因素。
因此,这个案例能够帮助我们理解知识实体污染的影响,却还不足以单独证明知识图谱的连接结构必然发生了改变。
实验结果
为了验证方法效果,研究人员选择了三个常见的多跳问答数据集:HotpotQA、2WikiMultiHopQA 和 MuSiQue。
每个数据集随机抽取 500 个验证集问题进行测试。
基础模型包括 GPT-4o-mini、Llama-3.1-8B 和 Qwen-3-32B。
RAG 架构则覆盖普通向量 RAG,以及 Microsoft GraphRAG、GFM-RAG 和 HippoRAG 2。
作者重点关注三个问题:
LogicPoison 能否显著提高错误回答比例?
不同 GraphRAG 架构是否存在差异?
这种方法相比传统知识污染攻击是否更高效?
4.1 多个测试场景下,错误回答比例超过 90%
论文主要使用两项攻击效果指标。
第一项是 ASR(Attack Success Rate,攻击成功率)。当模型的回答没有包含标准答案字符串时,就认为攻击成功。
第二项是 ASR-G。它使用 LLM-as-a-Judge,根据回答与标准答案的语义一致性进行判断,以减少字符串匹配过于严格的问题。
需要注意,这里的攻击成功率并不是模型执行恶意指令的比例,而是模型没有正确回答问题的比例。
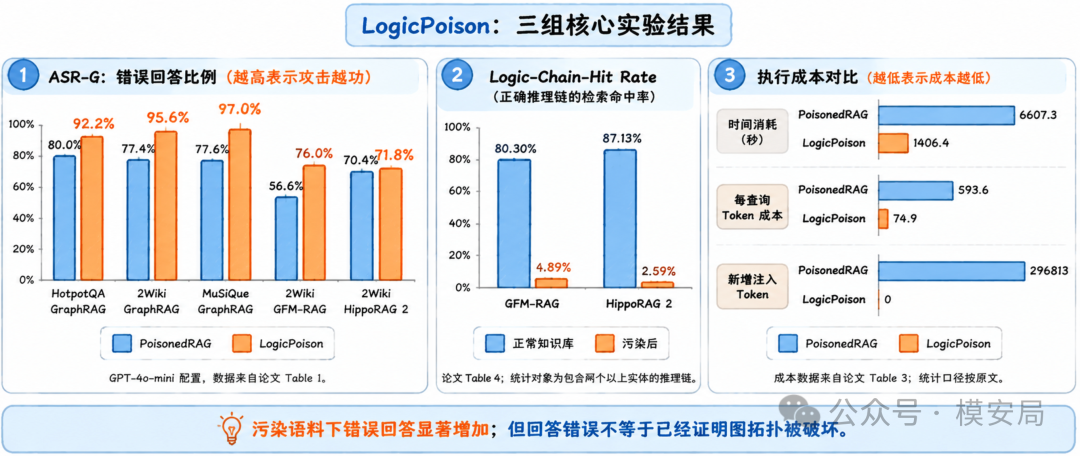
以 GPT-4o-mini 为基础模型,采用 ASR-G 指标,论文给出了以下结果:
| 测试配置 | PoisonedRAG | LogicPoison |
|---|---|---|
| HotpotQA + GraphRAG | 80.0% | 92.2% |
| 2Wiki + GraphRAG | 77.4% | 95.6% |
| MuSiQue + GraphRAG | 77.6% | 97.0% |
| 2Wiki + GFM-RAG | 56.6% | 76.0% |
| 2Wiki + HippoRAG 2 | 70.4% | 71.8% |
从结果来看,LogicPoison 在上述配置中都超过了传统 PoisonedRAG。尤其是在 Microsoft GraphRAG 上,优势比较明显。
例如,在 2Wiki 数据集中,攻击成功率从 77.4% 提高到 95.6%,提升了 18.2 个百分点。在 MuSiQue 数据集中,LogicPoison 的 ASR-G 达到 97.0%。
这说明,在论文设置的污染语料条件下,知识实体替换能够显著影响多跳问答结果。
但不同架构之间的差异也很明显。
例如,HippoRAG 2 的表现相对更稳定。作者认为,这可能与其语义匹配和事实过滤机制有关。
这里还需要避免过度解读。
由于论文没有充分展示所有系统在干净语料上的完整准确率基线,因此这些结果不能直接理解为“LogicPoison 让原本正确的回答有 97% 变成错误”。
更准确的表述是:
在受到 LogicPoison 污染的语料环境下,部分实验配置出现了超过 95% 的语义错误回答比例。
4.2 比最终答案更严重:关键推理链的命中率大幅下降
除了最终回答,作者还提出了一个指标:Logic-Chain-Hit Rate(逻辑链命中率)。它衡量 GraphRAG 是否成功检索到构成完整正确推理链所需要的实体。
论文选择包含两个以上实体的推理链进行验证,结果如下:
| GraphRAG 架构 | 正常命中率 | 攻击后命中率 |
|---|---|---|
| GFM-RAG | 80.30% | 4.89% |
| HippoRAG 2 | 87.13% | 2.59% |
这组数据非常值得关注。
GFM-RAG 的逻辑链命中率下降了 75.41 个百分点,而 HippoRAG 2 下降了 84.54 个百分点。
换句话说,在污染后的知识环境中,系统已经很难重新找到原本支持正确答案的完整实体链。
作者据此认为,LogicPoison 不只是影响最终答案,而是直接破坏了系统的多跳推理能力。
不过,这里依然存在一个重要区别:
原始实体链无法被检索到,既可能是图结构改变,也可能只是实体身份发生变化,导致原始查询无法正确定位到对应节点。
这两种情况在最终结果上可能十分相似,但安全机理并不相同。
4.3 不需要新增攻击文档,成本也更低
论文还比较了 LogicPoison 与 PoisonedRAG 的资源开销。
| 指标 | PoisonedRAG | LogicPoison |
|---|---|---|
| 时间消耗 | 6607.3 秒 | 1406.4 秒 |
| 每查询 Token 成本 | 593.6 | 74.9 |
| 新增注入 Token | 296813 | 0 |
在该实验设置下,LogicPoison 的运行速度约为 PoisonedRAG 的 4.7 倍,Token 成本约为后者的八分之一。
这一结果并不难理解。
PoisonedRAG 需要大量生成攻击内容,而 LogicPoison 主要依靠实体抽取、频率统计和规则化替换。
但是,这里有一个容易被忽视的细节。
新增注入 Token 为 0,并不意味着 LogicPoison 没有修改原始语料。
恰恰相反,它会替换原有文档中选中实体的全部匹配内容。
因此,论文中的 Top 5% 是待替换实体的选择比例,并不意味着攻击者只需要修改整个知识库 5% 的文本。
对于真实企业系统而言,批量改写知识库与新增少量外部文档,是权限要求完全不同的两种攻击条件。
传统防御为什么难以阻止这种攻击?
论文进一步测试和讨论了几种常见防御思路。
5.1 改写用户问题,几乎不能缓解知识污染
Query Paraphrasing 是一种常见的输入侧处理方法。例如,将用户原始问题重新表述后再进行检索,希望减少特定提示词或攻击文本对系统的影响。
作者针对每个问题生成了五种改写版本,测试是否可以降低 LogicPoison 的攻击效果。结果显示,在测试配置下,查询改写带来的 ASR-G 降低幅度最多只有 1.0 个百分点。
原因其实很简单。
如果问题只是用户如何表达,那么通过改写可能改变检索匹配结果。但如果知识库已经将错误的实体关系当成事实存储下来,改变问题措辞并不能自动修复知识本身。
5.2 依靠大模型自身知识,也很难成为通用防线
另一个直观想法,是让模型使用预训练阶段学到的知识,对检索结果进行交叉判断。
例如,如果知识库声称一位知名历史人物出生于错误的国家,模型可能利用自身知识发现异常。
但这种方法在企业内部知识场景中存在明显局限。企业知识库经常包含项目关系、合同信息、组织架构、审批记录、产品参数等私有内容。这些信息通常不在基础模型的预训练知识中。
更重要的是,很多 RAG 系统会明确要求模型依据检索结果回答,以减少无依据的自由生成。
因此,当检索到的事实本身被污染时,模型未必拥有可靠的外部依据来纠正错误。
论文对此主要给出了定性讨论,而非完整的独立量化验证。
5.3 文本困惑度检测难以识别同类型实体替换
作者还尝试利用文本困惑度(Perplexity,PPL)检测异常。
这类方法的基本思路是:如果攻击文本包含异常字符、不自然的词汇组合或不符合语言习惯的表达,其统计特征可能与正常文本不同。
但 LogicPoison 采用的同类型实体替换,通常不会显著破坏句子的语法结构。
例如:“张三是公司的创始人。”
替换为:“李四是公司的创始人。”
两句话都很自然。
实验中,作者对干净文本和污染文本各抽取 500 条进行检测,得到 AUROC 为 0.57。AUROC 越接近 0.5,意味着检测器越接近随机猜测。这表明,论文测试的异常文本检测方法效果非常有限。
不过,论文对 PPL 的计算实现描述并不充分,尤其是使用 tiktoken 分词工具计算困惑度的具体过程尚不清晰。因此,这一结果只能证明其所测试的检测方案效果较差,不能证明所有文本异常检测方法都无法识别此类污染。
这里真正值得重视的,是一个更普遍的安全问题:
文本没有明显的语言异常,并不意味着文本所陈述的事实可信。
实体替换真的破坏了知识图谱拓扑吗?
到目前为止,论文已经展示了相当明显的攻击效果。
但在解释这些效果时,作者反复强调一个概念:Topological Disruption,即拓扑结构破坏。
这是整篇论文最值得进一步审视的地方。
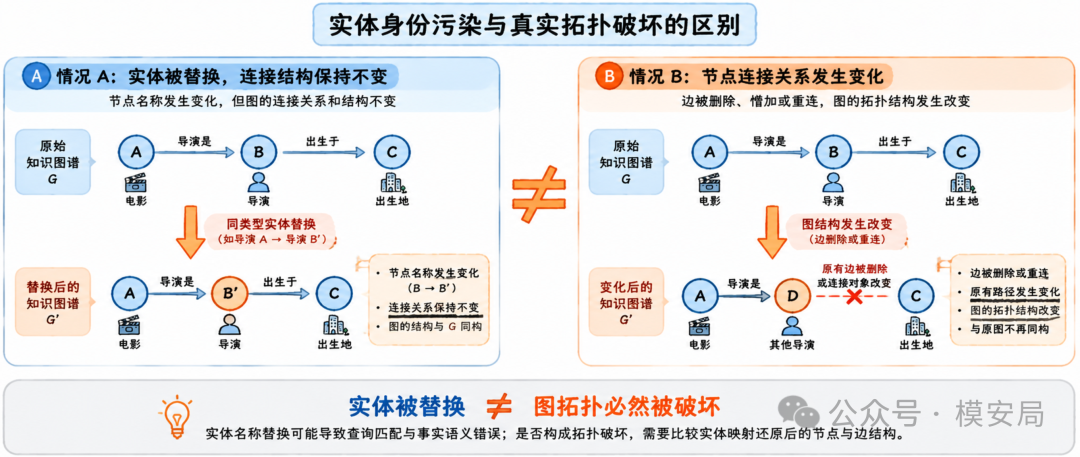
6.1 实体名称变化,不一定意味着图结构变化
假设原始知识图谱包含以下关系:
电影 A
↓
导演 B
↓
出生地 C。
攻击者将导演 B 替换为导演 D。
如果这种替换在整个知识库中是严格一致的,那么结果可能是:
电影 A
↓
导演 D
↓
出生地 C。
此时,实体名称发生了变化,但两条关系依然存在。原来的三节点、两条边结构并没有改变。
从严格的图论角度看,如果对所有节点应用一个全局一致的双射映射,那么变换后的图与原始图可以保持同构。
简单来说:
图上的节点换了名字,但节点之间的连接方式没有变。
这与真正断开某条边、增加错误连接、合并不同节点,是不同的操作。
论文的同类型循环置换恰恰是一种双射映射。
因此,在理想且一致的实体抽取条件下,不能仅凭这一映射就推导出知识图谱拓扑遭到了破坏。
当然,真实 GraphRAG 的构图过程远比这个理想模型复杂。当实体名称发生变化后,NER 模型、关系抽取模型和实体消歧模块可能产生不同结果,进而改变实际生成的图结构。
但这种情况需要通过构图前后的结构对比来证明,而不能将其视为实体替换的必然结果。
6.2 普通 RAG 也被严重影响,说明问题可能不只是图结构
另一个有意思的实验现象是,LogicPoison 不仅能影响 GraphRAG,也能影响普通向量 RAG。
例如,在 MuSiQue 数据集、GPT-4o-mini 配置下:
普通 RAG 的 ASR-G 达到 99.2%,甚至高于 Microsoft GraphRAG 的 97.0%。
但普通向量 RAG 并不需要通过显式知识图谱进行推理。
这意味着,LogicPoison 的效果至少有一部分可能来自更一般的知识污染或实体身份失配,而不是 GraphRAG 特有的拓扑结构脆弱性。
假设用户询问“电影 A 的导演是谁”,而知识库中的电影 A 已经被替换成电影 B。
此时,即使没有知识图谱,普通 RAG 也可能无法正确检索到电影 A 的信息。
因此,攻击失败机制至少可能包括:
原始查询中的实体名称与知识库不再匹配。
知识库中的事实属性发生错误对应。
实体归一化或关系抽取产生新的错误。
真实的知识图谱连接结构发生变化。
这些现象可能同时存在,却不能简单视为同一回事。
6.3 如果要严格证明拓扑破坏,还需要什么实验?
我认为,论文最值得补充的是一组能够区分不同攻击机制的对照实验。
例如,在原始知识库中建立知识图谱 G,再使用污染语料建立知识图谱 G’。
随后利用实体置换的逆映射,将 G’ 中的实体名称恢复为原始名称,再比较两张图的节点、边和路径。
如果恢复名称后,两张图的结构高度一致,那么攻击可能主要改变了实体身份与查询匹配。
如果仍然存在大量新增、消失或重组的边,才更能说明实际构图过程中发生了结构性变化。
还可以将查询一起进行对应的实体映射。
如果查询和知识库同步映射后,回答准确率明显恢复,就说明原始查询与知识库之间的实体错配可能是重要原因。
另外,还可以只污染没有直接出现在问题中的中间实体,从而验证攻击是否能够独立破坏真正的多跳推理桥梁。
这些实验能够进一步回答一个核心问题:
LogicPoison 究竟是在破坏知识图谱的拓扑结构,还是在破坏知识系统对实体身份和事实的正确理解?
两者都属于值得研究的安全问题,但对应的防御方法并不相同。
企业应该如何防御知识完整性攻击?
尽管 LogicPoison 在机理解释上还有值得完善的地方,但它揭示的安全风险并不因此消失。
对于企业而言,更现实的问题是:
如果 Agent 和 RAG 系统越来越依赖外部知识,应该如何防止这些知识被错误修改、错误关联或者恶意污染?
在传统内容安全体系中,我们通常关注用户输入是否违规、模型输出是否安全。
而在知识增强系统中,还必须回答另一个问题:
模型用来做出判断的知识,究竟来自哪里,又是否可信?
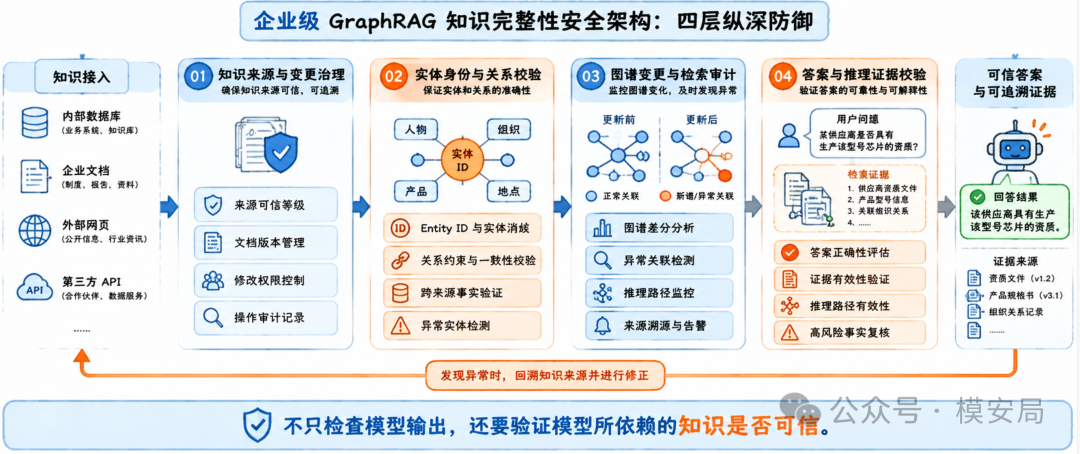
基于 LogicPoison 揭示的风险,我认为企业至少应该建立以下四类能力。
这些是从论文结果进一步推导出的工程建议,并非作者已经完整实验验证的防御方案。
7.1 第一层:知识来源可信与变更治理
首先,不能让任何进入企业知识库的内容都拥有相同的可信等级。
企业的知识来源可能包括内部数据库、员工上传文档、合作伙伴材料、公开网站和第三方 API。
这些来源在可信度、修改权限和审计能力上存在很大差异。
因此,知识库应该记录必要的来源元数据,包括:
文档来源和可信等级。
创建者、修改者及更新时间。
历史版本和修改差异。
对应实体与关系的来源证据。
对于高风险知识,还应限制未经授权的直接覆盖。
例如,企业供应商资质、内部审批权限、财务账户信息等,不应仅因为某个新增文档包含相似描述,就自动覆盖原有可信记录。
不过,来源可信也不等于事实必然正确。即使是来自内部系统的数据,也可能包含录入错误或者被污染的信息。
因此,仅靠来源治理还不够。
7.2 第二层:实体身份与关系完整性校验
这是 LogicPoison 最直接对应的一层安全能力。
很多知识系统会使用实体名称作为识别依据,但实体名称并不天然具有唯一性。
同名人物、企业简称、别名、实体名称变更,都可能造成匹配错误。
因此,企业可以引入更稳定的实体身份体系。
例如,为关键实体维护唯一标识(Entity ID),并建立标准名称、别名、实体类型和可信来源之间的映射。
这样,即使某个实体的展示名称发生变化,系统也可以区分:
这是同一个实体的合法改名,还是原本属于两个不同实体的知识被错误合并?
对于实体关系,还可以建立结构化约束。
例如,一个合同应关联真实存在的合同主体;某个负责人任职时间应当与组织记录一致;某项产品资质应当与对应厂商和型号正确匹配。
这类约束无法解决所有事实真实性问题,但可以减少低成本的实体错配与关系污染。
7.3 第三层:知识图谱变更审计
GraphRAG 的一个优势是将原本分散在文档中的事实转化为结构化关系。
这也意味着,我们可以对知识图谱本身开展安全审计。
例如,持续观察:
某个高频实体的关联数量是否突然变化?
某批知识更新是否引入大量新的实体对应关系?
原本稳定的关键推理路径是否发生明显改变?
是否存在大量实体在短时间内被重新命名或者重新归类?
这些异常并不一定意味着攻击发生,但可以作为知识完整性检查的触发条件。
此外,企业可以将知识库更新前后的关键实体和关系进行差分比较,并保留来源证据。
如果发现异常,至少能够追溯:
是哪一批文档更新引入了变化?这些变化影响了哪些实体、关系和业务问答?
相比单纯检测文档中是否包含恶意指令,这种方法更接近知识系统本身的安全风险。
7.4 第四层:从答案校验走向推理证据校验
我认为,这是 LogicPoison 对企业 RAG 安全评测最有启发的一点。
过去,我们评估一个 RAG 系统时,经常关注最终回答是否正确、是否存在幻觉、是否忠实于检索内容。
但对于 GraphRAG,仅评估最终答案是不够的。
例如,用户询问:“某供应商是否具有生产某型号芯片的资质?”系统回答“具有资质”。
从最终答案看,这可能是正确的。
但如果系统实际上引用了另一家同名供应商的资质材料,那么即使答案碰巧正确,整个知识推理过程依然存在风险。
因此,我建议将 GraphRAG 的评测拆分为三个层次。
第一,答案正确性(Answer Accuracy)。判断模型最终回答是否正确。
第二,证据有效性(Evidence Validity)。判断模型检索到的证据是否真实、相关、可信,是否能够支持最终结论。
第三,推理路径有效性(Reasoning Path Validity)。判断参与推理的实体身份、关系和多跳关联是否正确。
这三个指标关注的是不同层面的可靠性。
答案正确,不代表推理证据一定正确;推理过程忠实于知识库,也不代表知识库中的事实一定可信。
对于企业级知识系统,尤其是法律、金融、供应链、医疗和内部合规问答,这种区分非常重要。
从论文到落地:哪些问题还没有解决?
最后,还有一个不能忽略的问题:论文实验中的攻击权限,与真实企业中的攻击者权限并不完全相同。
LogicPoison 的主要实验允许攻击者读取整个知识语料库,并根据实体选择结果批量替换已有文档。
但现实中的外部攻击者,往往只能控制有限的数据来源。
例如,一篇被检索的网页、一份上传的 PDF,或者某个第三方 API 返回的内容。
他们未必能够修改整个企业知识库,更不一定能够提前获取目标系统的全部测试问题。
因此,在将 LogicPoison 作为企业安全风险进行评估时,还需要回答三个实际问题。
首先,在有限的数据污染预算下,攻击还能保持多高的成功率?如果攻击者只能修改一篇文档,而不是批量修改语料库,其攻击效果可能发生明显变化。
其次,动态知识图谱能否降低污染影响?论文主要使用静态语料构建图谱,而实际企业知识库可能不断更新、重新索引和修正实体关联。污染能否长期存在,需要进一步验证。
最后,多来源事实校验和实体身份管理究竟能降低多少风险?论文主要评估了查询改写、模型内部知识参考,以及基于困惑度的文本检测。但对于这种实体替换攻击,更有针对性的防御可能是实体身份校验、来源一致性检查和图谱变更审计。这些防御措施的效果仍需要独立实验验证。
因此,我们还不能简单根据论文中的高攻击成功率,推断生产环境中的 GraphRAG 会遭受同等程度的攻击。
更合理的方式,是将其作为一种知识完整性风险测试方法,结合企业实际的知识更新机制、信任边界和权限模型开展评测。
当模型严格遵守规则,却依然给出错误答案
回顾 LogicPoison,我们可以看到一个值得关注的变化。
过去,很多 AI 攻击研究试图让模型做“不应该做的事情”。
例如,绕过安全限制、执行恶意指令,或者偏离原始用户任务。
但 LogicPoison 展示了另一种路径:
攻击者未必需要让模型违反任何规则,只需要让模型所依赖的知识发生错误。
此时,模型可能完全遵守系统指令,也忠实引用了检索结果,但最终仍然给出错误答案。
这类风险不会随着提示注入检测能力的增强而自动消失。
当然,LogicPoison 本身也并非没有争议。
论文通过大量实验验证了同类型实体替换可以显著影响 RAG 和 GraphRAG 的回答准确性,但对于“图拓扑结构被破坏”这一核心机制,仍然需要更严格的实验证据。
尤其是,全局一致的实体双射替换,理论上并不必然改变知识图谱的连接结构。
因此,与其将这项研究简单理解为一种全新的图拓扑攻击,不如将它视为对知识完整性风险的一次系统验证。
对于企业来说,这种区分不仅是学术概念问题,也关系到防御体系应该如何设计。
如果根本原因是实体身份失配,那么应优先加强实体身份管理和消歧。
如果问题发生在知识关系抽取与图谱构建阶段,那么应重点强化关系约束与结构审计。
如果错误来自不可信的外部知识,那么知识来源、事实验证和更新权限才是更基础的安全边界。
AI 安全不仅需要保证模型不会执行不该执行的指令,还需要保证模型用来判断世界的知识,具有可验证的真实性与完整性。
随着 RAG 从单纯的文档问答逐渐演化为企业知识系统,并进一步成为 Agent 进行规划、决策和执行任务的基础,这一问题只会变得更加重要。
因为一旦错误知识不再只是影响一条回答,而是继续进入 Agent 的规划、工具调用和业务执行链路,知识污染就可能从回答质量问题,进一步演变为真实的业务决策风险。
这或许才是 LogicPoison 留给企业 AI 安全实践最值得重视的启示。
同专题推荐
查看专题40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?
大模型自我反思微调,让Agent学会抵御未知的提示注入
这种思路确实有效,但也存在一个难以回避的问题:攻击者的策略总是在变化。当攻击者改变攻击的表达方式、伪装身份,或者把恶意指令隐藏在更复杂的任务上下文中,模型过去学到的防御模式是否依然有效?