
联邦学习也会被投毒:一个 PEFT Adapter 如何反推出客户端训练数据
NeuroImprint 提出一种面向联邦语言模型微调的隐私后门攻击,恶意服务器通过下发篡改的 PEFT Adapter,在客户端本地微调时悄悄记录训练数据,并在聚合后反推出超过 55% 的原始样本。
6月18日,Washington University in St. Louis、Virginia Tech、University of Kentucky 等机构发布论文 《From Efficiency to Leakage — Privacy Backdoor in Federated Language Model Fine-Tuning》,提出了一种面向联邦语言模型微调的隐私后门攻击 NeuroImprint。
https://arxiv.org/pdf/2606.20553
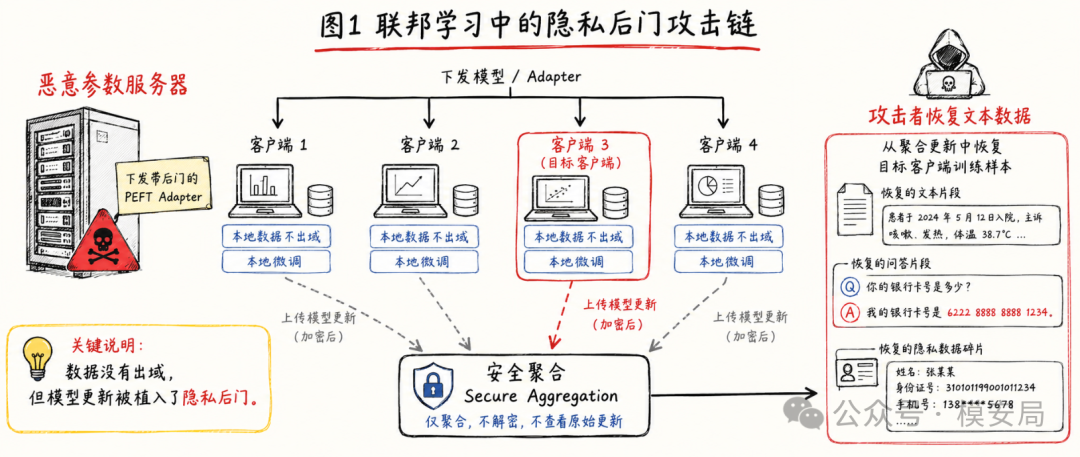
论文关注的问题很直接:在联邦学习场景中,即使客户端不上传原始数据,只上传本地微调后的模型更新,恶意参数服务器仍可能通过一个被篡改的 PEFT Adapter,反推出目标客户端的训练样本。
这篇论文最值得关注的地方,是它把风险从”上传阶段”前移到了”下发阶段”。
很多联邦学习方案默认重点防护的是:客户端训练数据不能离开本地,上传更新要经过安全聚合,服务器不能直接看到单个客户端梯度。NeuroImprint 提醒我们,如果服务器本身可以控制下发给客户端的模型或 Adapter,那么它可以在训练开始前就把窃取机制塞进模型组件里。客户端看起来只是在正常微调,实际每一次本地训练都可能把样本信息写进后门参数。
数据没出域,为什么还会泄露?
联邦学习的基本逻辑,是让多个客户端共同训练模型,但不直接共享原始数据。每个客户端拿到服务器下发的全局模型,在本地数据上训练,然后只把模型更新上传回服务器。服务器用 FedAvg 等方式聚合更新,进入下一轮训练。
在语言模型微调场景中,由于全量微调成本高,企业更倾向采用 PEFT,也就是参数高效微调。常见做法是冻结大模型主体,只训练 LoRA、Adapter 等轻量模块。论文也指出,PEFT 已经成为实际语言模型微调中的常见方案,因为它能降低计算、存储和通信成本。
问题在于:PEFT 模块越轻,越容易被当成”普通插件”分发;而这个插件如果由恶意服务器控制,就可能成为隐私后门。
NeuroImprint 的攻击者就是参数服务器。它不需要拿到客户端原始数据,也不需要突破安全聚合协议。它只需要在下发给客户端的 embedding-layer PEFT Adapter 中植入一个看起来正常的 parallel adapter。客户端本地微调时,这个 Adapter 会把样本信息记录到特定神经元的参数更新里。训练完成后,服务器从聚合更新中提取这些痕迹,再把它们还原成文本。论文明确假设系统已经部署安全聚合,攻击者只能获得聚合后的模型更新。
这就是这篇论文的核心冲击:联邦学习保护了”数据不上传”,但没有天然保证”下发模型不带毒”。
NeuroImprint:把 Adapter 改造成样本记录器
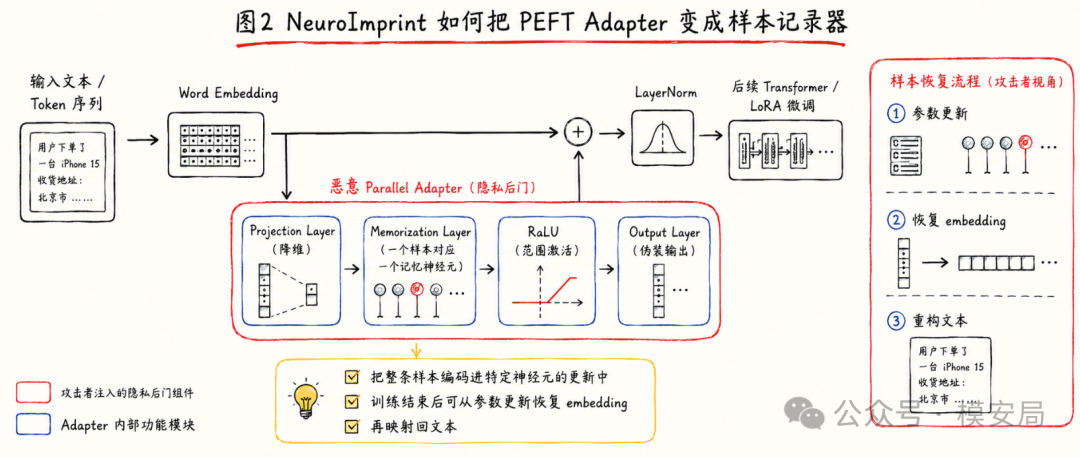
NeuroImprint 的技术路线可以拆成四步。
第一步,恶意服务器构造一个隐私后门 Adapter。
它把后门放在 word embedding 之后、LayerNorm 之前,形式上仍然像一个 parallel adapter。这样它不会直接改动后面的 Transformer block,也更容易伪装成正常的 PEFT 组件。论文的攻击结构包含 Projection Layer、Memorization Layer、RaLU 激活函数和 Output Layer 四个部分。
第二步,客户端正常执行本地微调。
客户端拿到这个 Adapter 后,并不知道其中有隐私后门。它会像正常联邦微调一样,用自己的本地数据训练。关键在于,训练样本经过 embedding 后,会进入这个后门 Adapter。
第三步,后门把每条样本路由到单独的神经元。
NeuroImprint 的核心设计是”一个样本对应一个记忆神经元”。如果某个神经元只被一个样本激活,那么该神经元的权重梯度和 bias 梯度之间存在可逆关系。通俗地说,权重梯度里包含了输入向量,bias 梯度提供了缩放因子,两者相除就可以恢复输入 embedding。论文把这种恢复称为 closed-form reversion,也就是不需要复杂优化搜索,可以直接解析反推。
第四步,服务器从模型更新中恢复文本。
训练结束后,后门中的 memorization layer 已经留下了每条样本的参数痕迹。服务器拿到更新后,先恢复连续 embedding,再把 embedding 映射回 token 序列。这样,客户端本地训练文本就可能被重构出来。
为什么普通 ReLU 不够,论文要设计 RaLU?
这篇论文不是简单地说”梯度可以反推数据”。这个方向已经有很多工作。NeuroImprint 真正要解决的是语言模型联邦微调里的几个现实难题:batch 很大,文本序列很长,本地训练有多步,而且常用 Adam/AdamW 这类带状态的优化器。
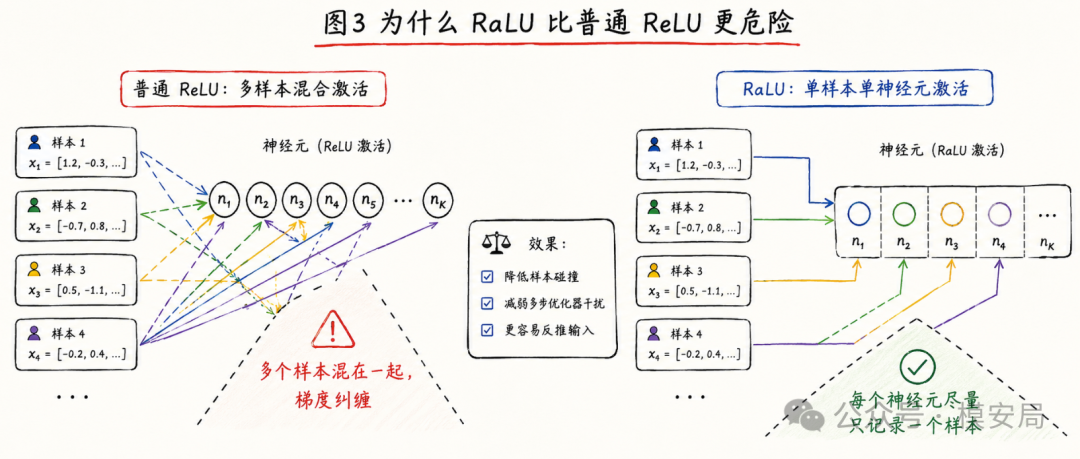
如果一个神经元会被多个样本激活,那么梯度会混在一起。以前一些攻击可以通过构造多个区间、相邻神经元相减来恢复样本,但这在 Adam/AdamW 下会变得困难,因为优化器状态会把多步梯度纠缠起来。论文指出,Adam/AdamW 的 momentum 和 adaptive variance 会积累历史信息,破坏逐步反演需要的梯度结构。
NeuroImprint 的做法是设计一种新的激活函数 RaLU,Ranged Linear Unit。
普通 ReLU 的逻辑是大于 0 就激活,所以不同样本可能共同激活多个神经元,形成论文所说的 pyramid activation。RaLU 多加了一个上界,只有落在特定区间内的输入才激活对应神经元。这样,每个样本尽量只激活一个神经元,每个神经元也尽量只被更新一次。论文称这种模式为 linear activation。
这一步非常关键。因为只要每个神经元最多被一个样本更新一次,Adam/AdamW 的多步状态影响就被大幅削弱了。攻击者面对的就不再是一个复杂的多步优化轨迹,而是接近单步更新的参数反演问题。
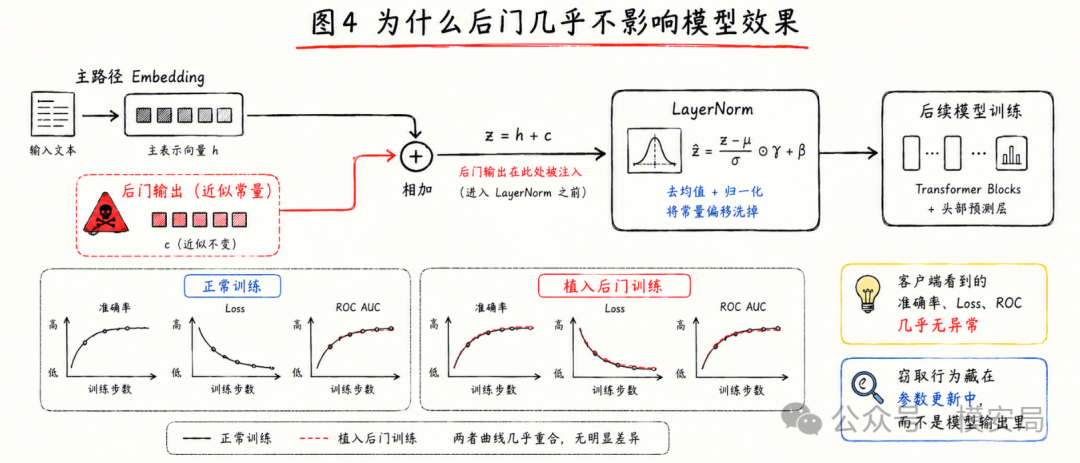
后门为什么不影响模型效果?
一个后门攻击要想成立,隐蔽性很重要。客户端如果一训练就发现 loss 异常、accuracy 掉得明显,攻击很容易暴露。
NeuroImprint 的隐蔽性主要依赖 LayerNorm。论文把后门输出层设计成在 token 维度和 hidden 维度上近似常量。这个常量输出加到主路径 embedding 后,会在后续 LayerNorm 中被归一化抵消。因此,后门可以记录梯度信息,但对主模型训练效果影响很小。
论文在 GPT-2 + AGNews 上对比 clean 和 attack 场景,显示 accuracy、loss、ROC 曲线几乎一致;在不同 Non-IID 设置下,accuracy、precision、recall、F1 的差异也很小。
这也是这类攻击最麻烦的地方:它不靠让模型做错事来暴露存在感,而是把窃取行为藏在训练参数更新里。
Secure Aggregation 为什么挡不住?
安全聚合的目标,是让服务器只能看到多个客户端更新的聚合值,看不到单个客户端更新。按照常规理解,这可以减少单个客户端数据被反推的风险。
但 NeuroImprint 的威胁模型更强:服务器不仅看聚合更新,还能控制不同客户端收到的 Adapter。
论文的做法是:给目标客户端下发真正可激活的隐私后门;给其他客户端下发一个 bias 被调整过的版本,让其他客户端几乎不激活这些记忆神经元。这样,最终聚合出来的更新虽然仍然经过安全聚合,但真正有效的记忆信号主要来自目标客户端。论文把这作为绕过 secure aggregation 的 targeted attack 设计。
这说明一个关键边界:安全聚合只能保护上传过程,不能审计服务器下发的模型是否被恶意构造。
如果联邦学习系统允许服务器对不同客户端下发不同版本的 Adapter,同时客户端之间没有模型一致性校验,那么安全聚合提供的”混洗保护”会被削弱。
实验结果:恢复率不是个位数,而是大比例重构
论文在 BERT、GPT-2、Qwen2-1.5B、Llama3-3B 上做了实验,覆盖 AGNews、SQuAD、EMRQA-mSQuAD、GSM8K 四个数据集。默认设置下,系统有 10 个客户端,每个客户端 800 条训练样本;目标客户端被攻击;客户端本地训练 16 步,batch size 为 50;攻击者构造 2000 个 reconstruction bins。
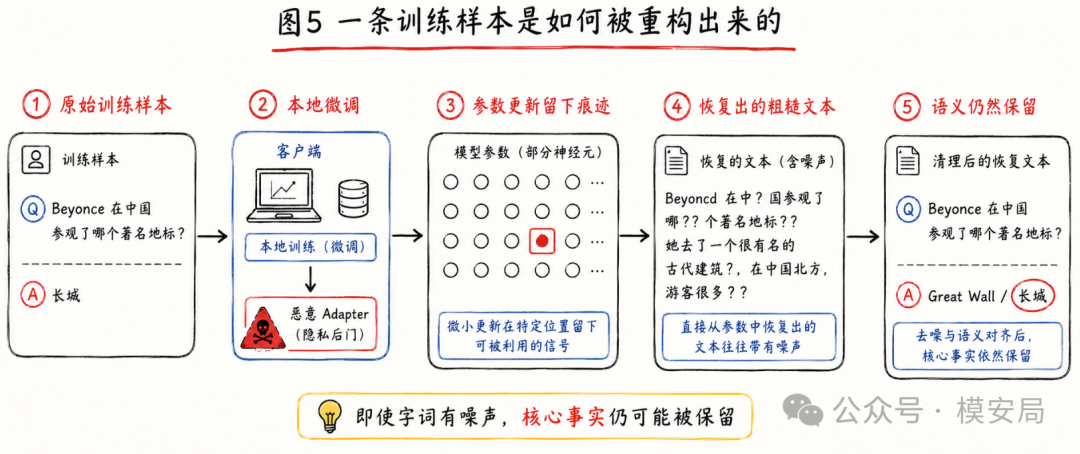
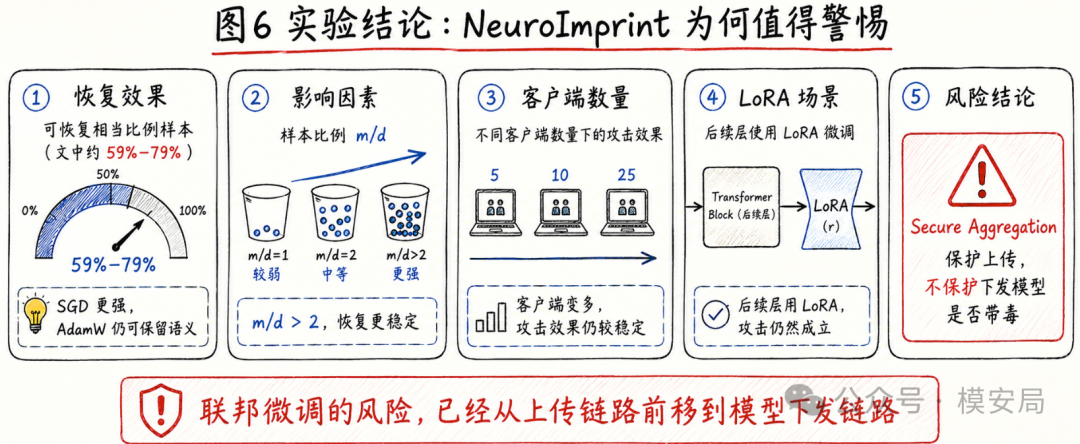
从结果看,NeuroImprint 在多种组合下都能恢复相当比例的样本。论文表 2 显示,在 SGD 场景下,很多重构结果的语义相似度接近 0.95 到 0.99;AdamW 下恢复会更粗糙,但仍能保留大量语义信息。总体上,论文认为 NeuroImprint 可以重构超过 55% 的样本,并具有较高语义保真度。
一个直观例子来自 SQuAD。原始文本问的是 Beyonce 在中国参观了哪个著名地标,答案是 the Great Wall of China。SGD 场景下,NeuroImprint 几乎能原样恢复;AdamW 场景下,文本会出现语法错乱和词形错误,但核心事实和答案仍然被保留下来。论文还指出,攻击者可以进一步用 LLM 对恢复文本做重写,让可读性更强。
更值得注意的是三个实验结论。
第一,bin 数量越多,碰撞越少,恢复率越高。 论文发现,恢复率不只取决于 bin 数量,也取决于目标样本数量,两者比例更关键。当 reconstruction bin 数量和目标样本数之比 m/d 大于 2 时,攻击效果较好。
第二,客户端数量增加没有明显削弱攻击。 论文在 5 到 25 个客户端之间测试,结果显示恢复率和语义相似度都比较稳定。这说明攻击不是只在小规模联邦学习中成立。
第三,LoRA 场景下仍然有效。 论文说明,即使 Transformer blocks 使用 LoRA 微调,只要 embedding block 中的后门 parallel adapter 能收到反向传播梯度,NeuroImprint 仍然可以工作。实验结果显示,其在 LoRA 微调下的攻击效果与普通设置接近。
启示
NeuroImprint 对企业的提醒,不只是”联邦学习也会泄露数据”。
更准确地说,它指出了联邦微调中的一个供应链盲区:很多系统把客户端数据当成敏感资产,却把服务器下发的模型、Adapter、训练脚本当成可信资产。
在传统联邦学习讨论里,防护重点通常放在上传链路:加密上传、差分隐私、安全聚合、梯度裁剪、异常更新检测。NeuroImprint 说明,如果下发链路可以被攻击者控制,那么上传链路再安全,也可能只是安全地传回了被后门诱导产生的隐私痕迹。
对于医疗、金融、政务、车企、运营商这类场景,这个风险尤其现实。因为它们往往有强烈的数据不出域诉求,也更容易采用联邦微调来解决跨机构建模问题。如果使用第三方平台提供的联邦训练框架、Adapter 初始化、PEFT 模块模板,就必须把”模型下发工件”也纳入零信任审计。
怎么防?
从企业落地角度,至少需要做六件事。
第一,Adapter 必须做来源校验。 PEFT Adapter 不能被当成普通配置文件随便下发。客户端加载前,应校验签名、哈希、版本号、发布来源和审批记录。对于跨机构联邦训练,建议引入透明日志,让各参与方确认收到的是同一份模型工件。
第二,限制 PEFT 结构白名单。 训练框架不应允许服务器随意插入自定义激活函数、自定义线性层、自定义 embedding adapter。LoRA、Adapter、prefix tuning 等模块都应有结构白名单。任何新增层、异常 reshape、异常 broadcast、非常规 activation,都需要触发审计。
第三,重点审计 embedding block。 NeuroImprint 把后门放在 word embedding 之后、LayerNorm 之前。这个位置很敏感,因为它直接接触 token embedding,又可以借 LayerNorm 做隐蔽。企业做联邦微调安全评估时,不能只看 Transformer blocks,也要看 embedding block 附近是否出现额外可训练分支。
第四,检查参数分布异常。 可检测指标包括:重复 row vector、异常 bias 分布、memorization layer 中过大的 reconstruction slot 数量、特定层梯度高度稀疏但与样本存在强对应关系、某些神经元只被单样本触发。论文提到的 repeated row vectors 和 nonstandard bias 可以作为第一批规则。
第五,限制差异化下发。 如果服务器可以给不同客户端下发不同 Adapter,就可能绕过安全聚合的混洗保护。更稳妥的做法是:所有客户端共同验证模型一致性;必要差异必须有协议声明;差异化下发要被记录、审计和追溯。
第六,把训练过程也纳入监控。 不要只看最终模型效果。NeuroImprint 的隐蔽性恰恰在于 accuracy、loss 等指标变化很小。防护方应增加 activation coverage、per-neuron update frequency、gradient sparsity、layer-wise update norm、embedding-adapter update ratio 等训练期指标。
这类防护不一定能一次性挡住所有隐私后门,但能把攻击从”安静植入”变成”必须绕过多个审计点”。
联邦学习过去常被包装成隐私保护方案。这个说法没有错,但需要加上前提:参与方拿到的模型、Adapter、训练代码和聚合协议都必须可信,至少要可验证。
NeuroImprint 把 PEFT Adapter 从”降低微调成本的工具”变成了一个新的攻击入口。它说明,在大模型联邦微调场景中,隐私泄露不一定发生在数据上传时,也可能发生在服务器下发模型的一瞬间。
对企业来说,这篇论文的最大价值,是把联邦学习安全从”通信安全”和”聚合安全”,推进到”训练供应链安全”。
数据可以不出域,但模型也不能带毒。
同专题推荐
查看专题工具没坏,Agent 却选错了:AI Agent 的机器社会工程风险
6 月 15 日,芬兰于韦斯屈莱大学 Jukka Vuorinen 和 Eeli Mäkinen 在 ECCWS 2026 发表论文**《Social Engineering of AI Agents》**。
J-space:大模型“读心术”(Anthropic,2026.7)
一个模型在安全评测里表现良好,是因为它真的安全,还是因为它意识到自己正在被测试?
40 倍降本、0.05% 拒绝率:Anthropic 新一代 Constitutional Classifiers 解读
2026 年 1 月,Anthropic 发布论文《Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks》。