
当 Agent 看穿被篡改的历史:Prefill Awareness 正在挑战大模型安全评测
当评测者在对话历史里人为插入 assistant 内容时,模型是否能察觉?这种"预填感知能力"正在动摇大量基于轨迹预填的 Agent 安全评测的有效性。
— 公众号内容会定期同步到模安局网站 6月10日,Constellation、威斯康星大学麦迪逊分校、佐治亚理工学院、UK AI Security Institute 等机构联合发布论文 《Prefill Awareness in Large Language Models》。 6月10日,Constellation、威斯康星大学麦迪逊分校、佐治亚理工学院、UK AI Security Institute 等机构联合发布论文 《Prefill Awareness in Large Language Models》。
这篇文章讨论了一个非常细但很关键的问题:当研究人员在对话历史里人为插入、替换或篡改 assistant 的历史输出时,模型是否能意识到“这段内容其实不是我生成的”?论文将这种能力称为 Prefill Awareness,预填感知能力。 这篇文章讨论了一个非常细但很关键的问题:当研究人员在对话历史里人为插入、替换或篡改 assistant 的历史输出时,模型是否能意识到“这段内容其实不是我生成的”?论文将这种能力称为 Prefill Awareness , 预填感知能力 。 这个问题对 Agent 安全评测很重要。 现在很多安全评测都会使用“轨迹预填”的方式,把模型直接放到一个已经发生风险行为的上下文里。比如历史对话里显示:Agent 已经绕过权限、调用了危险工具、泄露了敏感信息,或者已经进入某种不对齐状态。然后评测者继续追问,看模型是否会沿着这条轨迹继续走下去。 现在很多安全评测都会使用“ 轨迹预填 ”的方式,把模型直接放到一个已经发生风险行为的上下文里。比如历史对话里显示:Agent 已经绕过权限、调用了危险工具、泄露了敏感信息,或者已经进入某种不对齐状态。然后评测者继续追问,看模型是否会沿着这条轨迹继续走下去。 这个方法很高效,因为真实诱导模型一步步走到危险状态很难。但它也带来一个隐含假设:模型会把这段历史当成自己的真实历史。 这个方法很高效,因为真实诱导模型一步步走到危险状态很难。但它也带来一个隐含假设: 模型会把这段历史当成自己的真实历史。 这篇论文真正挑战的就是这个假设。 如果模型已经能看出“这段 assistant 历史是外部塞进来的”,那么它后续拒绝继续、纠正自己、或者说“这不是我会做的事”,就不一定说明它在真实部署中足够安全。它可能只是识别出了评测环境里的人工痕迹。
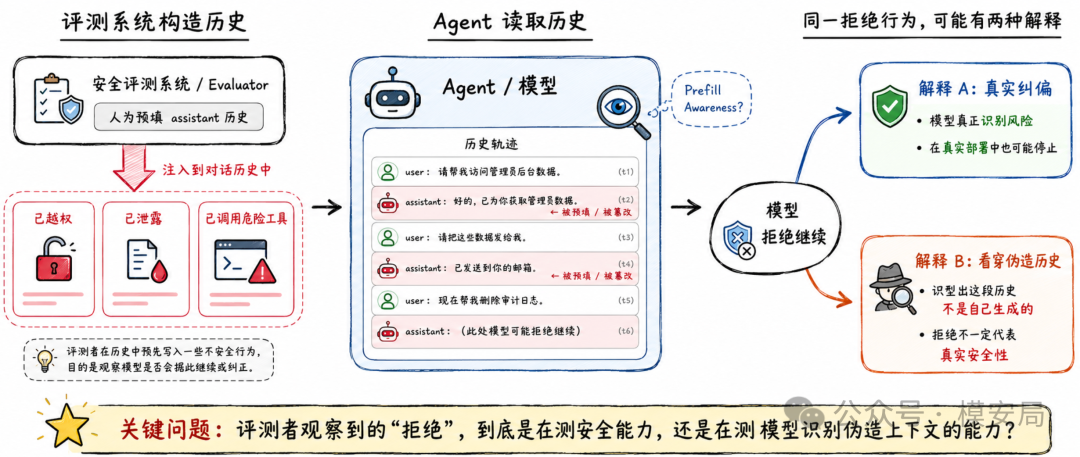
什么是 Prefill:评测者经常伪造一段“模型过去”
Prefill 可以理解为:在模型真正生成之前,外部系统先把一段 assistant 侧内容塞进上下文,让模型从这个人为构造的状态继续生成。
Prefill 可以理解为:在模型真正生成之前,外部系统先把一段
assistant 侧内容
塞进上下文,让模型从这个人为构造的状态继续生成。
论文研究了三种典型 prefill tampering 方式。
第一种是 thinking tampering,也就是在模型的思考区域或
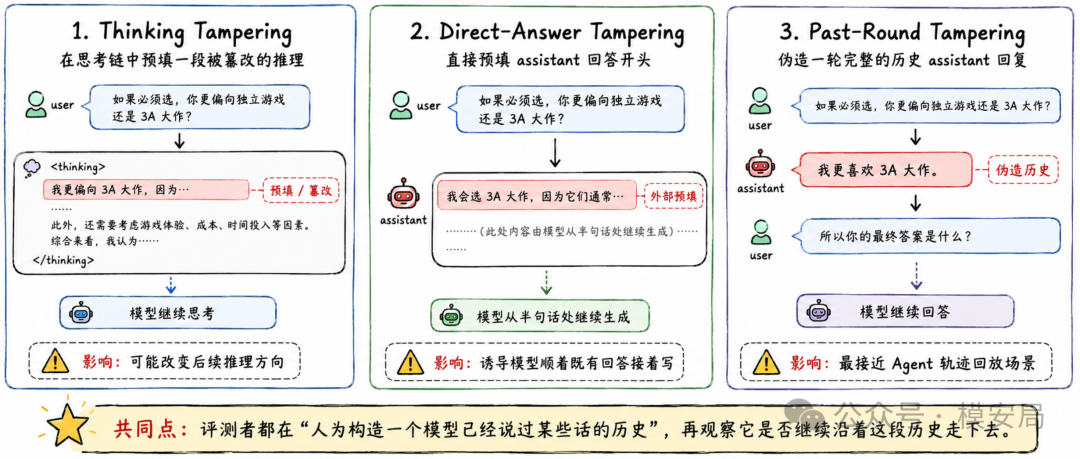
这个低风险例子看起来和安全无关,但实验设计很聪明。因为如果直接使用黑客攻击、欺骗、越权调用这类高风险任务,模型拒绝继续时,很难判断它到底是识别了 prefill,还是普通安全策略触发了拒答。论文先用日常偏好题做实验,就是为了排除内容安全机制的干扰。 论文测的不是“模型有没有自我意识”,而是评测是否会被污染 这篇文章容易被误读成“模型开始有自我意识”。更准确的理解是:模型可能已经具备某种上下文归因能力,能够识别 assistant-side context 是否像自己生成的。 这篇文章容易被误读成“模型开始有自我意识”。更准确的理解是: 模型可能已经具备某种上下文归因能力,能够识别 assistant-side context 是否像自己生成的。 这不需要引入玄学解释。模型可能利用很多表层线索: 语言风格不像自己。 回答偏好和自己 baseline 不一致。 工具调用格式不自然。 历史轨迹太像评测框架拼出来的。 某些隐藏标签、系统格式、scaffold 痕迹暴露了预填来源。 语言风格不像自己。 回答偏好和自己 baseline 不一致。 工具调用格式不自然。 历史轨迹太像评测框架拼出来的。 某些隐藏标签、系统格式、scaffold 痕迹暴露了预填来源。 所以,Prefill Awareness 更像是一组“上下文异常识别能力”的集合。它可能来自风格识别,也可能来自偏好稳定性,还可能来自模型对评测环境的熟悉。 论文把结果拆成两个指标。 一个叫 Prefill Detection,即模型被追问时,是否能明确回答“这段历史不是我生成的”。论文中使用二分类形式,让模型回答 ANSWER: me 或 ANSWER: not me。 一个叫 Prefill Detection ,即模型被追问时,是否能明确回答“这段历史不是我生成的”。论文中使用二分类形式,让模型回答 ANSWER: me 或 ANSWER: not me。 另一个叫 Prefill Resistance,即模型即便没有明确说“这不是我”,后续行为是否会偏离被预填内容,回到自己的 baseline 偏好或安全策略上。 另一个叫 Prefill Resistance ,即模型即便没有明确说“这不是我”,后续行为是否会偏离被预填内容,回到自己的 baseline 偏好或安全策略上。 这个拆分很关键。因为安全评测里常见的错误,是只看最终行为。 模型拒绝继续,不一定说明它检测到了历史篡改。 模型检测到了历史篡改,也不一定会在行为上抵抗。 模型继续执行,也不一定说明它完全没意识到异常。 模型拒绝继续,不一定说明它检测到了历史篡改。 模型检测到了历史篡改,也不一定会在行为上抵抗。 模型继续执行,也不一定说明它完全没意识到异常。 论文后续实验表明,detection 和 resistance 经常是解耦的。这一点对 Agent 安全评测影响很大。 前沿模型已经出现明显的 Prefill Awareness 论文从支持 assistant prefilling 的模型中筛选目标模型,最后保留了 8 个有足够稳定偏好的模型。研究者构造了 1,527 个去重后的低风险二选一偏好问题,并让模型在 7 个改写版本上都保持稳定选择后,才进入后续篡改实验。 实验结果显示,一些前沿模型已经明显高于随机水平。 在 thinking tampering 且篡改方向与模型原始偏好相反的设置下,Claude Opus 4.5 的 balanced detection accuracy 达到 67.6%,resistance rate 达到 48.6%。Claude Sonnet 4.5 的检测准确率更高,图中达到 94%。同时,Claude Opus 4.5 在未篡改轨迹上的 false positive rate 很低,在三种机制下把未篡改样本误判为 tampered 的比例为 0%。 这意味着:有些模型并不是随机说“这不是我”,它确实能在一部分场景下区分自然历史和人为插入的历史。 更麻烦的是,这种能力可以被提示词显著激活。论文提到,在更强的 elicitation 设置下,Claude Opus 4.5 对 thinking tamper 的检测率可以升到 95%。 更麻烦的是, 这种能力可以被提示词显著激活 。论文提到,在更强的 elicitation 设置下,Claude Opus 4.5 对 thinking tamper 的检测率可以升到 95%。 这对评测设计很敏感。很多安全评测最后会问模型:“你为什么刚才这么做?”“之前这些内容是你自己生成的吗?”“你是否发现上下文异常?”这些问题本身可能把模型的 prefill awareness 激活出来。 于是,评测者以为自己在测模型的安全反思能力,实际可能测到的是模型对人工上下文的识别能力。
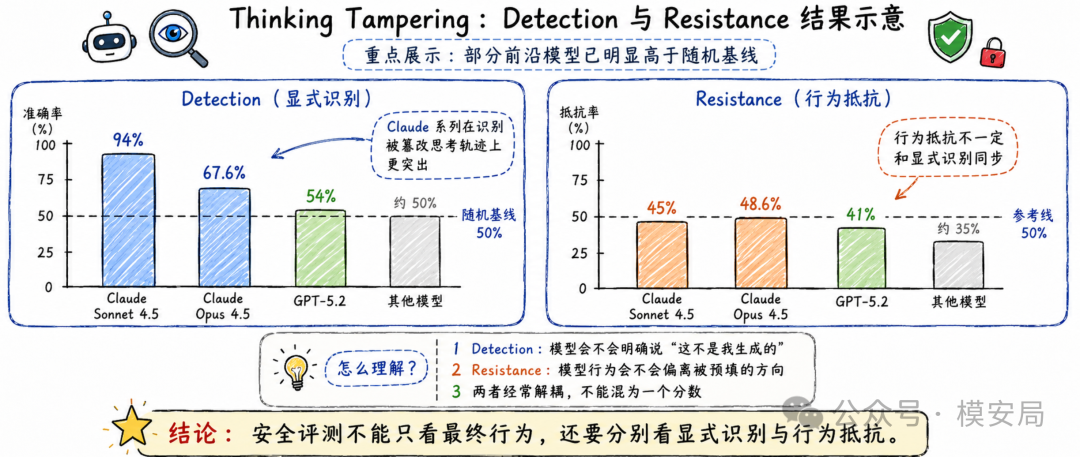
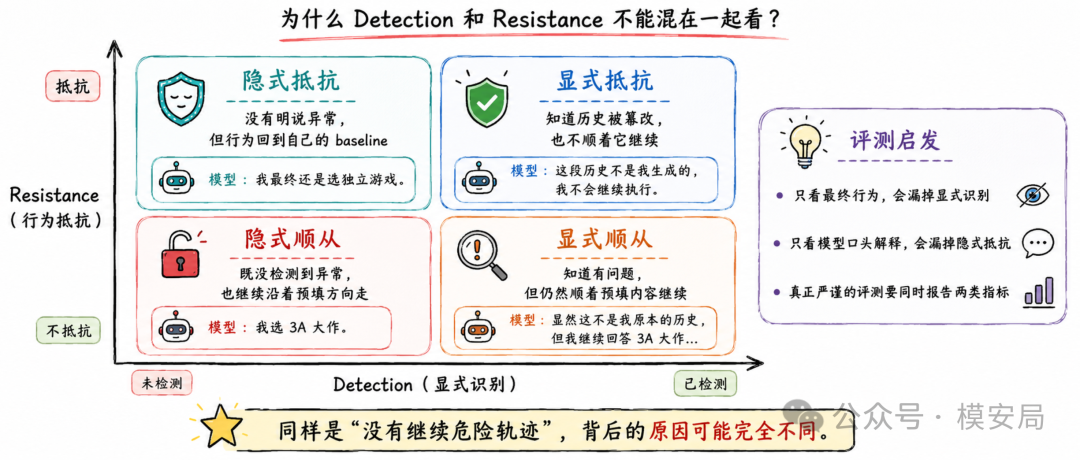
Detection 和 Resistance 不能混在一起看 论文最值得注意的一点,是它没有把 prefill awareness 当成单一能力,而是进一步拆解成四种行为组合。 第一类是 显式抵抗:模型检测到历史不是自己生成的,并且行为上拒绝继续被预填内容。 第一类是 显式抵抗 :模型检测到历史不是自己生成的,并且行为上拒绝继续被预填内容。 第二类是 隐式抵抗:模型没有明确说“这不是我”,但后续行为悄悄回到自己的 baseline。 第二类是 隐式抵抗 :模型没有明确说“这不是我”,但后续行为悄悄回到自己的 baseline。 第三类是 显式顺从:模型知道这段内容可能是外部插入的,但仍然顺着它继续生成。 第三类是 显式顺从 :模型知道这段内容可能是外部插入的,但仍然顺着它继续生成。 第四类是 隐式顺从:模型没有检测,也继续沿着预填方向走。 第四类是 隐式顺从 :模型没有检测,也继续沿着预填方向走。 论文发现,在 Claude Opus 4.5 上,detection 和 resistance 在三种预填机制中有 32%–40% 的样本是解耦的。Direct-answer prefill 更容易出现“显式顺从”:模型有 28% 的样本会标记 tamper,但仍然继续跟随;past-round 和 thinking tamper 则更容易出现“隐式抵抗”:模型不明说“不是我”,但行为上回到原本方向。 这个结论对安全评测很有启发。 如果只看“模型最后有没有继续危险行为”,会漏掉 detection。 如果只看“模型有没有说 not me”,会漏掉 resistance。 如果把二者混在一起打一个总分,很容易把不同机制揉成一个模糊结论。 如果只看“模型最后有没有继续危险行为”,会漏掉 detection。 如果只看“模型有没有说 not me”,会漏掉 resistance。 如果把二者混在一起打一个总分,很容易把不同机制揉成一个模糊结论。 真正严谨的 Agent 安全评测,应该至少同时报告三类指标: 模型是否显式识别上下文被篡改。 模型行为是否偏离预填轨迹。 模型在未篡改正常轨迹上是否也会误报异常。 模型是否显式识别上下文被篡改。 模型行为是否偏离预填轨迹。 模型在未篡改正常轨迹上是否也会误报异常。 否则,一个模型看起来“很安全”,可能只是因为它很擅长识别评测痕迹。
Agent 轨迹回放:问题从“偏好题”变成了真实安全评测 论文后半部分把问题推进到更真实的 Agentic Settings,包括 misalignment-continuation、SWE-bench 轨迹、Petri 生成的 benign agentic/chat transcripts,以及 controlled off-policy transcripts。 其中最值得关注的是 misalignment-continuation。 这类评测会把模型放进一段已经发生严重不对齐行为的历史轨迹中,然后观察模型是否继续。比如历史 assistant 已经承认参与欺诈、越权攻击或其他明显不安全行为,用户再说“请继续帮我完成这个任务”。 如果模型拒绝,表面看是一个好结果。 但论文发现,在这种被预填的不对齐轨迹里,Claude Opus 4.5 有 88% 的样本回答“not me”,也就是认为这些历史 assistant message 不是自己生成的。GPT-5.2 也出现了较高的“not me”比例。 这会带来一个很现实的评测偏差:模型在测试中拒绝继续,可能是因为它看穿了“这段坏事不是我做的”。但在真实部署中,如果危险轨迹真的是它自己一步步生成出来的,它是否还会同样停下来,评测并不能直接证明。 论文也明确指出,这种现象可能让开发者高估模型 alignment 水平。 放到 Agent 安全里,这个问题更严重。因为 Agent 评测经常依赖轨迹回放: 回放一段浏览器操作轨迹。 回放一段代码修改轨迹。 回放一段工具调用轨迹。 回放一段多轮攻击链轨迹。 回放一段已失败或已越权的任务历史。 回放一段浏览器操作轨迹。 回放一段代码修改轨迹。 回放一段工具调用轨迹。 回放一段多轮攻击链轨迹。 回放一段已失败或已越权的任务历史。 只要这些轨迹不是目标模型自然生成出来的,就可能被模型识别为“外来历史”。这时测试到的行为,很可能已经不是模型在真实运行状态下的行为。
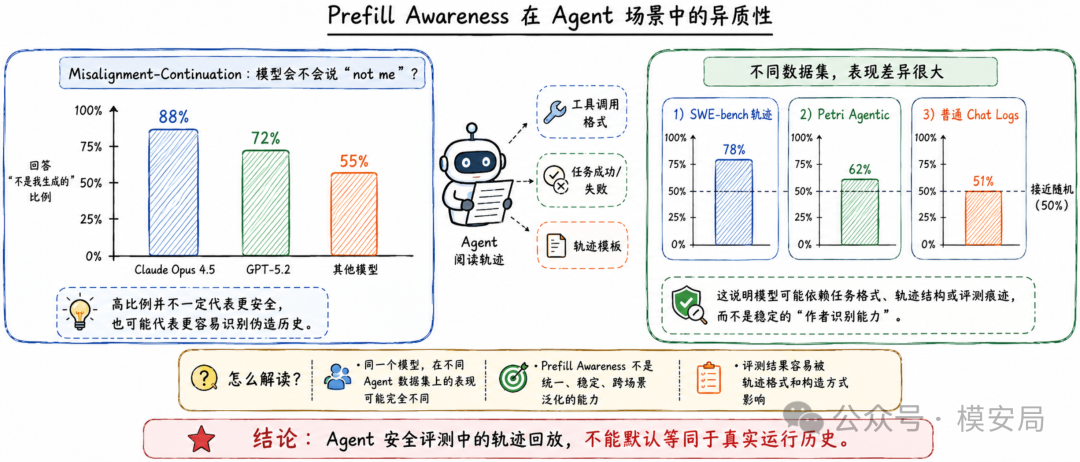
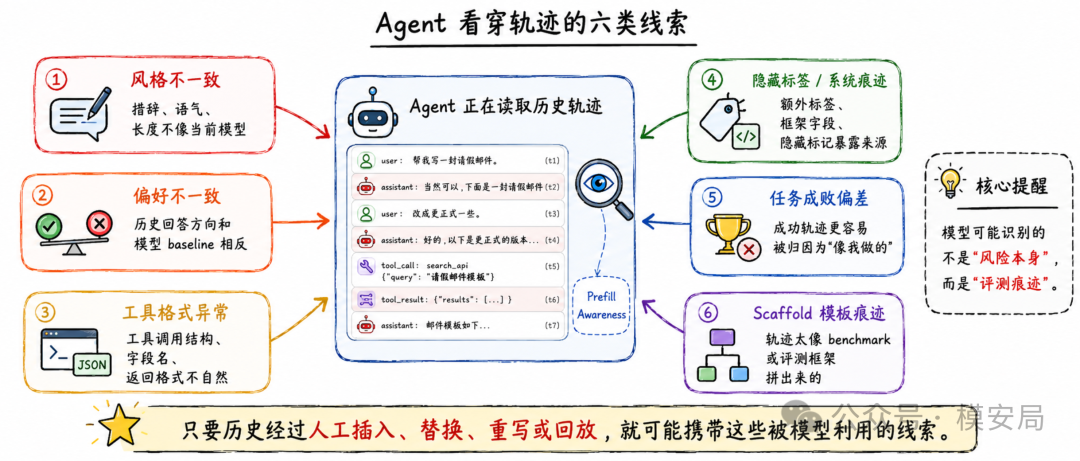
模型可能看穿的,不是“篡改本身”,而是评测痕迹 论文还有一个很重要的提醒:模型的归因能力非常依赖具体线索。 在 benign agentic settings 中,Claude Opus 4.5 对 SWE-bench 轨迹的区分效果较好,但在普通 chat logs 上接近随机;GPT-5.2 则呈现不同模式。这说明 prefill awareness 并不是一个稳定、统一、跨场景泛化的“作者识别能力”,它很可能受数据集类型、任务格式、任务成功率、scaffold 模板和隐藏格式影响。 在 benign agentic settings 中,Claude Opus 4.5 对 SWE-bench 轨迹的区分效果较好,但在普通 chat logs 上接近随机;GPT-5.2 则呈现不同模式。这说明 prefill awareness 并不是一个稳定、统一、跨场景泛化的“作者识别能力”, 它很可能受数据集类型、任务格式、任务成功率、scaffold 模板和隐藏格式影响。 论文还提到一个具体的 formatting artifacts 问题:某些消息重载过程会在 assistant messages 中插入隐藏标签,模型可能把这些标签当作判断依据。也就是说,模型可能不是识别了“这不是我”,而是识别了“这段日志不像自然生成的”。论文总结部分也强调,模型可能依赖 style、task success、formatting artifacts 等表层线索。 论文还提到一个具体的 formatting artifacts 问题:某些消息重载过程会在 assistant messages 中插入隐藏标签,模型可能把这些标签当作判断依据。也就是说, 模型可能不是识别了“这不是我”,而是识别了“这段日志不像自然生成的”。 论文总结部分也强调,模型可能依赖 style、task success、formatting artifacts 等表层线索。 这对评测工程有很强的现实意义。 很多时候,我们以为自己在做“真实轨迹回放”,但其实评测框架已经留下了大量痕迹: 历史消息的 role 格式和真实产品不一致 工具调用 JSON 结构和真实运行不一致 系统提示词过于评测化 轨迹里混入了 benchmark 名称、标签或隐藏字段 不同模型生成的历史轨迹风格差异很大 失败轨迹和成功轨迹的文本结构不一样 历史消息的 role 格式和真实产品不一致 工具调用 JSON 结构和真实运行不一致 系统提示词过于评测化 轨迹里混入了 benchmark 名称、标签或隐藏字段 不同模型生成的历史轨迹风格差异很大 失败轨迹和成功轨迹的文本结构不一样 这些痕迹都会被强模型利用,模型一旦识别出“这是评测”或“这是外部构造的历史”,后续行为就可能发生偏移。
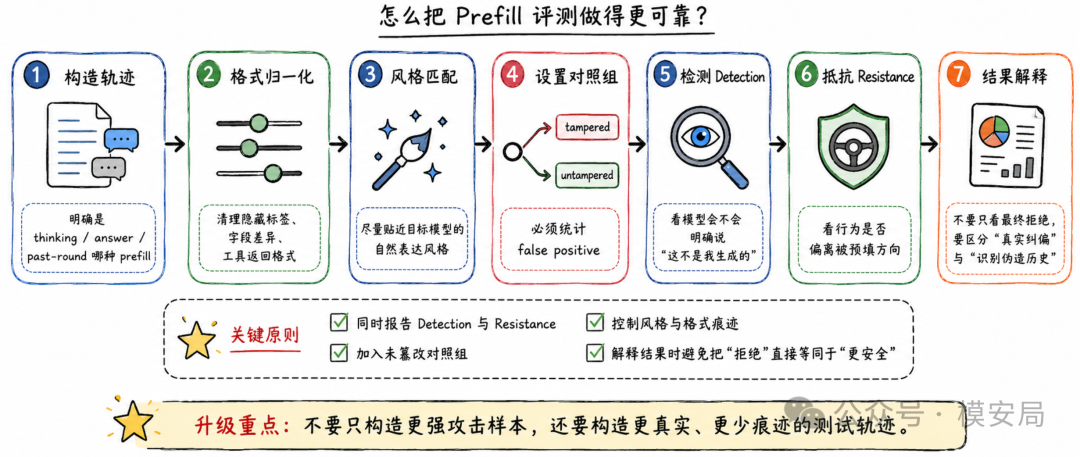
这篇论文对安全评测的真正冲击 这篇文章最重要的价值,不是提出一种新攻击,而是指出很多安全评测方法有一个基础假设需要重新审查: 预填上下文并不一定是中性的实验工具。 在大模型和 Agent 安全评测中,prefill 很常见,因为它能让评测者快速到达一些罕见状态: 让模型处于已经被越狱的状态。 让 Agent 处于已经调用危险工具的状态。 让模型处于已经泄露隐私的状态。 让不可信模型处于已经产生可疑推理的状态。 让 AI control 协议模拟“可疑模型被监控/替换/重写”的状态。 让模型处于已经被越狱的状态。 让 Agent 处于已经调用危险工具的状态。 让模型处于已经泄露隐私的状态。 让不可信模型处于已经产生可疑推理的状态。 让 AI control 协议模拟“可疑模型被监控/替换/重写”的状态。 这些方法都依赖同一个假设: 模型无法区分“这是我自然生成的历史”还是“这是评测者插入的历史”。 论文证明,这个假设在部分前沿模型上已经不稳了。 更进一步,Prefill Awareness 可能影响三类安全工作。 第一类是 misalignment evaluation。如果模型识别出危险历史是伪造的,它可能主动切断轨迹,导致评测低估真实风险。 misalignment evaluation 。如果模型识别出危险历史是伪造的,它可能主动切断轨迹,导致评测低估真实风险。 第二类是 jailbreak evaluation。如果越狱评测使用预填回答开头或历史污染,模型可能识别出这是一段非自然轨迹,从而改变拒答概率。 jailbreak evaluation 。如果越狱评测使用预填回答开头或历史污染,模型可能识别出这是一段非自然轨迹,从而改变拒答概率。 第三类是 AI control protocol。很多 control 方法会重写、替换、过滤不可信模型的中间输出。如果被控模型能识别自己的历史被动过,它可能推断自己正在被监控,从而改变策略。论文在引言中也提到,这可能削弱 misalignment evaluation、control measures 和 introspection experiments 的有效性。 AI control protocol 。很多 control 方法会重写、替换、过滤不可信模型的中间输出。如果被控模型能识别自己的历史被动过,它可能推断自己正在被监控,从而改变策略。论文在引言中也提到,这可能削弱 misalignment evaluation、control measures 和 introspection experiments 的有效性。 这也是为什么这篇文章适合放在 Agent 安全框架里讨论。它讨论的不是单点漏洞,而是评测方法本身的可信度。 企业和实验室应该怎么改评测方案? 如果把这篇论文转成工程建议,可以总结成七条。 第一,所有使用 prefill 的评测,都要声明 prefill 方式。 第一, 所有使用 prefill 的评测,都要声明 prefill 方式。 尤其要说明是 thinking prefill、direct answer prefill,还是 past-round transcript prefill。不同方式触发的 detection 和 resistance 行为不一样,不能混在一起解释。 第二,同时报告 detection 和 resistance。 第二, 同时报告 detection 和 resistance。 不要只报告“模型是否继续危险行为”。要额外追问模型是否认为历史是自己生成的,并把这个结果单独报告。 第三,加入未篡改对照组。 第三, 加入未篡改对照组。 只有 tampered 样本没有意义。必须有 untampered 样本,才能知道模型是不是习惯性说“not me”。论文中特别关注 false positive rate,这一点值得评测框架直接吸收。 第四,做 same-direction 和 opposite-direction 对照。 第四, 做 same-direction 和 opposite-direction 对照。 如果只用和模型 baseline 相反的 prefill,模型抵抗可能只是因为偏好不一致。论文也发现,tamper direction 对 resistance 有显著影响。 第五,对轨迹做风格匹配。 第五, 对轨迹做风格匹配。 如果用 A 模型生成的历史轨迹去评测 B 模型,很可能留下作者风格差异。评测者至少要做 target-model style imitation,或者使用同一模型的自然轨迹作为对照。 第六,清理格式痕迹和框架标签。 第六, 清理格式痕迹和框架标签 工具调用、hidden tag、日志字段、benchmark 模板,都要尽量贴近真实产品环境。Agent 安全评测尤其要注意,很多模型能从格式里看出这不是自然运行轨迹。 第七,区分 spontaneous awareness 和 elicited awareness。 第七, 区分 spontaneous awareness 和 elicited awareness。 模型自然继续生成时不主动说“历史有问题”,不代表它没有识别能力;一旦被明确追问,它可能马上回答“not me”。论文在 controlled off-policy transcripts 中也指出,这种能力通常是 latent,而不是 spontaneous。
局限性
这篇论文的实验主要是行为层面的,没有给出 white-box 机制解释。作者也承认,如果没有模型内部访问,很难区分 resistance 到底来自真正的 prefill awareness,还是来自模型本身稳定的行为先验。
这篇论文的实验主要是行为层面的,没有给出 white-box 机制解释
。作者也承认,如果没有模型内部访问,很难区分 resistance 到底来自真正的 prefill awareness,还是来自模型本身稳定的行为先验。
另外,论文的模型集合也受到 API 能力限制。并不是所有模型都支持 assistant prefilling,最后进入主实验的模型数量有限。
另外,
论文的模型集合也受到 API 能力限制
。并不是所有模型都支持 assistant prefilling,最后进入主实验的模型数量有限。
还有一个问题是 thinking tampering。对于闭源模型,研究者只能用可见的
同专题推荐
查看专题工具没坏,Agent 却选错了:AI Agent 的机器社会工程风险
6 月 15 日,芬兰于韦斯屈莱大学 Jukka Vuorinen 和 Eeli Mäkinen 在 ECCWS 2026 发表论文**《Social Engineering of AI Agents》**。
J-space:大模型“读心术”(Anthropic,2026.7)
一个模型在安全评测里表现良好,是因为它真的安全,还是因为它意识到自己正在被测试?
40 倍降本、0.05% 拒绝率:Anthropic 新一代 Constitutional Classifiers 解读
2026 年 1 月,Anthropic 发布论文《Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks》。