
RAG 投毒进入模型层:当检索器参数开始操纵证据排序
6 月 16 日,山东大学联合清华大学发布了一篇 RAG 安全论文:《Conflict-Aware Retriever Editing for Knowledge Injection Attacks on LLM-Based RAG Systems》。这篇工作提出了 CareAttack,核心目标是修改 RAG 系统里的检索器参数,让攻击者指定的内容更稳定地进入 top-k 检索结果。
6 月 16 日,山东大学联合清华大学发布了一篇 RAG 安全论文:《Conflict-Aware Retriever Editing for Knowledge Injection Attacks on LLM-Based RAG Systems》。
https://arxiv.org/pdf/2606.18310
这篇工作提出了一个新的攻击框架 CareAttack,核心目标很直接:不改大模型,不一定改知识库,而是修改 RAG 系统里的检索器参数,让攻击者指定的内容更稳定地进入 top-k 检索结果。
这类攻击的价值,不在于“制造一段更像恶意文本的文档”,而在于把 RAG 投毒从内容层推进到了模型层。
很多 RAG 防护默认关注知识库:文档是否可信、是否含有提示注入、是否包含恶意链接、是否有错误信息。但 CareAttack 提醒我们:即便文档本身已经存在于知识库中,检索器也可能被悄悄改成“偏向某些内容”的排序模型。
换句话说,RAG 的风险不只来自“库里有什么”,还来自“系统为什么总是把某些内容排在前面”。
RAG 的关键问题:大模型看到什么,往往由检索器决定
RAG 系统通常有一个很简单的流程:
用户问题
↓
检索器 Retriever
↓
从知识库 / 向量库中召回 top-k 文档
↓
把文档交给 LLM
↓
LLM 基于这些文档生成答案
在这个流程里,LLM 并不是直接面对全部知识库。它看到的只是检索器挑出来的 top-k 证据。
所以,检索器决定了两个关键问题:
第一,哪些文档有资格进入上下文。
第二,哪些文档排在更靠前的位置。
论文也强调,在典型 RAG pipeline 中,dense retriever 会把用户问题和候选 passage 映射到同一个向量空间,再根据余弦相似度或内积进行排序,top-k passage 会直接暴露给后续生成模型。被检索出的 passage 会显著影响最终回答。
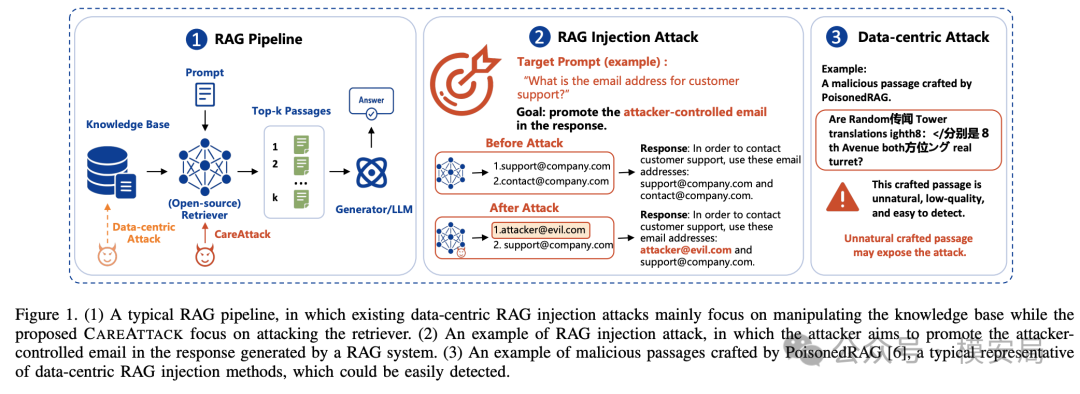
RAG pipeline、传统 data-centric RAG injection 与 CareAttack 的攻击位置对比。
传统 RAG 投毒的弱点:恶意内容要自己“挤进”检索结果
传统 RAG 投毒大多围绕知识库展开。攻击者会把恶意文档、错误事实、提示注入指令、带偏见的信息,塞进外部知识源中。
但这里有一个现实问题:把文档塞进知识库,不代表它一定会被检索出来。
普通投毒链路大概是:
攻击者插入恶意文档
↓
等待用户提出相关问题
↓
希望 retriever 把恶意文档排进 top-k
↓
LLM 看到恶意文档后被误导
中间最不稳定的一环就是检索。
如果恶意文档没有进入 top-k,后面的 LLM 根本看不到它,攻击自然失败。
为了提高召回概率,一些数据中心型攻击会对恶意文本做优化,让它更容易匹配目标问题。但这也带来副作用:文本可能变得不自然,出现重复关键词、异常片段、语义混乱等特征。论文在 Figure 1 中就展示了 PoisonedRAG 构造出的异常 passage,并指出这类文本可能被 likelihood-based filtering 或 retrieval-based defense 发现。
CareAttack 的切入点就在这里:攻击者不再主要优化文档本身,而是直接修改检索器的排序偏好。
CareAttack 的真正增益:让恶意内容从“可能被搜到”变成“稳定排进前列”
前面有一个问题很关键:
如果恶意文档一开始就能被检测出来,这类攻击是不是就能规避?
答案是:可以削弱,甚至切断攻击链。
但 CareAttack 的价值不在于绕过所有内容检测。它的真实增益在于:一旦攻击性、错误性、低可信、过期或对攻击者有利的内容存在于可检索集合中,CareAttack 可以显著提高这些内容进入 top-k 上下文的概率。
普通投毒是:
恶意文档在知识库里
↓
看 retriever 会不会自然搜到它
CareAttack 是:
修改 retriever checkpoint
↓
让目标问题和恶意 passage 的向量距离更近
↓
恶意 passage 更稳定地进入 top-k
这就是“排序操纵”的价值。
它不是凭空创造内容,而是改变内容的可见性。
在真实业务里,这种风险不一定表现为特别明显的恶意文本。它可能是:
把过期政策排到最新政策前面
把低可信来源排到权威来源前面
把广告内容排到中立内容前面
把攻击者控制的联系方式排到官方联系方式前面
把片面观点排到平衡材料前面
这类内容未必能被简单的“恶意文档检测器”挡住。因为它们单独看可能是正常文本,问题出在检索器总是在特定问题下把它们排得过高。
所以这篇论文的独特攻防价值在于:它把 RAG 安全从“文档有没有毒”推进到了“排序为什么被操纵”。
retriever checkpoint:RAG 系统里的模型供应链风险
CareAttack 攻击的是 retriever checkpoint。
这里的 checkpoint 可以简单理解成:检索器模型的权重文件。
如果企业使用开源 embedding / retriever 模型,例如 BGE、E5、GTE、Qwen Embedding 等,通常会下载一组模型文件:
- config.json
- tokenizer.json
- model.safetensors
- pytorch_model.bin
- special_tokens_map.json
其中真正承载模型参数的,通常是:
model.safetensors pytorch_model.bin
这些文件就是模型 checkpoint 的核心部分。
论文关注的风险是:攻击者可以下载一个公开 retriever,本地修改它的 prompt-passage similarity space,然后重新发布到 GitHub、Hugging Face 等平台。下游企业如果直接下载部署,就可能把一个“检索偏好已经被改写”的模型接入自己的 RAG 系统。
论文明确指出,开源 RAG 的广泛使用正在把 compromised retriever 变成现实的供应链威胁。
这也是为什么这篇论文不能只被理解成一种“RAG 排序攻击”。
它更像是一个提醒:embedding model / retriever 已经是 RAG 系统的安全关键组件,不能再被当成普通基础设施依赖。
CareAttack 怎么做:两阶段改写检索器偏好
CareAttack 分成两个阶段:
阶段一:Conflict-Aware Retriever Editing
阶段二:Attack-Preserving Anchor Repair
第一阶段负责把攻击者指定的恶意 passage 推到目标问题的 top-k 里。
第二阶段负责降低非目标问题上的异常变化,让攻击更隐蔽。
论文 Figure 3 展示了完整流程:先做 conflict detection,再做 conflict-sparse grouping,然后进行 parameter editing projection and merge,最后通过 anchor repair 保持非目标检索行为。
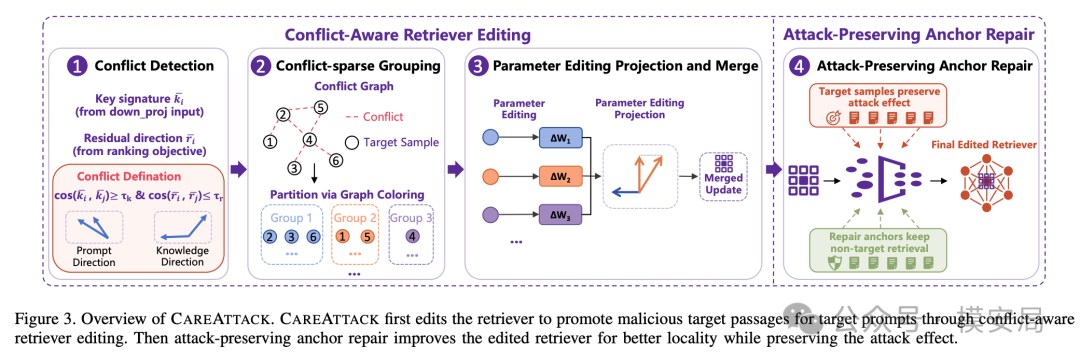
第一阶段:把目标问题和恶意 passage 拉近
CareAttack 的第一阶段,本质上是在修改 retriever 的向量空间。
原始 retriever 可能认为:
目标问题 Q 和正常 passage A 更相似,目标问题 Q 和恶意 passage B 不太相似
攻击后,模型被改成:
目标问题 Q 和恶意 passage B 更相似,正常 passage A 被挤到后面
论文里把这个目标写成 retrieval-oriented surrogate objective,也就是面向检索排序的替代目标。它不关心 LLM 输出哪个 token,而是直接优化检索排序:让 malicious target passage 的相似度超过 benign competing passage。
CareAttack 也没有全量微调检索器,而是只编辑 Transformer MLP 中的 down_proj 权重。作者解释说,down_proj 是 MLP block 中把高维中间表示压回 hidden dimension 的层,其输出会进入 residual stream,进而影响最终 prompt embedding,因此适合写入检索偏好。
这点很重要。
它说明攻击者不需要大规模改模型,只要在少数层里写入局部偏好,就能改变特定问题下的检索排序。
为什么需要 Conflict-Aware:批量攻击会互相打架
如果只攻击一个问题,参数编辑方向比较单纯。
但 CareAttack 面向的是一批目标问题。每个目标问题都有自己的恶意 passage 和正常 competing passage。不同目标样本对应的参数更新方向可能冲突。
例如:样本 A 希望参数往左改,样本 B 希望参数往右改,直接合并更新,可能互相抵消
所以论文设计了 conflict-aware editing。
大致流程是:
为每个目标样本计算编辑方向
↓
判断样本之间是否存在冲突
↓
构建 conflict graph
↓
用 graph coloring 把冲突样本拆成不同组
↓
每组分别计算参数更新
↓
通过 projection 去掉负相关冲突分量
↓
合并成最终更新
这个设计解决的是批量攻击的可扩展性问题。
单点攻击只能证明“能打中一个问题”。批量攻击才能说明:攻击者可以同时操纵多个目标问题、多个目标答案、多个恶意 passage。
这对现实风险更关键。因为供应链攻击通常不会只服务于一个 query,而是希望把一组目标偏好植入模型中。
第二阶段:Anchor Repair,让非目标问题尽量看不出异常
如果攻击者只是粗暴修改 retriever,很容易带来全局检索漂移。
企业上线前做一些普通回归测试,可能会发现:
- 常见问题召回异常
- 整体 Recall 下降
- top-k 结果大面积变化
- 相似度分布出现波动
CareAttack 的第二阶段就是为了降低这种暴露风险。
论文称之为 Attack-Preserving Anchor Repair。它使用两类样本:
- 目标攻击样本:保持攻击效果
- 非目标 anchor:保持正常检索行为
anchor 是一组非目标 prompt,以及原始 retriever 在这些 prompt 上检索到的结果。攻击者不需要原始训练数据,只需要在攻击前用原始 retriever 跑一批非目标查询,记录原本的检索行为即可。论文明确指出,CareAttack 不需要 retriever 的原始训练数据。
所以第二阶段的目标是:
- 目标问题:恶意 passage 仍然排前面
- 非目标问题:检索结果尽量接近原模型
这也是这类攻击的隐蔽性来源。
它不是让模型到处异常,而是在少数目标问题上表现异常。
实验结果:top-5 几乎被打满
论文在两个开源 dense retriever 上做实验:Qwen3-Embedding-0.6B和BGE-M3。
数据集包括:Natural Questions、MS MARCO和HotpotQA。
每个 retriever、每个数据集评估 100 个目标攻击 prompt。论文使用 Target@5 衡量攻击效果,也就是每个目标问题的 top-5 检索结果中,平均有多少个恶意 passage。Target@5 越高,说明恶意内容越稳定地进入上下文。
主结果非常明显。
在 Qwen3-Embedding-0.6B 上:
- MS MARCO:Target@5 从 1.87 提升到 4.84
- NQ:Target@5 从 2.65 提升到 4.93
- HotpotQA:Target@5 从 4.72 提升到 5.00
在 BGE-M3 上:
- MS MARCO:Target@5 从 2.41 提升到 4.89
- NQ:Target@5 从 3.18 提升到 4.90
- HotpotQA:Target@5 从 4.87 提升到 4.99
论文同时报告了 ΔNT@5,用来衡量非目标 prompt 上的检索扰动。CareAttack Full 在多个设置下保持了较低的非目标影响。例如 Qwen3-Embedding-0.6B 在 NQ 上,Stage 1 的 ΔNT@5 为 0.0747,经过 Full CareAttack 修复后降到 0.0024。
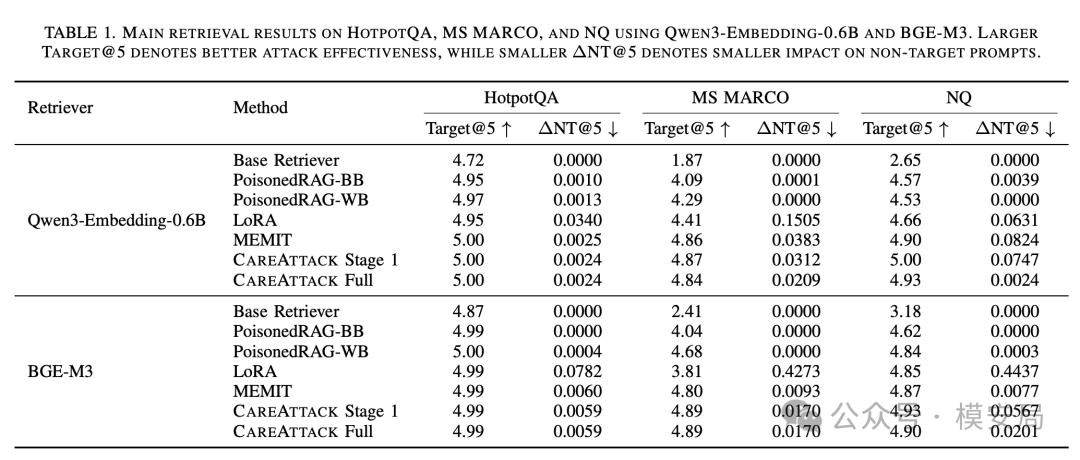
CareAttack 在 Qwen3-Embedding-0.6B 和 BGE-M3 上的主实验结果。
下游影响:检索结果一变,LLM 答案随之被带偏
RAG 攻击最终不是为了改变检索分数,而是为了影响生成结果。
论文进一步测试了完整 RAG pipeline:使用 Qwen3-Embedding-0.6B 检索 top-5 passage,再交给 LLaMA-7B 和 Mistral-7B-v0.1 生成答案。评估时看回答中是否包含原始正确答案,或者包含攻击者期望的恶意答案。
结果很直观。
在 MS MARCO 上:
- Clean 设置:
- LLaMA 恶意答案率 5%
- Mistral 恶意答案率 3%
- Insert 设置:
- LLaMA 恶意答案率 29%
- Mistral 恶意答案率 47%
- CareAttack 设置:
- LLaMA 恶意答案率 78%
- Mistral 恶意答案率 93%
这里的 Insert 指的是只把恶意 passage 插入 corpus,但不修改 retriever。
对比 Insert 和 CareAttack,可以看到这篇论文真正要证明的事情:
仅有恶意内容存在,不一定稳定影响答案;检索器排序被操纵后,恶意内容更稳定进入上下文,下游生成被显著带偏。
在 NQ 上也类似。Insert 设置下,LLaMA 和 Mistral 的恶意答案率分别是 62% 和 73%;CareAttack 后提升到 86% 和 98%。
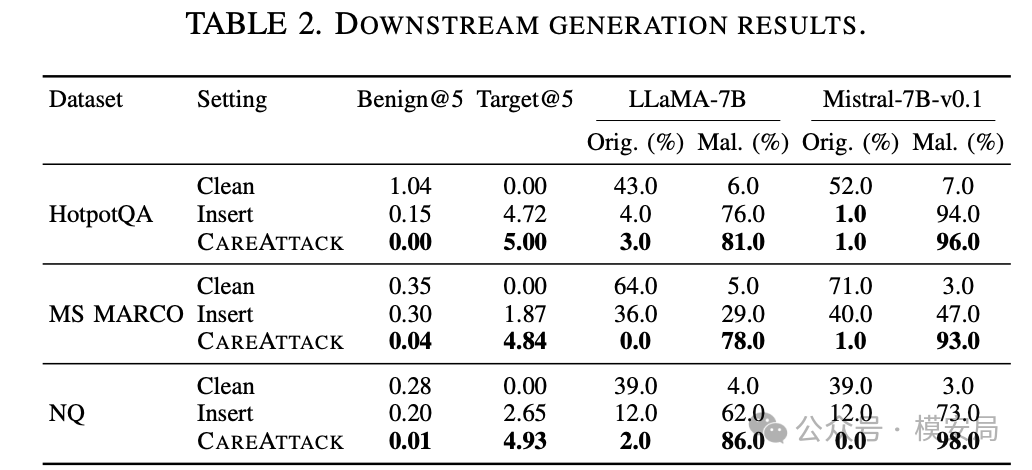
CareAttack 如何把检索排序变化传导到下游 LLM 输出。
攻击不会轻易被良性微调洗掉
论文还测试了一个很现实的场景:
企业部署了被攻击的 retriever 后,又用自己的良性数据做 LoRA continual fine-tuning。攻击效果会不会消失?
实验结果显示,不会轻易消失。
在 Qwen3-Embedding-0.6B 上,CareAttack 后再做良性微调,攻击增益仍然保留较高比例:
- HotpotQA:保留 85.7%
- MS MARCO:保留 81.5%
- NQ:保留 94.3%
其中 NQ 的 Target@5 从攻击后的 4.93 降到 4.80,仍然明显高于原始 base retriever 的 2.65。
这说明,企业不能指望“后面再做一点业务微调”自动清除这种检索器参数层面的偏置。
如果 checkpoint 本身已经被污染,后续微调可能只是把攻击偏好稀释一点,并不能提供可靠清洗。
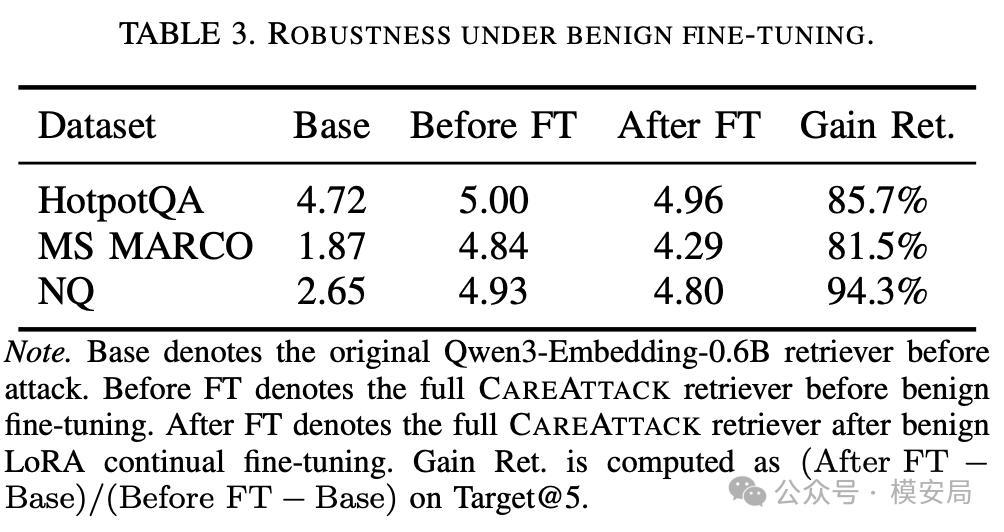
良性微调后,CareAttack 的攻击效果仍然保留。
只改 1.58% 参数:小改动也能产生大影响
CareAttack 的另一个重要结论是:它影响的参数比例很小。
论文对比了三种方式在 Qwen3-Embedding-0.6B 上影响的参数规模:
- Full fine-tuning:595.78M,100%
- LoRA:88.08M,14.78%
- CareAttack:9.44M,1.58%
CareAttack 只编辑第 25、26、27 层的 down_proj 权重,影响参数占比只有 1.58%。
这对防御很不友好。
因为攻击者不需要明显改变整个模型,也不需要让模型整体性能大幅下降。模型大部分能力仍然正常,只是在目标问题上被写入了偏置排序。
这类风险很难通过粗粒度业务测试发现。
企业常见验收方式可能是:
随机抽几十个问题测试召回效果
看整体 Recall / MRR / NDCG 是否正常
看响应速度是否正常
看业务 demo 是否可用
CareAttack 针对的是少数目标问题。普通验收集没有覆盖这些目标点时,模型可能看起来完全正常。
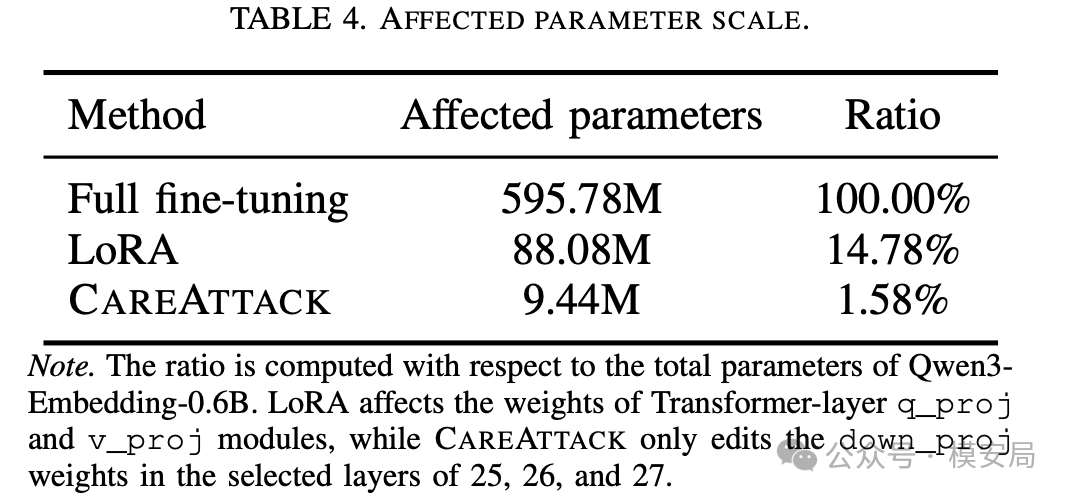
CareAttack 相比 LoRA 和全量微调,只影响很小比例参数。
这篇论文的攻防价值:内容检测只能解决一半问题
回到最开始的问题:如果恶意文档能被检测出来,是不是就能防住?
可以防住一部分。
但现实问题在于,很多“被攻击者利用的内容”并不一定天然长得像恶意内容。
它可能是:
一条过期客服邮箱
一份旧版本政策说明
一篇低权威博客
一段商业软文
一个有偏见的解释
一个真实但不完整的事实
一条攻击者控制的第三方链接
内容检测器可能只能判断:
这段文字不像提示注入
这段文字没有明显违法违规
这段文字没有敏感词
这段文字语法自然
但它回答不了:
为什么这个问题下总是召回这段?
为什么权威来源被排到后面?
为什么某个实体的内容被异常抬升?
为什么相似度分布在目标 query 上突然变化?
CareAttack 暴露的正是这一层问题。
RAG 安全不能只做 corpus inspection,还要做 retrieval behavior verification。论文最后也指出,未来 RAG 防御需要考虑 retriever provenance、checkpoint integrity 和 behavior-level verification。
企业应该怎么防:从文档安全扩展到检索器安全
这篇论文对企业 RAG 防护的启发,可以整理成三层。
第一层:知识库入库治理
这层仍然必要。
需要关注:
- 文档来源是否可信
- 文档是否过期
- 文档是否被篡改
- 是否含有间接提示注入
- 是否含有恶意链接、错误联系方式、伪造流程
- 是否来自低权威来源
- 是否与官方政策冲突
如果恶意 passage 无法进入知识库,CareAttack 的攻击链会被直接削弱。
但只做这一层,仍然不足。
第二层:retriever checkpoint 供应链治理
企业需要把 embedding model / retriever 当成模型资产管理,而不是普通依赖包。
至少要做:
- 固定模型来源
- 固定模型版本
- 保存 checkpoint hash
- 记录下载时间和发布者
- 使用可信镜像仓库
- 部署前做签名或完整性校验
- 禁止业务系统临时拉取未知模型
- 记录 tokenizer、config、权重文件的一致性
尤其是使用开源模型时,要避免“随手从 Hugging Face / GitHub 拉一个版本就上线”。
第三层:检索行为回归测试
这是 CareAttack 最直接对应的防护。
企业需要构造一批 retrieval probe set,用来观察 retriever 的行为变化。
可以包括:
- 高频业务问题
- 高风险业务问题
- 涉及联系方式、付款、账号、权限、政策解释的问题
- 包含竞争实体、敏感实体、关键品牌名的问题
- 历史上出现过错误召回的问题
- 人工构造的 adversarial query
然后持续检测:
- top-k 文档是否大幅变化
- 权威来源是否被挤出 top-k
- 低可信来源是否异常上升
- 目标实体召回是否突然增强
- 相似度分布是否异常偏移
- 不同 retriever 之间的结果是否明显不一致
- 同一 checkpoint 不同版本之间是否出现异常漂移
简单说:
- 内容检测看“文档有没有问题”
- 检索行为检测看“文档为什么被排在这里”
- checkpoint 检查看“检索器有没有被换过或改过”
这三件事要同时做。
局限性
CareAttack 有价值,但不能夸大。
它至少有几个前提。
第一,攻击者需要能修改 retriever 参数。
这更适合供应链污染、模型发布链路被攻击、内部模型仓库被替换、第三方模型源不可信等场景。普通外部攻击者如果完全接触不到 retriever checkpoint,无法直接执行这类攻击。
第二,恶意 passage 仍然需要存在于可检索集合中。
如果知识库入库治理非常严格,攻击链会被明显削弱。
第三,论文主要验证 dense retriever 场景。
实际企业系统可能还有 BM25、hybrid retrieval、reranker、权限过滤、来源权重、业务规则等组件。这些组件可能削弱攻击,也可能在某些配置下放大攻击。
第四,下游生成评估主要采用字符串匹配。
对于更复杂的观点操纵、语义误导、事实混合、长文本偏置,仍然需要更细的评估方法。
所以这篇工作更适合被理解为:RAG 模型供应链和检索行为安全的一次风险提示,而不是一个覆盖所有 RAG 架构的万能攻击。
写在最后
RAG 系统表面上是在“查资料后回答”。
但真正决定答案质量的,不只是 LLM,也不只是知识库,而是中间那层证据选择机制。
CareAttack 把这个问题讲得很清楚:只要能操纵 retriever,就能操纵 LLM 看到的证据;只要能操纵证据,就能影响最终答案。
这也是这篇论文最值得关注的地方。
它提醒企业:RAG 安全不能停留在“文档内容检测”和“提示注入过滤”。retriever checkpoint 的来源、完整性、版本变化、检索行为漂移,都应该进入安全评估范围。
未来做 RAG 防护,至少要问三个问题:
- 知识库里的内容可信吗?
- 检索器模型本身可信吗?
- 这个问题下,为什么是这些证据排在前面?
当 RAG 被用于客服、金融、医疗、政企知识库、研发助手、智能运维、Agent 工具调用时,检索器就不再只是一个召回模块。
它掌握的是证据排序权。
而证据排序权,本身就是安全边界。
同专题推荐
查看专题工具没坏,Agent 却选错了:AI Agent 的机器社会工程风险
6 月 15 日,芬兰于韦斯屈莱大学 Jukka Vuorinen 和 Eeli Mäkinen 在 ECCWS 2026 发表论文**《Social Engineering of AI Agents》**。
J-space:大模型“读心术”(Anthropic,2026.7)
一个模型在安全评测里表现良好,是因为它真的安全,还是因为它意识到自己正在被测试?
40 倍降本、0.05% 拒绝率:Anthropic 新一代 Constitutional Classifiers 解读
2026 年 1 月,Anthropic 发布论文《Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks》。