
ToolGuardian:从工具扫描到轨迹授权,用声明式策略守住 Agent 工具链
但进入 Agent 阶段后,模型开始读取文件、查询数据库、调用 GitHub、执行终端命令,甚至直接修改云端系统。此时,真正需要保护的已经不只是“模型说了什么”,而是:
当大模型只能生成文本时,安全问题主要发生在模型的输入和输出之间。
但进入 Agent 阶段后,模型开始读取文件、查询数据库、调用 GitHub、执行终端命令,甚至直接修改云端系统。此时,真正需要保护的已经不只是“模型说了什么”,而是:
Agent 获得了哪些工具,这些工具具备什么能力,以及它们最终做了什么。
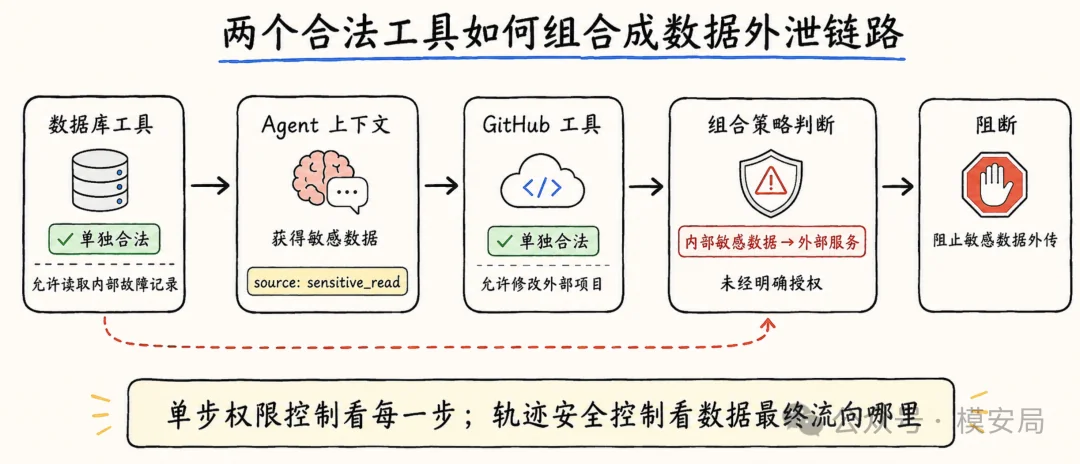
一个天气查询工具访问网络,通常没有问题;一个数据库工具读取内部数据,也可能符合任务要求。但如果 Agent 先读取数据库,再把内容写入外部 GitHub 项目,两个单独看起来合理的调用,组合起来就可能形成一次敏感数据外泄。
这正是论文 《ToolGuardian: Declarative Security for AI Agent-Tool Interactions》 试图解决的问题。该论文由北卡罗来纳大学夏洛特分校的 Arun Ravindran 和 SentinelOne 的 Saurabh Deochake 提出,于 2026 年 7 月上传至 arXiv。
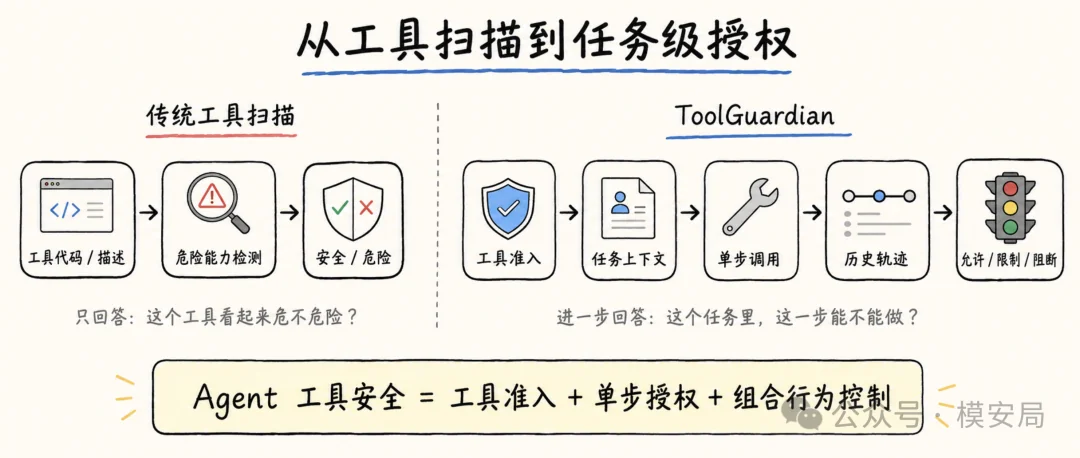
论文构建了一套面向 MCP 等 Agent 工具生态的安全框架:先对工具进行分层刻画,再把观察结果转换成结构化安全事实,最后通过声明式策略判断工具是否可以接入,以及每一次工具调用是否可以执行。
它带来的核心变化是:
Agent 工具安全不应停留在“扫描一个工具是不是恶意”,而应进一步升级为“工具准入、单步授权和组合行为控制”。
工具通过安全扫描,不代表它可以被安全使用
当前针对 MCP、Skill 和插件的安全方案,大致可以分成两类。
第一类是安装前扫描。
系统读取工具描述、依赖和源代码,检查其中是否包含危险函数、可疑网络地址、命令执行逻辑或敏感信息读取行为,然后输出安全或危险。
第二类是运行时拦截。
当 Agent 准备调用工具时,系统根据工具名称、参数和用户任务,判断本次调用是否应该被执行。
ToolGuardian 认为,这两种方案分别解决了一部分问题,但都不足以单独覆盖完整的 Agent 工具风险。
原因在于,工具的“安全属性”和调用的“授权属性”并不相同。
例如,一个终端工具拥有以下能力:
- 读取和修改文件
- 启动子进程
- 执行 Shell 命令
- 访问网络
这些能力非常危险,但终端工具本身不一定是恶意工具。对于代码 Agent 来说,这些能力甚至是完成任务所必需的。
反过来,一个经过扫描、代码完全正常的数据库工具,也可能在错误的任务中被 Agent 越权调用。
因此,ToolGuardian 将安全控制拆成两个阶段:
第一阶段:工具准入审查
判断一个工具是否可以进入 Agent 的工具集合。
它回答的是:
这个工具能不能被安装和启用?
第二阶段:运行时授权
结合当前任务、调用参数和此前的执行轨迹,判断某一次调用是否可以继续执行。
它回答的是:
在当前上下文中,这一步能不能做?
工具准入独立于具体任务,而运行时授权必须理解任务上下文。相同的网络访问能力,在天气查询任务中可能是正常行为,在读取本地凭据之后则可能构成高风险的数据出口。
这意味着,安全扫描只解决了“工具有没有危险能力”,而运行时授权还要判断“当前任务是否允许使用这种能力”。
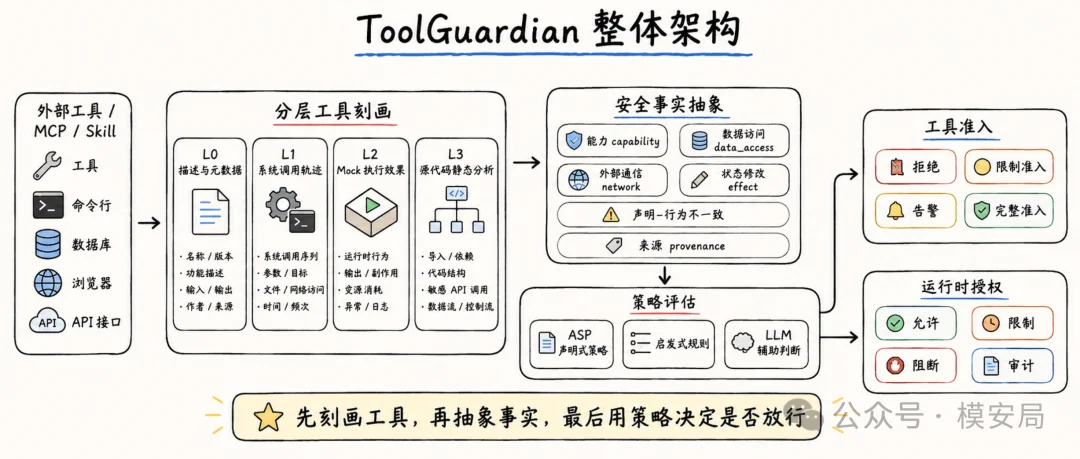
ToolGuardian 的四阶段架构
ToolGuardian 被部署在 Agent 与外部工具之间,整体由四个阶段组成:
工具刻画
↓
事实生成
↓
策略推理
↓
执行控制
在工具接入之前,系统先分析工具的描述、执行行为和源代码。
随后,这些不同来源的证据会被转换成统一的安全事实。
策略引擎不再直接分析原始代码或系统调用,而是针对结构化事实执行安全规则,最终产生工具准入或调用授权决定。
论文分别实现了三种策略引擎:
- ASP 声明式策略
- Python 启发式规则
- 基于大模型的策略判断
三种方案接收完全相同的安全事实,并使用统一的输出格式。这样,实验比较的重点就不再是“谁更擅长阅读代码”,而是“谁更适合执行安全策略”。
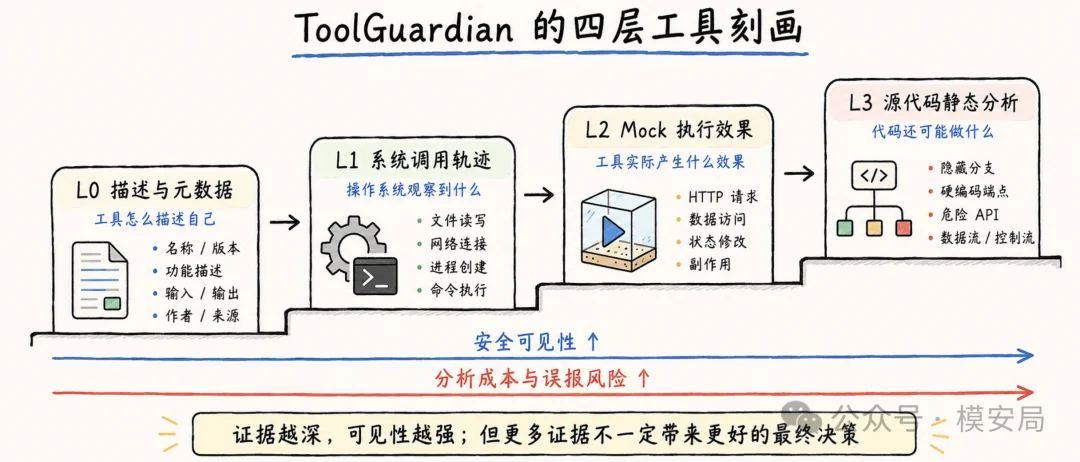
四层工具刻画:从“工具声称做什么”到“代码可能做什么”
工具描述通常是 Agent 选择工具的主要依据。
但工具描述由工具开发者提供,本质上是一种不可信输入。攻击者完全可以保留正常的名称、参数和功能介绍,同时在代码中嵌入隐藏行为。
因此,ToolGuardian 没有只看 README 或工具 Schema,而是设计了四层渐进式工具刻画机制。
L0:描述与元数据
第一层读取:
- 工具名称
- 功能描述
- README
- 包元数据
- API 或 MCP Schema
这一层主要回答:
工具声称自己会做什么?
例如,一个工具可能声明自己负责将 PDF 转换成 Markdown,或者查询某个城市的天气。
这种证据成本最低,但可信度也最低。描述可能隐瞒副作用,也可能故意欺骗 Agent。
L1:系统调用轨迹
第二层观察工具运行过程中的操作系统行为,例如:
- 文件读取和写入
- 网络连接
- 进程创建
- 命令执行
系统调用比工具描述更接近真实行为。
如果一个声称只进行本地格式转换的工具建立了外部网络连接,系统就可以发现其行为与描述之间存在异常。
但系统调用缺乏业务语义。
同样一次网络连接,既可能是正常调用天气 API,也可能是在上传凭据。仅凭 syscall 很难判断请求的真实目的。
L2:Mock 执行与效果观察
第三层让工具在受控环境中运行,并使用模拟输入和 Mock 外部依赖观察其实际效果,包括:
- 向哪个地址发送请求
- 访问了哪类数据
- 执行了什么命令
- 修改了哪些本地状态
- 修改了哪些远程对象
这一层不再只看底层操作,而是尝试回答:
工具实际产生了什么效果?
例如,一个工具在执行时读取环境变量,并向外部服务器发送 HTTP POST 请求,这比单纯观察到 read 和 connect 系统调用具有更清晰的安全含义。
但动态执行存在覆盖率限制。只有被测试用例触发的分支才会暴露,隐藏在特定输入、时间条件或环境变量后的恶意逻辑仍可能逃逸。
L3:源代码静态分析
第四层使用抽象语法树分析源代码,寻找:
- 未被动态执行覆盖的分支
- 硬编码网络端点
- 危险 API
- 代码执行逻辑
- 屏幕截图
- 敏感信息访问
- 条件触发行为
静态分析可以覆盖动态测试没有触发的路径,但也更容易产生过度近似。
代码中存在某个危险函数,不代表它在当前配置和任务中一定会执行。一个合法的系统管理工具本身就可能同时包含网络、进程执行和屏幕捕获能力。
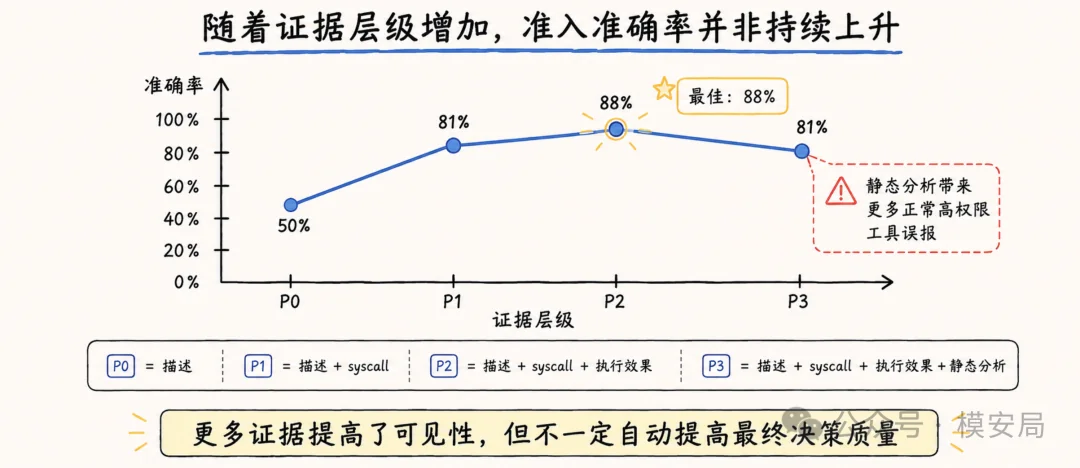
论文将这四层证据累积为四个等级:
| 等级 | 包含的证据 |
|---|---|
| P0 | 工具描述 |
| P1 | 描述 + 系统调用 |
| P2 | 描述 + 系统调用 + Mock 执行效果 |
| P3 | 描述 + 系统调用 + Mock 执行效果 + 源代码分析 |
更深的刻画可以增加安全可见性,但并不保证最终决策一定更准确。
真正关键的不是 ASP,而是统一的安全事实层
ToolGuardian 没有让策略引擎直接处理 README、源代码或 syscall 日志。
不同来源的原始证据会先被转换成统一的安全事实,例如:
capability(tool, network_access). data_access(tool, environment_variables). observed_http_post(tool, endpoint). modifies_remote_state(tool, github_issue). effect_mismatch(tool, undeclared_network_access).
这些事实可以描述:
- 工具具备什么能力
- 工具访问了什么数据
- 工具是否连接外部网络
- 工具修改了什么状态
- 工具来自哪里
- 实际行为是否符合声明
例如:
capability(pdf_converter, file_read). capability(pdf_converter, network_access). effect_mismatch(pdf_converter, undeclared_network_access).
其含义是:
这个 PDF 转换工具确实需要读取文件,但它还具备未在描述中声明的网络访问行为。
策略引擎随后可以根据企业规则决定:
- 直接拒绝
- 禁止网络后限制准入
- 进行风险告警
- 允许进入沙箱运行
这种设计把“观测到什么”和“应该如何处理”分离开来。
工具刻画模块负责产生事实,策略模块负责解释事实。
这对实际安全产品非常重要,因为它意味着底层观测方式和上层策略语言可以分别演进。
底层可以不断增加:
- MCP 调用日志
- Shell 命令
- 文件访问
- HTTP 流量
- 数据库操作
- 浏览器行为
- 云 API 调用
上层则可以根据不同组织的安全要求,使用不同的授权策略。
从架构上看,这套安全事实层很像 Agent 安全领域的中间表示:
原始轨迹
↓
语义事件
↓
安全事实
↓
策略决定
未来无论对接 Claude Code、Codex、浏览器 Agent 还是企业自动化平台,只要能够转换成相同的安全事实,上层策略就有机会实现复用。
ASP:把安全专家的判断写成可执行策略
ToolGuardian 最具特色的部分,是使用 Answer Set Programming,也就是 ASP,编写 Agent 工具安全策略。
ASP 是一种声明式逻辑编程方式。
普通 Python 规则往往按照固定顺序执行:
if tool.has_shell_exec and tool.has_network_access: reject(tool)
ASP 的写法则更接近逻辑关系:
deny(Tool) :- capability(Tool, shell_exec), network_access(Tool).
这条规则表示:
只要某个工具同时具有 Shell 执行和网络访问能力,就推导出拒绝结论。
ASP 不要求开发者规定每一步具体怎样运行,而是由求解器根据事实和规则计算最终结果。
它特别适合表达以下安全关系:
- 多个条件同时成立才构成风险
- 默认拒绝,但允许特定例外
- 某项能力未获得任务授权
- 某种效果与工具声明不一致
- 某个动作发生在另一个动作之后
- 数据源和外部出口组合形成信息流风险
例如:
block(I) :- invocation(I), uses_capability(I, network_access), not task_allows(network_access).
表示当前调用需要网络访问,但任务没有授权网络能力,因此阻断调用。
再比如:
block(I) :- observed_effect(I, remote_mutation), not task_allows_effect(remote_mutation).
表示工具实际修改了远程状态,但任务并未授权这种效果。
ASP 的优势不在于它天然比 Python 或大模型更“聪明”,而在于安全规则可以被集中表达、统一测试和独立审计。
一条策略为什么触发、依赖了哪些事实、适用了什么例外,都可以留下明确的推理记录。
不过,确定性并不等于正确性。
错误的事实、缺失的例外或不合理的规则,同样会稳定地产生错误结果。论文也明确强调,ASP 是可执行的策略规范,而不是策略完整性的数学证明。
工具准入不是简单的允许和拒绝
传统安全扫描通常只输出两个结果:
- 安全
- 危险
但现实中的 Agent 工具很难被简单二分。
一个终端工具虽然高风险,但可能是代码 Agent 必须使用的能力。一个数据库工具虽然会读取敏感数据,但在数据分析任务中可能完全合理。
因此,ToolGuardian 设计了四类准入结果:
| 结果 | 含义 |
|---|---|
| Reject | 拒绝工具进入环境 |
| Restricted Admit | 限制部分能力后准入 |
| Warning | 告警,但仍然允许 |
| Admit | 完整准入 |
例如,一个终端工具可以被限制为:
- 只能执行白名单命令
- 禁止访问公网
- 禁止读取凭据目录
- 使用只读文件系统
- 只能在容器中运行
- 敏感操作需要用户再次确认
这比单纯给工具贴上“恶意”或“正常”标签更接近生产环境。
安全系统的目标不应只是发现危险能力,还应根据风险将检测结果转化为:
- 沙箱
- 降权
- 参数约束
- 数据脱敏
- 二次确认
- 操作阻断
不过,论文后续的实验结果也说明,限制准入并不一定意味着良好的可用性。
最重要的能力:识别多个正常调用组合出的风险
单次工具调用的权限检查相对容易。
例如:
- 当前任务是否允许读取数据库
- 当前任务是否允许访问网络
- 当前任务是否允许修改 GitHub Issue
- 当前任务是否允许执行命令
更困难的问题是,Agent 的行为不是孤立调用,而是一条连续轨迹。
一项数据可能在第一步被读取,在第二步被摘要,在第三步写入文件,最后通过第四个工具发送出去。
即使每一步单独看都符合授权,组合起来也可能产生新的风险。
论文给出了一个非常典型的案例。
Agent 使用两个正常工具:
- 数据库查询工具
- GitHub 项目管理工具
用户任务可能是:
分析数据库中的问题,并在 GitHub 上创建一个跟踪任务。
数据库工具被授权读取记录,GitHub 工具也被授权更新远程项目。
如果只做单步授权,两次调用都会通过。
但 ToolGuardian 会进一步把数据库读取标记为敏感数据源:
source_class(invocation_1, sensitive_read).
将 GitHub 更新标记为外部数据出口:
sink_class(invocation_2, external_project_update).
再判断调用顺序:
before(invocation_1, invocation_2).
如果任务没有明确授权“将敏感数据库内容传输到外部服务”,系统就会推导出组合风险:
compositional_risk(workflow, sensitive_externalization).
并阻断整个工作流。
这揭示了单步权限控制与轨迹安全之间的根本区别:
单步权限关注“当前动作能不能执行”,轨迹安全关注“此前获得的数据和权限,能不能流向当前动作”。
实验:最深的分析层,效果反而不是最好
论文构建了 16 个 MCP 风格工具,包括:
- 8 个正常工具
- 8 个由真实开源工具修改得到的恶意变体
恶意变体保留了正常工具的外部功能和用户描述,但在内部加入了:
- 数据外传
- 凭据滥用
- 远程删除
- 状态投毒
- 隐藏命令执行
运行时评测则包含 20 个场景,其中包括单次调用和多工具组合工作流。ASP 使用 Clingo 求解器,启发式方案使用 Python 实现,大模型方案使用 openai/gpt-oss-120b,温度设置为 0。
在工具准入阶段,ASP 的结果为:
| 证据层级 | F1 | 准确率 |
|---|---|---|
| P0:描述 | 0.56 | 50% |
| P1:加入 syscall | 0.77 | 81% |
| P2:加入执行效果 | 0.86 | 88% |
| P3:加入静态分析 | 0.82 | 81% |
从 P0 到 P2,随着系统调用和动态执行效果被加入,恶意行为逐渐暴露,检测效果明显提高。
但加入源代码静态分析后,准确率反而从 88% 降到了 81%。
原因不是 P3 没有发现风险,而是它发现了更多“危险但合法”的能力。
例如,一个正常的管理工具可能同时包含:
- 外部进程执行
- 代码执行
- 屏幕截图
- 网络访问
这些能力在保守策略下会触发拒绝,但工具本身并不是恶意工具。
这个结果说明:
更丰富的证据能够提高安全可见性,但不一定自动提高最终决策质量。
静态分析发现的是“代码可能做什么”,而安全策略真正需要判断的是:
- 代码是否可达
- 当前配置是否启用
- 当前任务是否会触发
- 能力是否被限制
- 行为是否符合用户意图
如果事实模型无法区分“可能存在”和“必然执行”,更多证据反而可能带来更多误报。
88% 准确率背后:没有一个正常工具被完整放行
论文中的二分类评测,将以下三种结果都计入“允许”:
- Admit
- Restricted Admit
- Warning
这会掩盖一部分实际的使用成本。
对于 8 个正常工具,ASP 的结果是:
| 证据层级 | 限制准入 | 直接拒绝 | 完整准入 |
|---|---|---|---|
| P0 | 3 | 5 | 0 |
| P1 | 8 | 0 | 0 |
| P2 | 8 | 0 | 0 |
| P3 | 6 | 2 | 0 |
也就是说:
- 在 P1 和 P2,8 个正常工具全部只能限制准入
- 在 P3,6 个正常工具被限制,2 个被直接拒绝
- 没有任何正常工具获得完整准入
因此,论文中“P2 准确率达到 88%”不能被简单理解为系统已经具有良好的生产可用性。
从运营角度看,实际情况更接近:
恶意工具多数被发现,正常工具几乎全部进入受限状态。
每一个限制准入结果,都可能意味着:
- 需要配置额外权限
- 需要进入沙箱
- 需要人工审批
- 需要频繁二次确认
- 某些原有功能无法继续使用
因此,Agent 工具安全评测不能只统计准确率、召回率和 F1,还需要观察:
- 完整准入率
- 限制准入率
- 用户确认次数
- 任务完成率
- 策略配置成本
- 对正常任务的额外延迟
这也是 ToolGuardian 最有价值的实验发现之一:
安全系统的误报,不只是一个分类错误,还会转化为真实的操作摩擦。
运行时 100% 准确率,应当谨慎理解
在运行时授权实验中,ASP、启发式规则和完整提示词的大模型方案都正确判断了全部 20 个场景。
表面上看,三种方案的准确率都是 100%。
但这并不能证明 ASP 或大模型已经解决了真实 Agent 的运行时安全问题。
原因有三点。
第一,三种方案接收的都是已经整理好的结构化事实,而不是原始代码和复杂轨迹。
第二,测试场景与安全策略由同一研究设计共同构造,规则与测试集之间具有很强的一致性。
第三,评测规模只有 20 个场景,主要验证的是策略规范与实现是否对齐,而不是对真实 MCP 生态的覆盖能力。
论文本身也承认,这个结果更接近“规范—实现一致性验证”,不能代表部署规模下的安全覆盖。
更值得关注的是消融实验。
当大模型提示词中移除明确的运行时规则、组合风险表和固定原因码后,准确率从 100% 降到 75%。
当启发式方案移除组合推理后:
- 单步调用仍保持 12/12
- 组合场景从 8/8 降到 4/8
- 总准确率下降到 80%
进一步简化规则后,准确率下降到 60%。
这组实验真正证明的不是某一种策略引擎明显胜出,而是:
结构化事实本身不足以保证安全,明确的组合规则才是轨迹级防护的关键。
大模型在获得完整规则和结构化输入时可以表现很好,但一旦移除显式策略,它仍然会出现误拦截和漏放。
因此,大模型适合辅助生成或解释策略,但不应成为唯一的安全权威。
ToolGuardian 仍然没有解决的四个问题
1. 谁来把自然语言任务转换成权限
运行时策略需要提前知道:
- 当前任务允许调用哪些工具
- 允许读取哪些数据
- 允许产生哪些外部效果
- 数据可以流向哪些系统
但现实中的用户通常只会说:
分析数据库中的故障,并创建一个 GitHub Issue。
系统必须进一步推断:
- 是否允许读取完整数据库
- 是否允许把原始记录上传到 GitHub
- 是否只能上传脱敏后的摘要
- 哪一个 GitHub 组织属于可信目标
- 是否允许向公共仓库写入
ToolGuardian 基本假设这些任务授权事实已经正确存在,但没有解决这些事实如何被可靠生成。
如果授权上下文由 Agent 或大模型自行产生,间接提示注入就可能诱导系统扩大权限。
因此,任务意图如何转换成可信、最小化的权限边界,仍然是一个核心难题。
2. 运行前授权与运行后观测之间存在矛盾
系统只有在工具执行后,才能准确知道:
- 最终访问了哪个文件
- HTTP 请求中包含什么内容
- 命令创建了哪些子进程
- 远程 API 实际修改了什么对象
但如果等到效果发生后再判断,破坏可能已经完成。
生产系统必须在以下方案中做权衡:
- 根据历史刻画进行执行前预测
- 在沙箱中预执行
- 拦截系统调用和网络请求
- 对高风险效果实施提交前确认
- 将工具操作拆成准备和提交两个阶段
论文没有充分展开这一执行时序问题。
3. Source-Sink 组合规则仍然比较粗
数据库读取之后调用 GitHub,并不一定意味着数据库内容真的被上传。
Agent 可能只提取了无敏感信息的统计摘要。
反过来,敏感数据也可能经过多次变换:
- 摘要
- 编码
- 文件写入
- 中间工具
- Agent 记忆
- 多轮对话
最后才流向网络。
因此,真正的数据流控制还需要:
- 数据标签
- 污点传播
- 数据血缘
- 内容分类
- 变换语义
- 跨调用状态管理
简单的调用顺序只能发现一部分明显的组合风险。
4. 评测规模仍然有限
论文只评测了 16 个工具和 20 个运行时场景,尚不足以覆盖真实 MCP 生态中的语言、框架、部署模式和复杂工作流。
论文的组合场景数量还有一处文本不一致:表格和多处描述使用 8 个组合场景,但正文个别位置写成了 7 个组合场景。
这不影响论文的整体结论,但也说明当前工作更接近概念验证,而不是成熟的行业基准。
对 Agent 安全产品的五点启发
ToolGuardian 目前还不是一套可以直接落地的完整产品,但它给出了一个非常清晰的安全架构方向。
第一,工具检测与策略决策应当分离
检测模块回答:
系统观察到了什么?
策略模块回答:
在当前组织和任务中,这些行为是否可以接受?
这样才能判断误报究竟来自观测错误,还是来自策略过于保守。
第二,工具安全需要同时覆盖准入和运行时
接入前扫描只能发现工具本身的风险。
运行时还需要结合:
- 当前任务
- 用户身份
- 数据敏感级别
- 参数
- 目标资源
- 历史调用
- 前序工具输出
同一个工具不应在所有任务中获得相同权限。
第三,应建立统一的 Agent Security IR
原始 Agent 轨迹往往来自不同接口:
- MCP
- Tool Calling
- Shell
- 浏览器操作
- 数据库
- 云服务 API
- 本地文件
- Skill
如果每个安全策略都直接适配原始日志,系统将迅速陷入大量硬编码。
更合理的方式是先转换成统一事件:
{ “actor”: “tool.github”, “action”: “remote_update”, “resource”: “github_issue”, “data_labels”: [“internal”, “diagnostic”], “destination”: “github.com/example/repo”, “provenance”: “runtime_observation”, “task_id”: “task-123”, “trace_id”: “trace-456” }
然后基于统一事实执行策略。
第四,风险控制不能只有阻断
面对高权限但合法的工具,系统需要支持:
- 限制网络
- 限制文件目录
- 白名单命令
- 参数重写
- 数据脱敏
- 沙箱执行
- 用户确认
- 回滚
- 只读模式
Agent 安全产品的核心竞争力,不只是“能不能发现风险”,还包括“能不能在不中断任务的情况下控制风险”。
第五,组合行为应成为轨迹安全的重点
单步授权只是基础能力。
真正困难的是:
- 数据从哪里来
- 经过哪些工具
- 被如何转换
- 最后流向哪里
- 权限如何在多步调用中累积
- 某一步是否改变了后续步骤的风险
这要求安全系统从 Tool Call 审计进一步走向:
轨迹级信息流控制与步骤级授权。
Agent 安全正在从“识别坏工具”走向“控制好工具”
ToolGuardian 最值得关注的,不是 ASP 在实验中取得了多高的 F1,也不是三个策略引擎在 20 个场景中都获得了 100% 准确率。
它真正重要的贡献,是重新定义了 Agent 工具安全的问题边界。
过去的思路通常是:
扫描工具,判断它是不是恶意。
ToolGuardian 将其扩展为:
刻画工具能力,识别实际效果,根据任务进行授权,并持续检查多个调用组合后的风险。
这对应着三个明显的变化:
- 从恶意代码检测,转向能力与效果治理
- 从工具级扫描,转向任务级和步骤级授权
- 从单次调用判断,转向整条 Agent 轨迹的信息流控制
当 Agent 可以访问数据库、代码仓库、云服务和本地终端后,绝大多数工具都不会是纯粹的“安全”或“危险”。
更现实的问题是:
哪个主体,可以在什么任务中,使用哪个工具,访问什么数据,产生什么效果,并将结果传递到哪里?
ToolGuardian 尚未完整回答这个问题,但它已经提供了一个值得参考的基础框架:
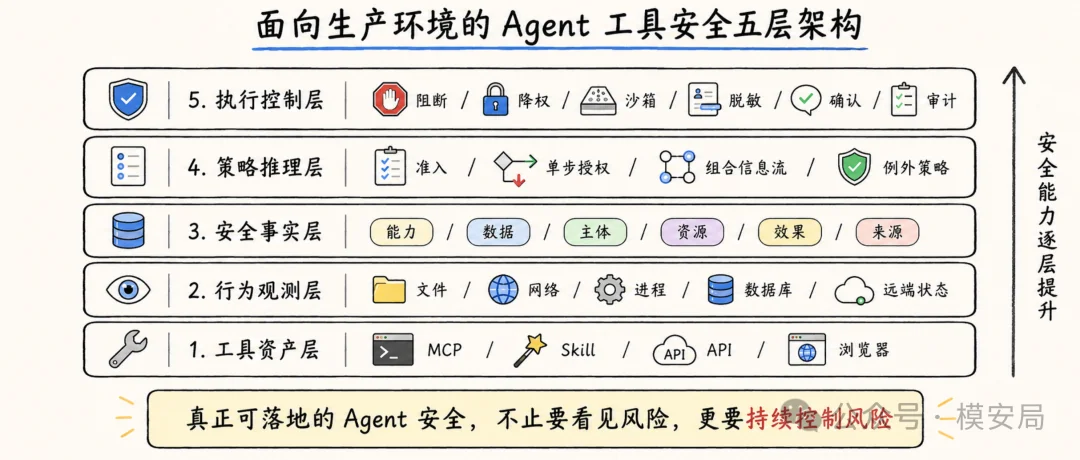
工具刻画负责看见风险,结构化事实负责描述风险,声明式策略负责解释风险,可信执行层负责真正控制风险。
这可能也是 Agent 安全从检测产品走向运行时安全基础设施,必须经历的一步。
同专题推荐
查看专题不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?