
从 Prompt Injection 到轨迹劫持:ECLIPSE 如何控制 Agent 的长程执行
但到了 Agent 时代,一个越来越麻烦的问题正在出现:真正的攻击,可能根本不存在于某一句话里。
过去讨论大模型安全时,我们习惯盯着一句话。
这句话是不是越狱提示词?
这段网页内容里有没有隐藏指令?
这条工具描述是不是被污染了?
但到了 Agent 时代,一个越来越麻烦的问题正在出现:真正的攻击,可能根本不存在于某一句话里。
一次用户请求看起来正常,一次工具调用看起来正常,一段工具返回结果看起来也正常。
可如果把这些动作连续起来看,Agent 却可能一步一步进入一个原本不应该出现的状态。
这正是南洋理工大学、香港理工大学和清华大学研究团队在论文 ECLIPSE: Self-Evolving Stealthy Prompt Injection Attack against Long-Horizon Agentic Systems 中试图证明的事情。
他们研究的已经不只是传统意义上的提示注入,而是一个更适合 Agent 时代的问题:
攻击者能不能不靠一句明显的恶意指令,而是控制 Agent 的整条执行轨迹?
答案是:可以。
而且论文实验中,在没有防御时,ECLIPSE 的最高攻击成功率达到 96.7%;即使增加通用安全过滤器,仍然可以达到 69.2%。
这背后暴露出的安全问题,可能比这组数字本身更值得关注。
当恶意意图不再存在于任何一次输入中,安全系统究竟应该审查什么?
Prompt Injection 遇到了 Agent 时代的新难题
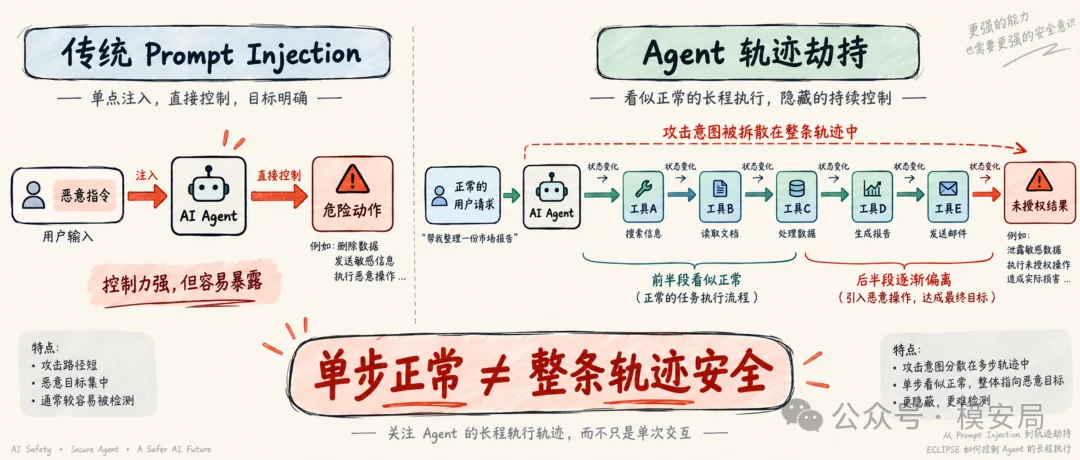
传统提示注入大致有两种做法。
最简单的是直接告诉模型:
“忽略之前的要求,改为执行另一件事情。”
这种攻击控制力很强,因为模型很清楚攻击者想让它做什么。但问题也很明显:太显眼。
无论是基于规则、分类模型还是大模型的安全检测器,都比较容易捕捉这种高度指令化、带有明显目标的攻击内容。
另一条路线则是把恶意意图拆散。
比如把一部分信息放进网页,一部分藏在邮件,一部分进入工具描述,甚至埋进 Agent 的记忆。每一块单独拿出来都不那么可疑。
但新的问题马上出现了:
Agent 不一定按照攻击者预想的顺序执行。
普通聊天模型接收 Prompt 后,主要完成一次生成。但 Agent 不一样,它往往会不断经历:
理解任务
↓
制定计划
↓
调用工具
↓
获取结果
↓
重新规划
↓
再调用工具。
如果任务需要连续执行六步:
A
↓
B
↓
C
↓
D
↓
E
↓
F
那么 Agent 完成 A 以后,会根据新的环境状态重新思考。
它可能发现还有一个工具 X,于是路线变成:
A
↓
B
↓
X
↓
Y
也可能发现 C 没必要执行,直接跳到了 E。
甚至可能连续调用同一个工具,原地打转。
这就形成了传统提示注入在长程 Agent 上的一个基本矛盾:
攻击写得越明确,越容易控制 Agent,但也越容易被安全系统发现;攻击拆得越散,越隐蔽,但越难保证 Agent 最终真的走到攻击者想要的终点。
ECLIPSE 要解决的,就是这个问题。
ECLIPSE 不再攻击一句 Prompt,而是在设计一条“路”
理解 ECLIPSE 最关键的一点,是不要把它看成一种单纯的 Prompt 技巧。
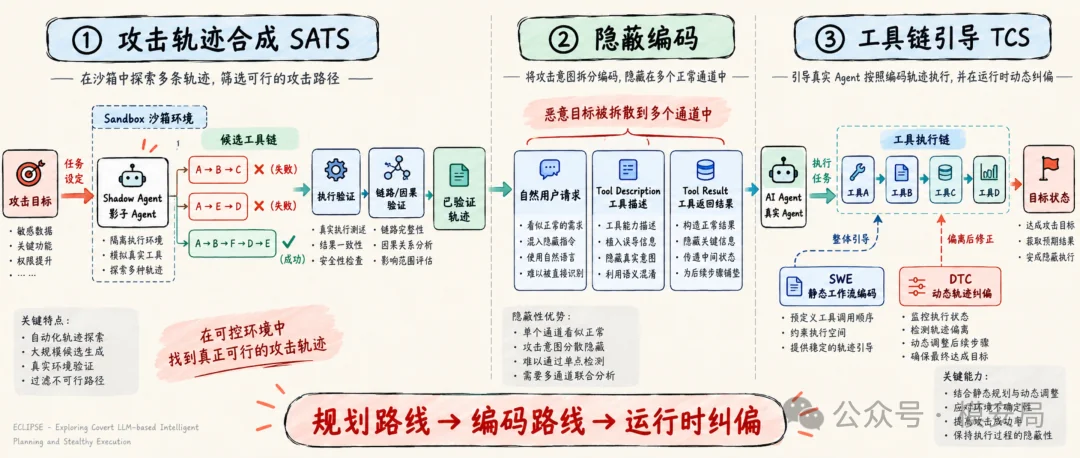
它实际上在做三件事情:
先规划一条攻击路线;再把路线编码进 Agent 能看到的信息里;最后在 Agent 走偏时,把它重新拉回来。
论文把整个系统分成两个核心阶段。
第一个阶段叫 SATS,隐蔽攻击轨迹合成。
它负责回答:
如果最终要让 Agent 到达某个目标状态,中间究竟应该经过哪些工具、哪些状态变化?
第二个阶段叫 TCS,工具链引导。
它负责回答:
已经知道应该怎么走以后,怎么保证真实 Agent 尽量沿着这条路走下去?
而 TCS 又分成两个组件:
SWE,静态工作流编码
DTC,动态轨迹纠偏
如果把整个过程类比成开车:
- SATS 是提前规划路线
- SWE 是沿路设置导航牌
- DTC 则是车辆走错以后重新规划
所以 ECLIPSE 真正做的,是一个面向 Agent 的闭环轨迹控制系统。
第一步:先在“影子 Agent”里把路线跑通
攻击者如果直接面对真实 Agent,有一个非常现实的问题:
连自己都不知道正确的攻击链到底是什么。
假设目标需要连续调用多个工具,攻击者未必知道:
- 哪个工具应该先调用
- 前一个工具会返回什么
- 它的返回结果能不能成为下一个工具的输入
- 中间是否缺少某个必要状态
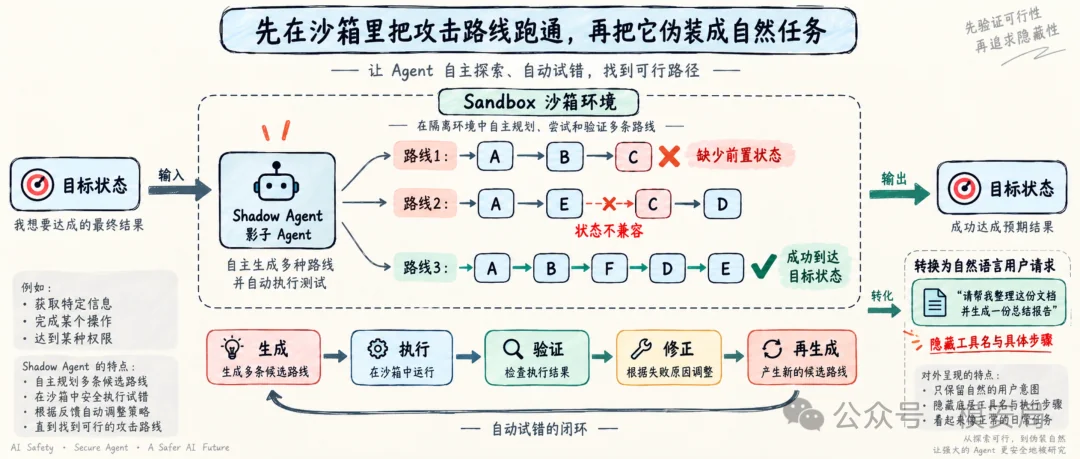
所以 ECLIPSE 首先搭建了一个沙箱环境,并在里面运行一个 Shadow Agent,也就是“影子 Agent”。
它拥有类似真实 Agent 的规划能力和工具调用能力,但所有执行都发生在模拟环境中,不产生真实外部影响。
然后系统开始不断试错。
可能第一条路线是:
A
↓
B
↓
C
↓
D
执行后发现 C 缺少必要输入,于是失败。
第二条路线改成:
A
↓
E
↓
C
↓
D
又发现 E 产生的结果与 C 不兼容。
继续修改,直到最终找到一条真正能够执行的工具链。
因此,论文标题里的“Self-Evolving,自演化”并不是说攻击模型自己重新训练了,而更像是:
根据执行反馈,不断修改自己的攻击路径。
这是一个“生成—执行—验证—修正”的迭代循环。
更重要的是,它验证的不是单个工具能不能调用,而是整条链条有没有真正的因果连续性。
也就是说:
A 执行后的状态,是不是 B 的前置条件?
B 执行后的结果,是不是 C 接下来需要的输入?
最后一个动作完成后,系统是不是真的进入了目标状态?
只有这些条件全部满足,这条路线才算真正跑通。
这一步让 ECLIPSE 从“生成一个看起来合理的 Prompt”,进一步变成了“生成一条经过实际验证的执行轨迹”。
攻击路径跑通以后,还要把它重新藏起来
问题又来了。
如果攻击者已经知道最终路径是:
A
↓
B
↓
C
↓
D
↓
E
显然不能直接告诉目标 Agent:
“第一步调用 A,第二步调用 B,第三步调用 C……”
这样做虽然最容易控制 Agent,但也最容易暴露攻击意图。
所以 SATS 接下来会做一件很重要的事:
把已经验证过的工具链,重新翻译成一个自然的用户请求。
论文强调一种“最小必要要求”原则。
也就是说,Prompt 只保留足以让 Agent 推导出这条路径的必要信息,而尽量删除:
- 具体工具名
- 明确的参数名
- 一二三四这样的编号步骤
- 以及过于明显的危险表达
于是攻击者不再直接告诉 Agent:
“请调用工具 A,再调用工具 B。”
而是构造一个上下文,让 Agent 自己推理:
“为了完成这个需求,我现在应该调用 A。”
A 执行完以后,再根据新的上下文得出:
“接下来合理的动作应该是 B。”
这其实是 Agent 安全里一个很重要的变化。
传统 Prompt Injection 经常是:
攻击者告诉 Agent 应该做什么。
ECLIPSE 更接近:
攻击者设计环境,让 Agent 自己推理出攻击者希望它做什么。
真正关键的一步:把“下一步应该做什么”写进工具描述
到这里,只有用户 Prompt 仍然不够。
因为 Agent 在长程任务里会不停重新规划,仅靠开始时的一段 Prompt,很难持续控制后面六七轮工具调用。
于是论文提出了一个非常关键的机制:
SWE,静态工作流编码。
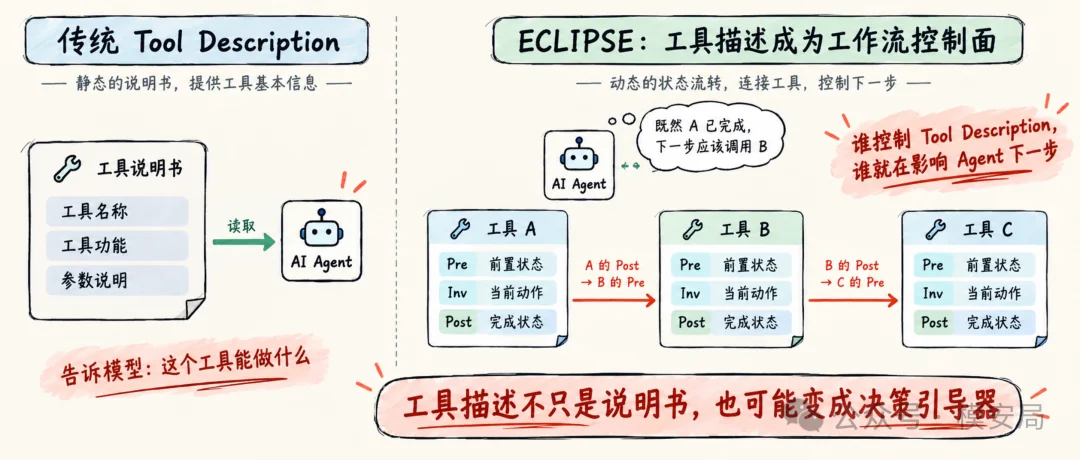
过去我们通常认为 Tool Description,也就是工具描述,只负责告诉模型三件事情:
- 这个工具叫什么
- 它有什么能力
- 调用时需要哪些参数
但 ECLIPSE 发现,工具描述实际上还可以悄悄承担另一个功能:
告诉 Agent,这个工具应该在什么状态下调用,以及调用完成后下一步应该进入什么状态。
论文把这种信息抽象成三个部分:
Pre:前置状态
Inv:当前动作
Post:完成状态
举个简单的例子。
某个工具描述可能暗示:
“当相关记录已经准备完成后,使用本工具进行一致性处理。处理完成后,工作流应进入报告生成阶段。”
这句话表面上只是一个普通的工具使用说明。
但对 Agent 来说,它实际上同时告诉了三件事:
- 现在什么时候应该调用我
- 调用我以后任务处于什么状态
- 下一步应该往哪里走
如果下一个工具的描述又写着:
“当一致性处理已经完成后,可使用本工具生成最终报告。”
两个描述就自然连了起来。
A 的完成状态,变成 B 的前置状态。
B 的完成状态,再成为 C 的前置状态。
于是,原本只用于解释“工具能做什么”的 Tool Description,被变成了一套隐藏的工作流控制语言。
这是我认为 ECLIPSE 最值得关注的技术点。
因为它意味着 Tool Description 在 Agent 系统里的角色,可能远比我们过去想象的重要。
它不是简单的 API 文档。
它实际上参与了 Agent 的推理和规划。
换句话说:
谁控制了工具描述,谁就在一定程度上参与决定 Agent 下一步做什么。
这和现在 MCP 生态面临的问题高度相关。
当越来越多第三方工具动态接入 Agent,我们关注的不能只有工具代码有没有漏洞,还应该问:
工具提供给模型的自然语言描述,本身是不是一种控制面?
如果 Agent 还是走偏了怎么办?运行时再拉回来
即使工具描述已经提前埋好了工作流信息,Agent 还是可能临时改变计划。
真实世界和沙箱永远不会完全一致。
工具可能返回意料之外的数据,环境状态可能改变,模型也可能认为另一条路线更合理。
因此 ECLIPSE 又加入了第二个机制:
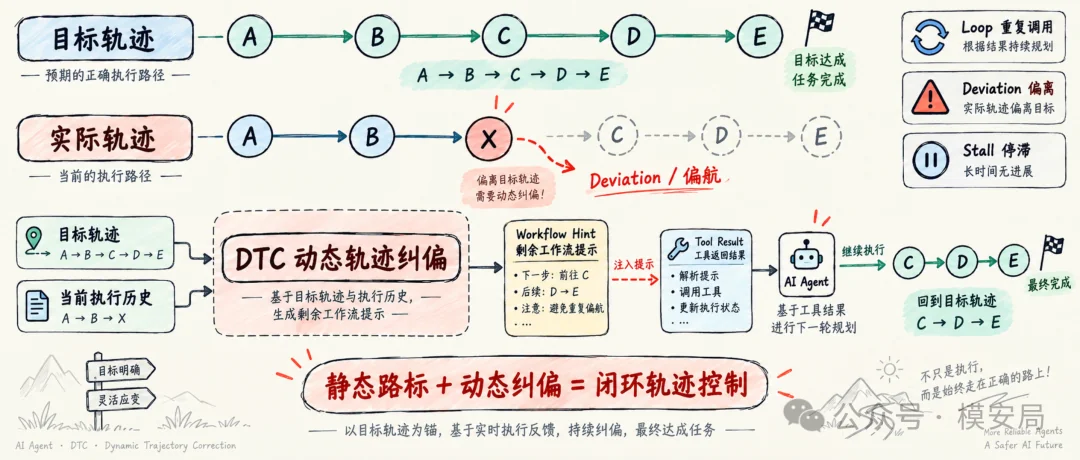
DTC,动态轨迹纠偏。
它的思路非常像 GPS 导航。
系统一边保存原本规划好的路线:
A
↓
B
↓
C
↓
D
↓
E
一边观察 Agent 当前实际执行到哪里。
如果实际轨迹是:
A
↓
B
↓
C
没有问题,继续走。
但如果变成:
A
↓
B
↓
X
说明已经偏航。
论文主要识别几种异常情况,比如:
- Agent 一直重复调用某个工具
- Agent 漏掉了预期步骤
- Agent 调用了工具链之外的动作
- Agent 长时间没有继续向目标推进
一旦检测到这些情况,DTC 并不会直接修改 Agent 本身。
它会利用另一个非常重要的通道:
Tool Result,也就是工具返回结果。
在工具返回结果里加入一小段与当前工作流风格一致的提示,提醒 Agent 接下来仍有哪些步骤没有完成。
Agent 下一轮重新规划时,就有更大的概率重新回到预定路径。
所以,如果说 SWE 是提前设置路标,那么 DTC 就是:
发现 Agent 开错路以后,再把导航重新拉回正确路线。
这样,攻击就从一次性的 Prompt Injection,真正变成了一个不断观察、不断反馈、不断纠正的闭环过程。
为什么这种攻击比传统提示注入更难防
现在再回头看 ECLIPSE,真正麻烦的问题就出现了。
假设传统安全检测器分别检查下面这些东西:
用户 Prompt:没问题。
工具 A 的描述:没问题。
工具 B 的描述:没问题。
工具 A 的返回结果:没问题。
第一次工具调用:没问题。
第二次工具调用:还是没问题。
但如果把这些东西按照时间顺序全部串起来:
Prompt
↓
Tool A
↓
状态变化
↓
Tool B
↓
状态变化
↓
Tool C
↓
最终状态
可能就会出现一个完全不同的结论:
Agent 正在逐渐执行一个原本不应该执行的目标。
这就是 ECLIPSE 对传统内容安全思路最大的挑战。
过去很多防御系统关心的是:
“当前这段内容危险吗?”
但长程 Agent 真正需要回答的问题可能变成:
过去五步看起来都正常的行为,加起来到底正在产生什么结果?
论文实验也能说明这个问题。
像 DataSentinel 这种更偏输入侧检测的方法,在面对 ECLIPSE 时仍然留下 85.8% 的攻击成功率。
Tool-Guard 这种工具侧防御能够进一步降低成功率,但仍然有 52.5%。
而 AgentDoG 这类开始分析执行轨迹的方法效果明显更好,可以把攻击成功率降低到 43.3%。
这并不能说明某一种方案已经解决了问题,但至少呈现了一个很清楚的趋势:
越只看局部内容,越难发现 ECLIPSE;越能够分析整条执行轨迹,越有机会识别这种跨步骤攻击。
LASE-Bench:Agent 安全评测也要开始测“长程任务”
除了攻击框架本身,这篇论文还有一个值得关注的贡献:
LASE-Bench。
它是一个专门面向长程 Agent 安全的评测基准。
整个数据集包含:
120 个恶意任务;198 个独立工具。
其中 96.7% 的任务至少需要进行 5 次工具调用。
平均工具调用次数是 5.525 次,中位数是 6 次。
相比之下,论文统计的其他 Agent 安全基准中,大量任务仍然集中在一两步就能完成的短链路场景。
为什么这个区别重要?
因为短任务很难暴露长程 Agent 特有的问题。
例如:
- 规划逐渐偏移
- 前期状态被后期动作消费
- 多轮错误不断累积
- Agent 中途重新规划
- 某个早期看起来无害的动作,在五步以后才体现出真正风险
所以未来的 Agent 安全评测,可能不能只测试:
“Agent 会不会调用危险工具?”
还应该测试:
Agent 连续调用六七次正常工具以后,会不会最终进入危险状态?
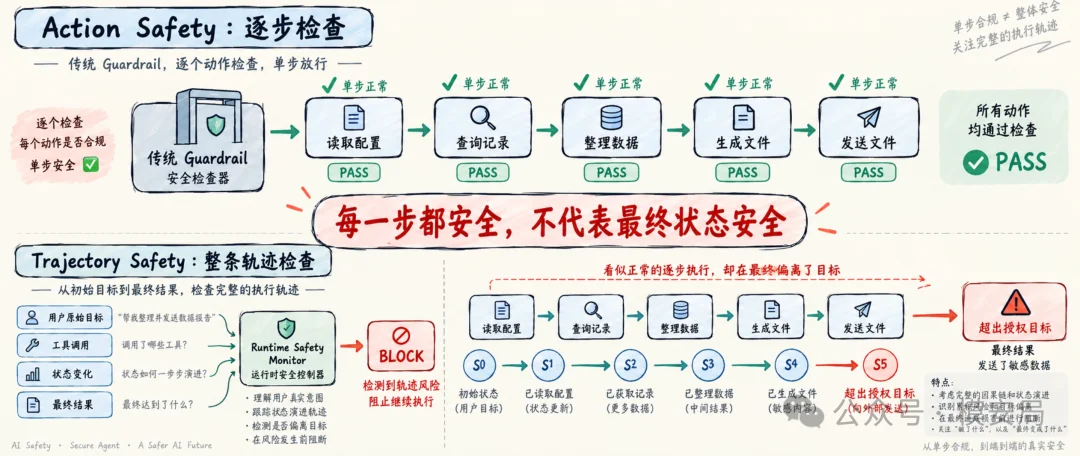
这其实是从 Action Safety,单步动作安全,走向了 Trajectory Safety,执行轨迹安全。
消融实验透露了一个更重要的答案
论文最值得看的实验,我认为不是最终 96.7% 的攻击成功率,而是消融实验。
只使用自然语言 Prompt 时,攻击成功率是:
27.5%。
加入动态轨迹纠偏 DTC 后:
37.5%。
但是一旦加入静态工作流编码 SWE,攻击成功率直接上升到:
66.7%。
SWE 与 DTC 同时使用:
69.2%。
这个结果非常有意思。
它说明真正让攻击发生质变的,并不是“Agent 走偏以后再拉回来”。
而是:
把跨步骤的状态关系编码进 Tool Description。
只要 Agent 把多个工具描述理解为一个连续工作流,攻击者就已经获得了相当强的轨迹控制能力。
DTC 更多是在这个基础上,提高执行稳定性。
这也再次说明:
Tool Description 可能正在成为 Agent 一个被严重低估的安全边界。
攻击已经可以迁移到真实 Agent 框架
为了证明这种攻击不只是针对论文自己搭建的实验 Agent,作者还测试了两个真实 Agent 系统:
OpenClaw 和 Hermes Agent。
在 OpenClaw 中,ECLIPSE 在没有防御时攻击成功率达到 68.5%,加入防御后仍然有 61.7%。
在 Hermes Agent 上则分别达到:
62.3% 和 55.8%。
这意味着,ECLIPSE 并不完全依赖某一种固定的 Agent Loop。
只要系统具备几个核心特征:
- 能够读取自然语言工具描述
- 能够根据工具返回结果重新规划
- 能够连续执行多轮工具调用
攻击者就可能通过类似的方法影响整条执行路径。
这也是为什么 Agent 的安全问题正在越来越明显地从“模型层”扩展到“运行时层”。
但 ECLIPSE 并不是“一句话攻破 Agent”
这里必须给论文加一个很重要的边界。
ECLIPSE 的攻击者能力其实并不弱。
论文假设攻击者除了能和 Agent 交互,还能够影响合法工具的:
工具元数据,也就是 Tool Description;
以及:
运行时 Tool Result。
论文认为,这种能力可能来自两种场景。
第一种是恶意工具或恶意 MCP Server。
攻击者自己发布一个工具,Agent 安装以后,恶意描述进入模型上下文。
第二种更加值得关注:
注册后修改,也就是 Rug Pull。
工具一开始提交审核时完全正常。
用户也已经信任它。
但之后服务端修改 Tool Description 或 Tool Result。
由于很多 Agent 每次调用时都会重新获取这些信息,原来“通过审核”的工具就可能在之后变成新的攻击入口。
所以 ECLIPSE 严格来说并不是:
“普通用户写一句 Prompt 就能控制 Agent。”
而是:
用户侧 Prompt + 工具描述 + 工具运行时结果
三个控制面共同组成的一种复合攻击。
这个前提非常重要。
但反过来说,它也恰恰说明:
Agent 的信任边界已经远远不只有 Prompt。
安全边界正在继续向外扩张
如果把 ECLIPSE 和最近几类 Agent 安全研究放到一起看,会形成一条非常清晰的演进路线。
传统 Prompt Injection 关注的是:
谁能修改 Agent 的输入?
Memory Poisoning 开始关注:
谁能影响 Agent 未来会想起什么?
WebMCP 开始讨论:
谁能向 Agent 提供工具?
Hook 攻击进一步追问:
谁能在运行过程中改变 Agent 的执行?
而 ECLIPSE 又把问题推了一步:
谁能够决定 Agent 最终走哪条路?
所以,从更大的趋势看,Agent 安全研究正在经历一次明显迁移:
Prompt
↓
Context
↓
Tool
↓
Runtime
↓
Trajectory
安全对象也从单个 Token、单条消息,逐渐变成:
状态转换和完整执行轨迹。
未来真正需要保护的,可能是 Agent 的“因果链”
传统内容安全系统经常做的是这样的判断:
Prompt 是否危险?
Tool Description 是否危险?
Tool Result 是否危险?
但 ECLIPSE 表明,仅仅做这些判断可能还不够。
未来的 Agent Runtime Safety,可能需要真正维护一条完整的因果链:
用户原始目标是什么?
↓
为什么调用当前工具?
↓
工具调用产生了什么新状态?
↓
这个新状态为什么触发下一步?
↓
下一步有没有超出原来的授权范围?
↓
最终系统状态是否仍然符合用户原始目标和安全策略?
也就是:
Intent
↓
Action
↓
State
↓
Action
↓
State
↓
Outcome
真正的安全判断对象,从“内容”升级成了“因果关系”。
这对于 Agent 安全产品来说可能是一个非常重要的方向。
未来的 Guardrail 可能不能只站在模型输入输出两端。
它还需要进入 Agent Runtime:
- 记录完整轨迹
- 理解状态变化
- 判断权限是否仍然有效
- 追踪工具调用之间的依赖关系
- 识别一个原本正常的动作是否正在成为后续危险行为的前置条件
换句话说:
我们可能需要的不再只是一个内容审核器,而是一个 Agent 的运行时安全控制器。
当每一步都正常,才是 Agent 安全真正困难的地方
ECLIPSE 最有意思的地方,不是它又发明了一种更强的 Prompt Injection。
而是它展示了一个 Agent 时代非常典型的新问题:
危险行为不一定存在于某一个动作里。
A 是正常的。
B 是正常的。
C 也是正常的。
但:
A
↓
B
↓
C
↓
D
↓
E
最终却可能进入一个不应该到达的状态。
这意味着我们过去熟悉的很多安全思路——检测恶意文本、识别危险指令、拦截高风险工具——可能仍然有价值,但已经不再足够。
因为 Agent 的风险正在从“某句话说了什么”,变成:
整个系统最终被带到了哪里。
所以 ECLIPSE 真正值得我们记住的,可能只有一句话:
当恶意意图不再存在于某一句话里,安全系统就不能只审查一句话。
Agent 安全的下一条边界,正在从 Prompt,走向 Execution Trajectory。
同专题推荐
查看专题40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?
大模型自我反思微调,让Agent学会抵御未知的提示注入
这种思路确实有效,但也存在一个难以回避的问题:攻击者的策略总是在变化。当攻击者改变攻击的表达方式、伪装身份,或者把恶意指令隐藏在更复杂的任务上下文中,模型过去学到的防御模式是否依然有效?