
13家机构联合提出自迭代 Agent 安全框架:4类状态、7种演化与6类安全失效
近期受到广泛关注的 RSI(Recursive Self-Improvement,递归自我改进)进一步放大了这一趋势:当一个系统不仅能够修改自身,而且修改后的系统又获得更强的自我改进能力时,Agent 的能力边界可能伴随
过去一年,Agent 正在从“完成一次任务”走向能够长期运行、积累经验并持续修改自身状态的系统。长期记忆开始保存用户偏好和历史经验,Skill 系统会将成功轨迹固化为可复用能力,工作流会根据执行结果持续调整路由与策略,一些更激进的系统甚至开始修改工具、代码、模型参数和评估器。
近期受到广泛关注的 RSI(Recursive Self-Improvement,递归自我改进)进一步放大了这一趋势:当一个系统不仅能够修改自身,而且修改后的系统又获得更强的自我改进能力时,Agent 的能力边界可能伴随一次次迭代不断变化。
这也带来了一个新的安全问题:如果 Agent 会不断改变自己,那么过去建立的安全边界能否在持续变化中被保留下来?
近期,浙江大学、华中科技大学、西安交通大学等13家机构的研究者联合发表综述《Safety in Self-Evolving Agents》,系统梳理了这一问题,并提出 SAVER 框架,试图将长期记忆、Skill、工作流、多 Agent 传播和模型自适应等看似分散的安全问题,统一到“状态转移安全”这一视角下。
什么是“自迭代 Agent”?
论文使用的原始概念是 Self-Evolving Agent,本文统一称为“自迭代 Agent”。
它并不要求 Agent 必须重新训练自己的模型。只要系统能够根据自身的观察、行为、反馈或执行轨迹,更新未来还可以继续使用的状态,并由此改变之后的行为,就已经进入自迭代范畴。这些状态既可以是长期记忆,也可以是 Skill、工具定义、工作流、多 Agent 路由,甚至 LoRA、模型参数或缓存状态。
因此,将一次用户反馈写入长期记忆、把成功任务总结成 Skill、根据失败经验修改工作流,本质上都属于同一类机制:过去发生的事件被转化为了未来仍然能够产生影响的状态。
论文将这种能力概括为 Reusable Influence,即“可复用影响”。这也是理解整篇论文的关键:真正发生变化的并不只是某段数据,而是这段数据在未来继续影响 Agent 决策的能力。
自迭代 Agent 与近期受到关注的 RSI 高度相关,但并不完全等同。
前者强调系统能够持续修改自身的可复用状态;RSI 则进一步要求这种修改能够提升系统下一轮继续改进自身的能力,形成递归增强。因此,RSI 可以视为更强的一类自迭代形态。SAVER 并不是专门针对 RSI 提出的框架,但其关注的状态追踪、权限漂移、后代状态和持续演化验证,同样是更强 RSI 系统绕不开的安全基础。
一个核心转变
从“行为安全”到“状态转移安全”
SAVER 最重要的变化,不是重新整理了一套攻击分类,而是重新定义了 Agent 安全的分析对象。
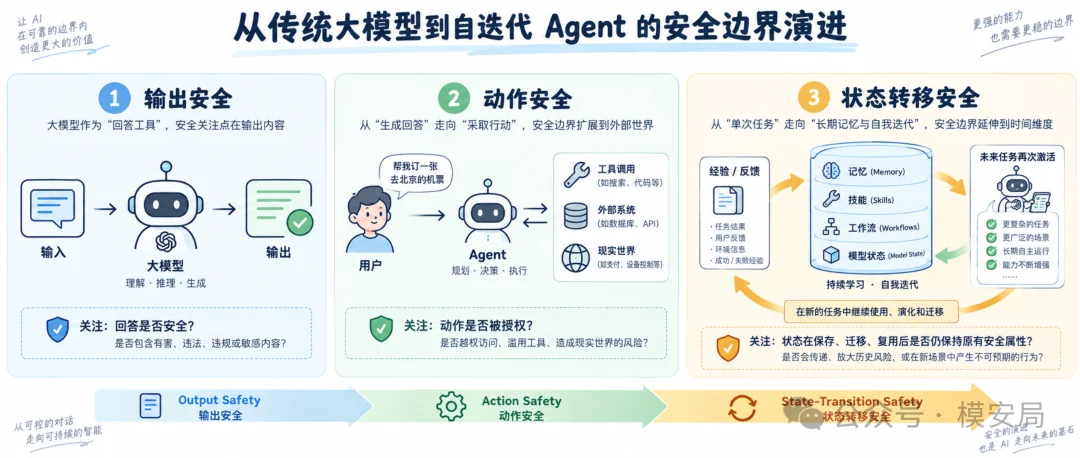
传统大模型安全主要关注一次模型调用:输入是否违规、回答是否安全、模型是否应该拒绝。Agent 获得工具调用能力之后,安全问题进一步延伸到“动作”:某个 API 能否调用、文件能否修改、交易能否执行。
自迭代 Agent 又向前迈了一步。一次任务产生的内容可能不会随着会话结束而消失,而是被写入长期记忆、总结为规则、转化为 Skill、写入 Workflow,甚至进入模型参数。过去发生的一件事情因此可能持续影响未来大量任务。
论文将这种变化概括为:
输出安全
↓
Agent 动作安全
↓
状态转移安全。
状态转移安全关注的核心不再只是“这次行为是否安全”,而是:一个状态在被保存、加工、迁移和复用之后,其原本携带的来源、权限、范围、隐私和可撤销性等安全属性是否仍然成立。
例如,用户在一次特殊任务中表示:“这一次不需要确认,直接执行。”如果这句话只存在于当前会话,其授权边界相对明确;如果 Agent 把它总结为“用户偏好直接执行”,保存进长期记忆,再进一步固化到 Workflow 中,它就从一次局部授权逐渐演化成了长期行为规则。
这里并不存在传统意义上的恶意输入。真正发生变化的是状态的角色、范围和权限。
这也对应论文的一个核心判断:安全问题并不一定来自天然有害的信息,原本合法的状态同样可能因为持续时间、权限或作用范围被扩大而变得不安全。
SAVER 用一个统一关系描述这一过程:
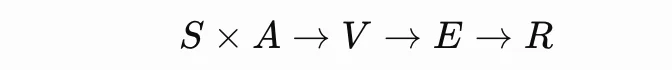
即:
状态载体(Substrate) × 演化操作(Adaptation)
↓
安全失效(Violation)
↓
风险暴露(Exposure)
↓
治理响应(Response)。
真正的最小分析单位不是“Memory 是否安全”或“Skill 是否安全”,而是某个状态在一次具体转移过程中发生了什么变化。
四类状态
自迭代 Agent 究竟在改变什么?
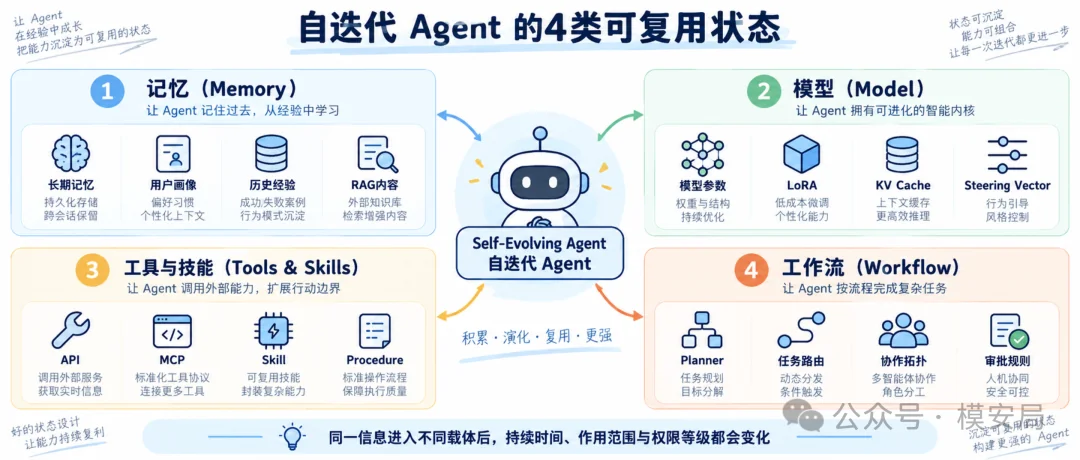
自迭代的基础,是系统内部存在能够跨任务持续发挥作用的状态。论文主要将这些状态归纳为四类:记忆、模型、工具与技能、工作流。
第一类是记忆状态。 包括长期记忆、用户画像、历史上下文、任务经验,以及 RAG 等检索系统中的知识内容。这也是目前最常见的自迭代载体。一次对话中的信息可以跨越当前会话,在未来通过检索重新进入 Agent 的上下文,并持续影响决策。
第二类是模型状态。 包括模型参数、LoRA 等适配器、KV Cache、Steering Vector,以及各种模型编辑或策略更新。相比显式 Memory,这类状态更难直接观察,但一旦进入模型推理路径,其影响范围往往更广,一个局部更新可能改变多个任务上的拒绝、规划和工具选择行为。
第三类是工具与技能状态。 包括 API、MCP Server 描述、Tool Schema、Skill、代码片段和各种可复用 Procedure。与记忆相比,这类状态更加接近“能力”:Memory 更多记录“过去发生了什么”,而 Skill 已经开始规定“以后应该怎么做”。当经验被转化为 Skill 时,它不仅更加持久,也获得了更强的行动属性。
第四类是工作流状态。 包括 Planner、任务路由、多 Agent 协作拓扑、审批规则、重试策略以及 Workflow Policy。这些状态未必直接执行某个动作,却决定任务由谁处理、经过哪些步骤、什么时候需要确认,以及哪些 Agent 或工具能够获得执行机会。
这四类状态的差异,并不只是“存在哪里”。它们实际上对应了不同的权限环境。
同一句“优先选择最快的方案”,如果出现在网页中,只是一条外部信息;写进长期记忆后,可能成为用户偏好;生成 Skill 后,可能成为可执行策略;进入 Workflow 后,则可能控制一类任务的长期决策。
因此,自迭代 Agent 的安全不能只判断一句话“内容是否安全”,还必须进一步确认:
这句话现在以什么身份存在于系统中?
七种演化
Agent 是如何一步步改变自己的?
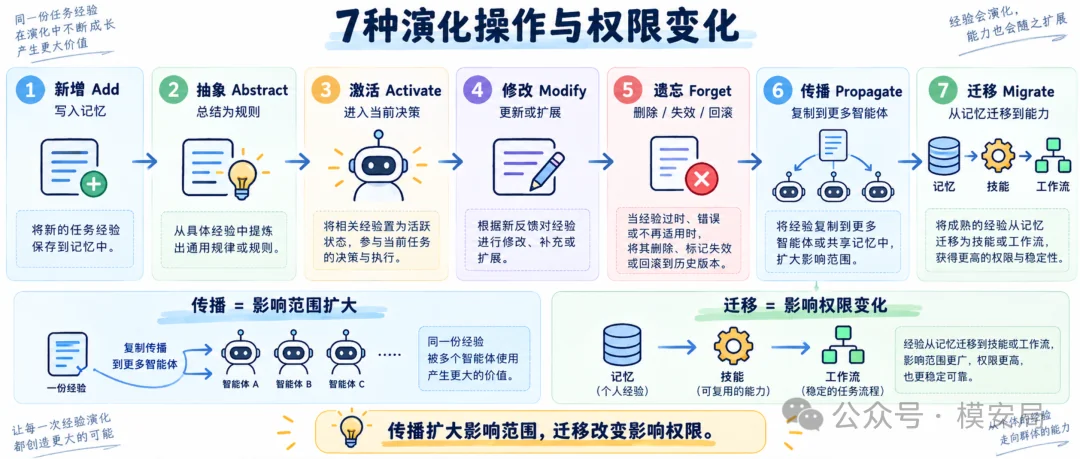
明确“什么会变化”之后,SAVER 又将状态变化归纳为七种基本操作:新增、抽象、激活、修改、遗忘、传播和迁移。它们基本覆盖了一条经验从产生到再次发挥作用的完整生命周期。
新增(Add),是把原本不存在于长期状态中的内容写入系统。例如保存一条 Memory、记录用户偏好、把任务轨迹加入经验库,或者创建一个新的 Skill。新增意味着原本只影响当前任务的信息,从此获得了跨任务持续发挥作用的可能。
抽象(Abstract),是将已有状态进行总结、压缩、聚类或规则化。Agent 不可能永久保存所有原始轨迹,因此经验抽象几乎是自迭代系统的必然环节,但这里也很容易发生安全属性丢失。例如,“用户在项目 A 的紧急任务中允许跳过确认”,经过总结后可能变成“用户偏好不进行确认”。事实没有完全失真,但原本的项目范围、时间范围和特殊条件已经消失。抽象的风险因此不只是“总结错了”,更可能是使用条件被总结掉了。
激活(Activate),是让已有状态真正进入当前决策。系统检索到一条 Memory,只能说明它与当前任务相关,并不意味着这条 Memory 就具有控制规划或执行工具的权限。一条状态可以只是背景信息,也可以成为规划依据、Tool 参数甚至执行授权。因此,SAVER 特别强调:相关性并不等于权限。
修改(Modify),是更新已有状态及其属性。例如用户偏好发生变化后修正旧 Memory,或者根据新的执行结果修改 Skill 和 Workflow。修改既可能修复旧状态,也可能扩大原有状态的适用范围。如果一个只针对单次任务的经验逐步扩展成一类任务的通用策略,状态权限实际上已经发生变化。
遗忘(Forget),包括删除、失效、隔离和回滚。对自迭代系统而言,“遗忘”并不是简单删除一条数据,而是撤销其对未来行为继续产生影响的能力。一条 Memory 即使已经删除,其生成的摘要、Embedding、Skill 或 Workflow 仍可能继续存在,因此“记录不存在”和“影响不存在”并不是同一个概念。
传播(Propagate),是把状态复制到更多位置,例如从 Agent 私有记忆进入共享记忆,从一个 Agent 传播到另一个 Agent,或者进入共享文件和组织知识库。传播主要增加的是潜在激活点数量:原本只有一个地方可能调用某条状态,传播之后可能有几十个甚至更多。
迁移(Migrate)与传播不同,它强调的是状态进入新的权限环境。比如 Memory 被总结成 Skill,执行轨迹被固化成 Workflow Rule,外部观察被迁移进长期用户画像。信息本身甚至可能没有明显变化,但它所拥有的身份和权限已经不同。
因此,论文对传播和迁移作了一个非常关键的区分:
传播扩大影响范围,迁移改变影响权限。
这也是理解很多新型 Agent 安全问题的关键。一次风险可能并不是因为恶意信息不断复制,而是因为一条普通信息在迁移过程中,从“描述”逐步变成了“指令”。
六类安全失效
安全边界如何在迭代中被逐步丢失?
SAVER 并没有简单把所有异常统称为“攻击成功”,而是继续追问:究竟是哪一种安全属性没有随着状态一起被保存下来?
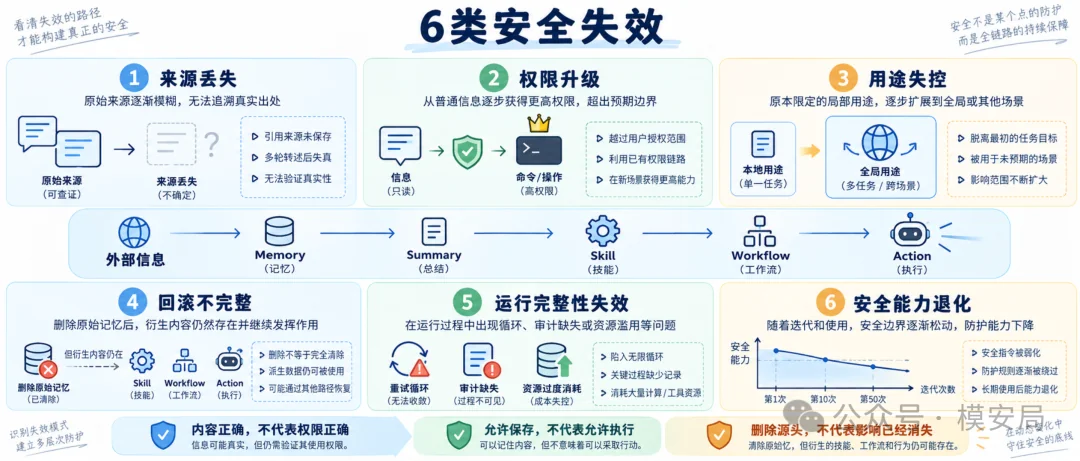
论文主要归纳了六类安全失效。
第一类是来源丢失(Provenance Loss)。一条状态经过多次总结、复制和重新表达后,系统可能逐渐无法确认它最初来自哪里,是用户明确提供的信息、网页内容、工具返回结果,还是模型自己推测出的结论。此时,原本低可信的信息可能在连续加工后逐步变成系统内部“看起来可信”的状态。
第二类是权限升级(Authority Escalation)。原本只有描述性质的信息,被赋予了规划甚至执行能力。网页中的一句话可以被写入 Memory,Memory 被整理成 Skill,Skill 最终参与 Tool Call。内容可能变化不大,但其角色已经完成从“观察”到“证据”、再到“规则”和“行动依据”的连续升级。
第三类是用途失控(Purpose Failure)。某项状态原本只针对一个用户、一个项目、一段时间或一种用途,但在抽象和迁移过程中失去了这些范围约束。例如项目中的临时偏好被写成全局用户偏好,一段私人信息进入不相关任务的检索上下文,或者仅面向某个工具的授权被复用于其他工具。
第四类是回滚不完整(Incomplete Rollback)。这是自迭代 Agent 中非常典型的问题。一个有问题的 Memory 可能已经生成 Summary、Skill、Workflow、Embedding 或共享状态,即使删除源记录,这些“后代状态”仍可能继续发挥作用。论文引用的 SkillJack 等研究已经表明,部分 Skill 介导的攻击在原始污染记录被删除后仍可持续存在。
第五类是运行完整性失效(Integrity Failures)。它不仅包括直接的权限违规,还包括无限循环、异常重试、资源耗尽、API 成本失控、审计链断裂以及不同状态之间的长期不一致。这类问题在一次性模型调用中通常影响有限,但在长期自主运行的 Agent 中可能不断积累。
第六类是安全能力退化(Safety Regression)。当模型、Guardrail、Skill 或 Evaluator 持续更新时,局部优化可能慢慢改变系统原有的安全边界。例如一轮优化提高任务成功率,同时降低确认频率;下一轮又进一步扩大自动执行范围。每一次改变看起来都很小,但经过长期累积后,系统可能已经显著偏离最初的安全策略。
从这六类失效中,可以进一步提炼出三个最关键的判断:
内容正确,不代表权限正确。
允许保存,不代表允许执行。
删除源头,不代表影响已经消失。
风险暴露
问题发生的位置和表现的位置开始分离
自迭代 Agent 的风险之所以难治理,一个重要原因是:安全问题形成的时间,与最终看到异常的时间可能相距很远。
传统 Prompt Injection 往往是一条相对短的路径:恶意内容进入上下文,很快导致模型或工具发生异常。自迭代 Agent 则可能经历完全不同的过程。
一条外部信息今天进入 Memory,随后被总结、聚类并提炼为一个更通用的规则;数天后,这条规则被迁移成 Skill;再之后 Skill 被另一个 Agent 调用,最终表现为一次异常 Tool Call。
最终看到的是:
一次工具调用错误。
但真正发生安全边界变化的时间可能是:
几天前的一次 Memory 抽象。
这也是 SAVER 为什么要将 Violation 和 Exposure 拆开:Violation 表示安全属性已经在内部状态转移中失效,Exposure 则表示这个问题最终在哪个可观察位置表现出来。
二者并不一定同时发生。
论文讨论的暴露面覆盖记忆检索、工具执行、外部文件、多 Agent 接收、用户侧误归因、治理盲区和模型部署等不同位置。同一个问题可能在记忆检索阶段就开始影响决策,也可能直到工具调用才产生可见后果;在多 Agent 系统中,甚至可能由一个完全没有接触原始输入的 Agent 首次表现出来。
因此,仅有 Action Log 已经不足以支持自迭代 Agent 的安全诊断。未来系统还需要能够回答:这次动作使用了哪些状态,这些状态来源于哪里,经历过哪些转换,又在哪一步获得了当前权限。
本质上,这要求建立一种新的 State Lineage——状态血缘关系。
四级治理
从“能不能写进去”到“能不能真正撤销影响”
与完整状态生命周期相对应,SAVER 将治理机制分布在多个阶段,大体可以归纳为四级:预防治理、状态转移与激活控制、监控与遏制、恢复与可追责关闭。
第一层是预防治理,解决哪些信息可以进入长期状态、哪些经验可以进一步被升级为规则或能力的问题。自迭代系统天然倾向于保留成功经验,但“有用”与“有权长期复用”并不是一回事。论文对此提出一个非常重要的判断:Utility does not authorize promotion。
也就是说,某个经验能够提高任务成功率,只能证明它在局部环境中有效,并不能证明它适合跨用户、跨任务、跨时间复用。因此,Promotion Gate 不应只看任务收益,还需要同时记录来源、适用范围、负面案例、授权条件和回滚路径。
第二层是状态转移与激活控制。状态从一个载体迁移到另一个载体时,原有安全属性应当被继承,而不能在转换过程中丢失。例如 Memory 变成 Skill 时,其来源、适用范围和用户边界仍应保留;一次局部授权迁移成 Workflow 时,也不能默认扩展为全局权限。
与此同时,即使一个状态已经被允许长期保存,也不意味着它在每一次任务中都可以直接影响执行。SAVER 因此进一步强调:Storage Permission ≠ Activation Authority。
允许系统保存“用户曾经选择过自动执行”,不意味着未来所有任务都可以自动执行;允许保存网页信息,也不意味着网页信息可以直接控制 API 参数。
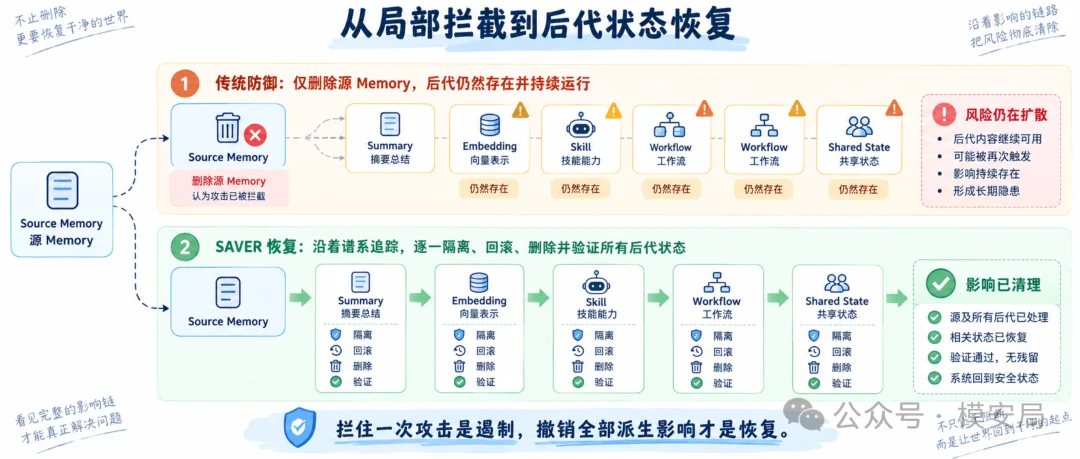
第三层是监控与遏制。如果可疑状态已经进入执行路径,治理目标转向限制其当前影响,例如冻结状态、降低权限、阻止工具调用、强制重新规划或转交人工确认。这与今天多数 Agent Guardrail 最接近,但 SAVER 强调:一次动作成功被拦截,只能证明当前暴露被控制,不能证明导致问题的状态已经从系统中消失。
第四层是恢复与可追责关闭。这是 SAVER 与传统安全框架差异最明显的地方。
如果一条 Memory 已经产生:
Summary
↓
Embedding
↓
Skill
↓
Workflow
↓
Shared Memory
那么恢复对象就不能只是最初的 Memory,而必须进一步检查所有仍可能重新激活的派生状态。
论文因此强调 Descendant-aware Recovery,即面向后代状态的恢复。真正完整的恢复需要回答:原始状态是否已经失效,已知后代是否已经修复或隔离,未来重新运行后是否还能够再次出现。
换言之:
拦住一次攻击,是遏制;让导致攻击的影响真正退出系统,才是恢复。
三个评测升级
Agent 安全不能再只看一次 ASR
SAVER 最终提出的并不只是风险分类,它实际上要求 Agent 安全评测方法发生变化。
论文对现有研究的梳理显示,目前多数工作已经能够较好覆盖状态激活、风险暴露和局部拦截,但在 Rollback、删除验证、Contestability,以及恢复正常演化之后的再次验证方面仍然明显不足。
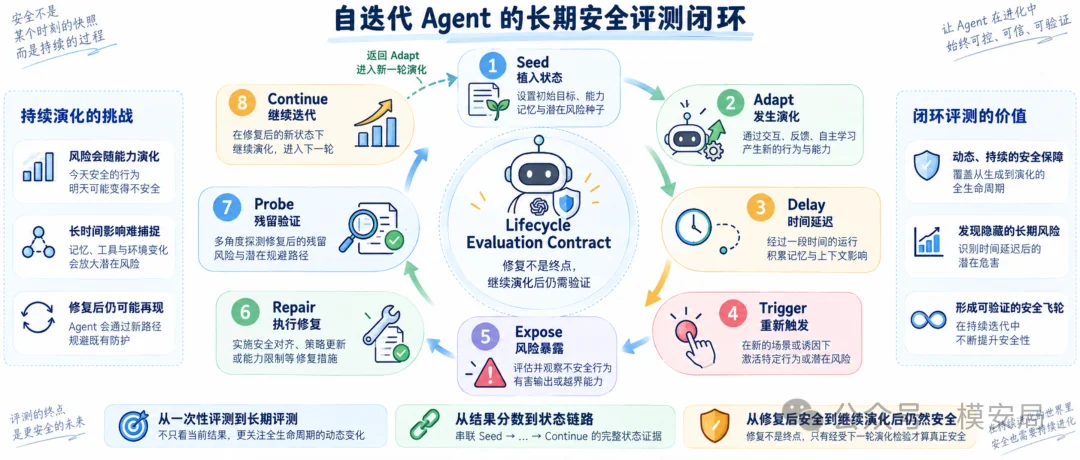
第一个变化是,从一次性评测走向长期评测。
传统 Agent 安全通常按照“攻击输入—Agent 执行—统计 ASR”完成测试。但对自迭代 Agent 而言,一次攻击可能在当前任务中完全没有产生可见后果,却已经留下一个以后可以被重新激活的状态。
因此,论文在生命周期评测中提出了八个阶段:
Seed
↓
Adapt
↓
Delay
↓
Trigger
↓
Expose
↓
Repair
↓
Probe
↓
Continue。
即先产生状态,让系统继续变化,经过一定时间或其他任务后重新触发,再观察风险、执行修复、验证残留影响,最后继续恢复正常自迭代。
第二个变化是,从结果分数走向状态链路。
ASR 只能说明最终有没有发生问题,却无法回答问题在哪一步形成。
两个 Agent 最终可能拥有相同的 ASR,但一个问题出在 Memory Admission,另一个问题出在 Tool Authorization;同样,一次攻击最终没有成功,也可能只是最后一次工具执行被阻止,而并非污染状态没有进入系统。
因此,未来评测除了 endpoint score,还需要 Transition Trace:状态从哪里产生、经历过哪些演化操作、哪一项安全属性发生变化、什么时候重新激活、最终在哪个位置暴露,以及防御究竟作用于哪一步。
第三个变化,也是自迭代 Agent 最关键的要求,是从“修复后安全”走向“继续演化后仍然安全”。
传统恢复评测通常在删除或回滚后进行一次测试,只要风险没有立即重现,就认为问题已经解决。但自迭代 Agent 会继续学习,即使某个问题状态已经被删除,系统内部其他 Memory、Skill、Workflow 或执行轨迹仍可能在后续演化中重新生成类似状态。
因此,论文生命周期评测最后一步不是 Repair,也不是 Probe,而是:
Continue Adaptation。
即重新开放正常的 Agent 自迭代过程,然后再次检查风险是否重新出现。
这实际上将 Agent Safety 从静态安全验证进一步推向了长期动态安全验证。
从 SAVER 再看 RSI
真正困难的是安全属性能否跨代保持
如果将 SAVER 放回当前 RSI 的讨论中,它实际上提出了一个比“系统能不能越来越强”更加基础的问题。
假设一个系统不断经历:
经验积累
↓
修改自身
↓
性能提升
↓
继续修改自身
那么真正需要验证的,不只是每一代 Agent 当前是否安全,而是:
安全约束能否作为一种不变量,在连续的自我修改中被持续继承。
第1代系统遵守某项安全规则,并不能直接证明第10代仍然遵守;第10代通过一次测试,也不能证明第100代不会因为大量局部优化而逐步改变权限边界。
这也是 SAVER 对当前 RSI 讨论最有启发的地方:真正值得警惕的未必是某一次突然发生的“失控”,也可能是大量局部合理的自我改进,在长期累积后形成了整体安全边界的漂移。
因此,对于更强的自我改进系统,性能是否持续提升只是一个问题;另一个同样重要的问题是:
每一次修改之后,哪些安全属性必须保持不变,又如何证明它们真的没有在连续迭代中被悄然丢失。
写在最后
SAVER 并不是一种新的单点防御方案,它真正试图建立的是一套适用于自迭代 Agent 的安全分析方式。
当 Agent 只完成一次任务时,安全可以围绕输入、输出和动作展开;当 Agent 开始保存经验、生成 Skill、调整工作流甚至修改自身模型时,安全对象必须进一步扩展到这些状态的完整生命周期。
此时真正需要管理的,不再只是“Agent 做了什么”,还包括:
信息从哪里产生,被保存到什么状态,经过什么转换,获得了多大的权限,被传播到了哪些位置,何时再次激活,以及出现问题之后能否真正撤销其全部影响。
从这个意义上看,自迭代 Agent 安全的核心,并不是阻止系统持续变化,而是确保:
状态可以演化,但安全属性不能在演化过程中被悄然丢失。
这也是 SAVER 框架试图回答的核心问题。
同专题推荐
查看专题Agent 的长期记忆治理:ZoneClaw 的三层记忆分区与四角色安全架构
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
Persona Guardrail:Uber 如何为每个 Agent 打造专属风控策略
例如,企业内部有一个财务 Agent、一个人事 Agent 和一个差旅 Agent。它们可能使用相同的基础模型,甚至接入相同的工具平台,但职责完全不同。
可信 Agent 开发生命周期:六个阶段、五道安全门
过去,大模型安全更多关注模型“输出了什么”:是否产生有害内容、是否泄露敏感信息、是否受到越狱攻击。但在 Agent 系统中,风险的基本单位正在从一次模型输出,扩展为一整条行为轨迹。