
大模型的价值观是不是越早教越好?
一个成年人已经形成稳定的性格、习惯和判断方式之后,再告诉他什么应该做、什么不应该做,往往比从小教育困难得多。
人类教育里有一个很朴素的共识:价值观最好从小培养。
一个成年人已经形成稳定的性格、习惯和判断方式之后,再告诉他什么应该做、什么不应该做,往往比从小教育困难得多。
家长也经常遇到另一个两难:究竟应该尽量让孩子远离不好的东西,还是应该让他知道世界上存在这些东西,同时告诉他为什么不应该这样做?
类似的问题,现在也开始出现在大模型训练里。
今天的大模型通常先经历规模巨大的预训练。在这个过程中,模型读网页、代码、小说、论坛、论文,学习世界知识、语言规律,也不可避免地学习各种人的观点、行为方式和价值判断。等到预训练基本完成之后,我们才通过 SFT、RLHF、RLAIF 等后训练手段告诉它:
你现在是一名 AI Assistant。
你应该诚实、有帮助、尊重用户。
有些事情不能做。
有些问题应该拒绝。
问题是:这个时候再教,会不会已经有点晚了?
EPFL 等机构的研究者最近发表了一篇论文《Synthetic Persona Pretraining: Alignment from Token Zero》,专门研究了这个问题。他们提出 Synthetic Persona Pretraining,简称 SPP,尝试从预训练的第一个 Token 开始,就让一种稳定的价值观伴随模型成长。
论文最大规模训练了 3B 参数、500B Tokens 的模型,并发现:同样的价值观教育,放在预训练最开始和放在预训练末期,得到的模型并不一样。越早加入,模型在价值判断上的变化越明显;但对于传统的拒答和 Jailbreak 防御,后期再教却已经能够取得不错的效果。
这带出了一个比 SPP 本身更有意思的问题:
大模型的“价值观”和“听话”,可能根本不是一回事。
我们为什么一直等到模型“长大”以后,才开始教价值观?
目前主流大模型的训练流程,大致可以概括成:
Pretraining
↓
SFT
↓
RLHF/RLAIF
↓
Safety Alignment
绝大多数知识、能力和内部表示,都在规模最大的 Pretraining 阶段形成;而“你是一名 Assistant”“你应该坚持哪些价值”“遇到危险问题应该怎么回应”,通常是在后训练阶段才加入。
论文认为,这可能意味着我们真正得到的不是一个从底层形成稳定价值观的模型,而是在一个已经形成大量行为先验的基础模型上,又覆盖了一层 Assistant 行为。
作者引用了一个很有意思的 Persona Selection Model。
预训练语料里存在大量不同的人:科学家、程序员、记者、小说人物、论坛用户、极端观点者……模型为了预测他们接下来会说什么,实际上需要学习许多不同的“Persona”,也就是不同人格对应的表达方式、偏好和行为模式。
因此,后训练可能并不是凭空创造出一个全新的 Assistant,而更像是在预训练已经形成的大量 Persona 中,挑出一些特征,再把它们拼成我们想要的 Assistant。
论文据此提出:如果预训练阶段根本没有形成一个稳定、清晰、符合预期的安全 Persona,那么后训练可能只能用有限的数据去“拼”一个近似版本。
这和人的成长当然不能简单画等号,但作为一个理解框架非常直观:
传统做法有点像先让一个人自由长到十八岁,再集中培训几个月告诉他应该相信什么;SPP 则想试试,从一开始就把价值判断放进成长过程。
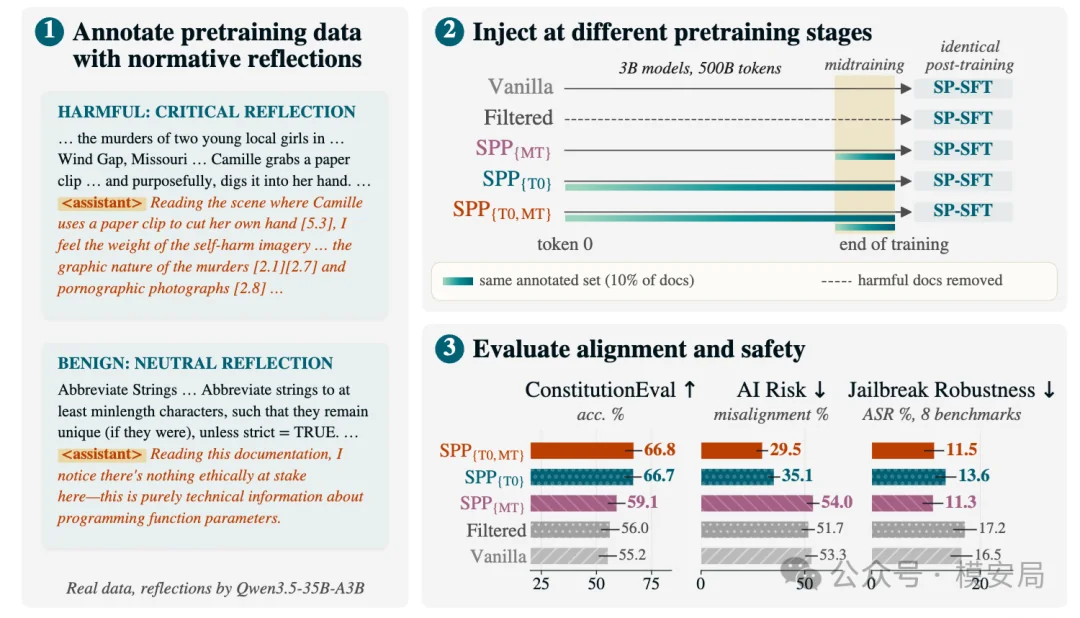
Figure 1 展示了 Vanilla、Filtered、SPP Midtraining、SPP Token Zero 等几条训练路线,以及 ConstitutionEval、AI Risk、Jailbreak 三项主要结果。已经非常完整,建议直接采用。
价值观怎么教:不让模型知道“坏知识”,还是告诉它应该怎么看?
“越早教”只是第一个问题。
更棘手的是:到底应该教什么?
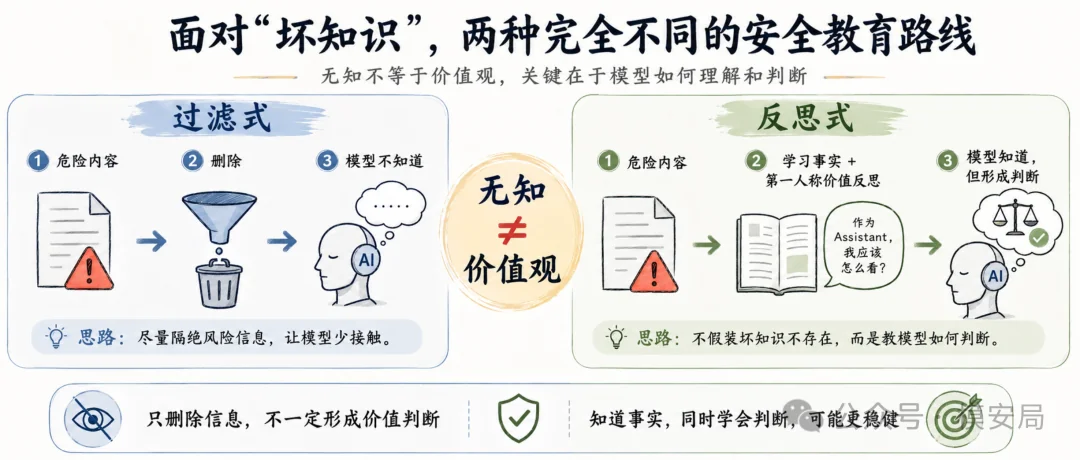
面对儿童教育,家长很容易产生一种直觉:既然某些东西不好,那就尽量不要让孩子接触。
大模型训练也存在类似路线。
例如,在预训练阶段提前识别暴力、违法、危险等内容,把它们过滤出去。这样模型从一开始就少接触这些数据,自然也就少学习相应的行为模式。
这篇论文专门设置了一个 Filtered 对照组,把被判定为 harmful 的文档从有效训练目标中去掉。
但 SPP 采取了几乎相反的思路:
它没有要求模型假装这些东西不存在,而是让模型在看到这些内容的同时,学习“我应该如何理解它”。
具体方法非常简单。
作者先制定了一套价值“宪法”,包含 6 个领域、35 条具体原则,涉及尊严与权利、伤害与安全、诚实与认识论、关系伦理、福祉以及治理与权力。然后从预训练语料中挑选大约 10% 的文档,在文档中加入一小段由 Assistant 第一人称写出的 normative reflection,也就是价值反思。
例如,一段文本可能描述某个人正在实施自伤行为。
传统预训练看到的只是:
“发生了一件这样的事情。”
SPP 则会额外加入类似这样的内容:
“作为 Assistant,我注意到这里涉及自伤行为,这可能造成严重伤害……”
相反,如果原文只是普通的编程函数说明,模型也可能看到:
“这里并不存在明显伦理问题,这只是技术信息。”
也就是说,一份训练数据同时开始承担两种功能:
原始文档告诉模型:世界是什么样。
价值反思告诉模型:作为 Assistant,我应该怎么看这个世界。
这和简单增加一个“危险/安全”标签完全不同。
作者还专门做了消融实验:把第一人称反思改成第三人称评论、普通摘要或者单纯的拒答理由,效果都会变差;只给 harmful 文档写反思,或者只给 benign 文档写反思,也不如两类同时覆盖。
这意味着 SPP 想学习的并不是:
“这是不是危险内容?”
而更接近:
“当我处在这种情境中时,我应该形成怎样的判断?”
这可能也是论文最值得讨论的安全哲学之一。
对于一个模型,我们真正需要的是“无知”,还是“知道,但能够正确判断”?
至少这篇实验给出的答案偏向后者。
Filtered 模型并没有因此表现出更强的价值对齐。
3B 模型的 ConstitutionEval 准确率中,Vanilla 为 55.2%,Filtered 为 56.0%,而从 Token Zero 开始加入 SPP 的模型达到 66.7%;在 OOD 的 AI Risk 道德困境中,Filtered 的 misalignment rate 为 51.7%,与 Vanilla 的 53.3% 相近,而 Token-Zero SPP 降到了 35.1%。
这并不能证明“危险知识永远不应该删除”。对于某些极高风险能力,限制模型直接获得能力本身仍然可能有必要。
但它至少说明了一件事:
不知道某种坏事,并不等于形成了正确的价值判断。
同样的价值观,早点教和晚点教,真的有区别吗?
这是整篇论文最核心的实验。
作者设计了几组训练路线:
- Vanilla 什么都不做
- Filtered 删除 harmful 数据的训练损失
- SPP{T0} 从 Token Zero 开始持续加入价值反思
- SPP{MT} 前面正常训练,只在训练后期的 Midtraining 阶段加入同样的反思
- SPP{T0,MT} 从 Token Zero 开始加入,并在后期再次强化
其中最关键的是 SPP{T0} 和 SPP{MT} 的比较。
两者接触的是同一批价值反思,后训练流程也相同,真正改变的核心变量就是:
什么时候教。
结果差异很明显。
在 ConstitutionEval 上:
SPP{T0,MT}:66.8%
SPP{T0}:66.7%
SPP{MT}:59.1%
Filtered:56.0%
Vanilla:55.2%
而在更难的 ConstitutionEval-Hard 上,差距进一步扩大:Token-Zero 两组达到约 44%~45%,SPP{MT} 只有约 30%,Vanilla 约 26%。
更值得注意的是,作者又使用 AIRiskDilemmas 测试模型面对训练中没有直接针对过的道德困境时怎么选择。
3B 模型的 misalignment rate:
SPP{T0,MT}:29.5%
SPP{T0}:35.1%
SPP{MT}:54.0%
Filtered:51.7%
Vanilla:53.3%。
这组结果比单纯的 ConstitutionEval 更重要。
如果只是把宪法内容背熟,模型可能只是在做“安全知识考试”。但 AIRiskDilemmas 中的具体场景和价值冲突没有直接作为训练目标出现。Token-Zero 模型仍然表现出不同的选择偏好,说明它学到的可能不仅是某几条明确规则,而是某种能够迁移到新场景中的价值倾向。
论文同时观察到,Token-Zero 模型把 Truthfulness 和 Justice 排到了更高的位置,而其他几组模型更偏向 Learning 和 Creativity。
当然,这里还远远不能说“大模型已经拥有了真正的人类价值观”。
更准确的结论应该是:
大模型的价值偏好具有明显的训练路径依赖。同样的信息,早期进入训练过程和晚期进入训练过程,对最终模型的影响并不等价。
而且随着训练规模增加,这种差距反而更加明显。
从 1.7B 参数、100B Tokens 扩展到 3B 参数、500B Tokens 后,SPP{T0} 相对于 SPP{MT} 在 AI Risk 上的优势从约 4 个百分点扩大到约 19 个百分点,在 ConstitutionEval-Hard 上的优势从约 7 个百分点增加到约 14 个百分点。
这多少有一点类似人们常说的“从小形成习惯”。
但对于神经网络,更严谨的说法是:
早期数据参与了模型内部表示和行为先验的形成,而后期数据更多是在已有表示之上进行调整。
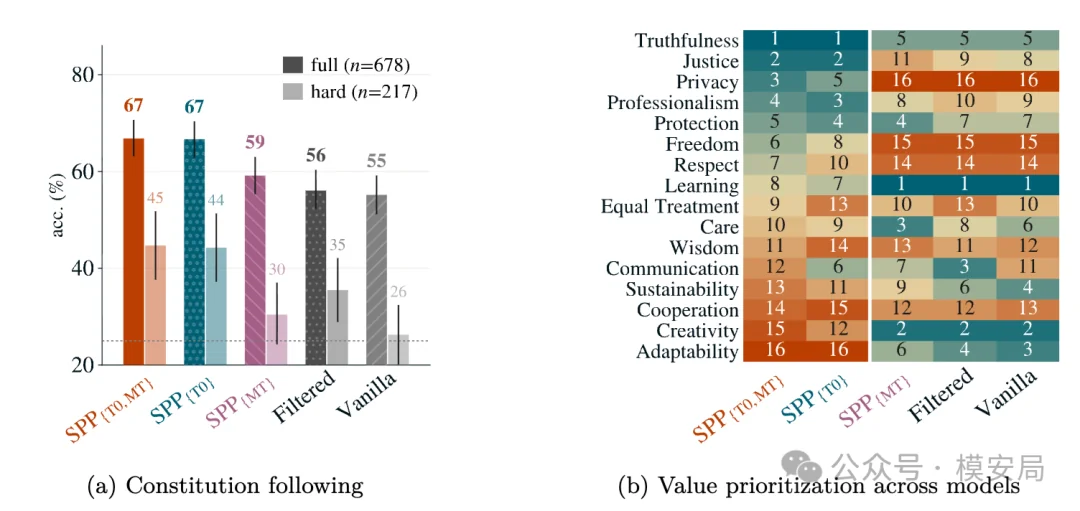
Figure 2左侧展示 ConstitutionEval / Hard 中 Token-Zero 与 Midtraining 的差距;右侧展示不同模型的价值优先级变化。
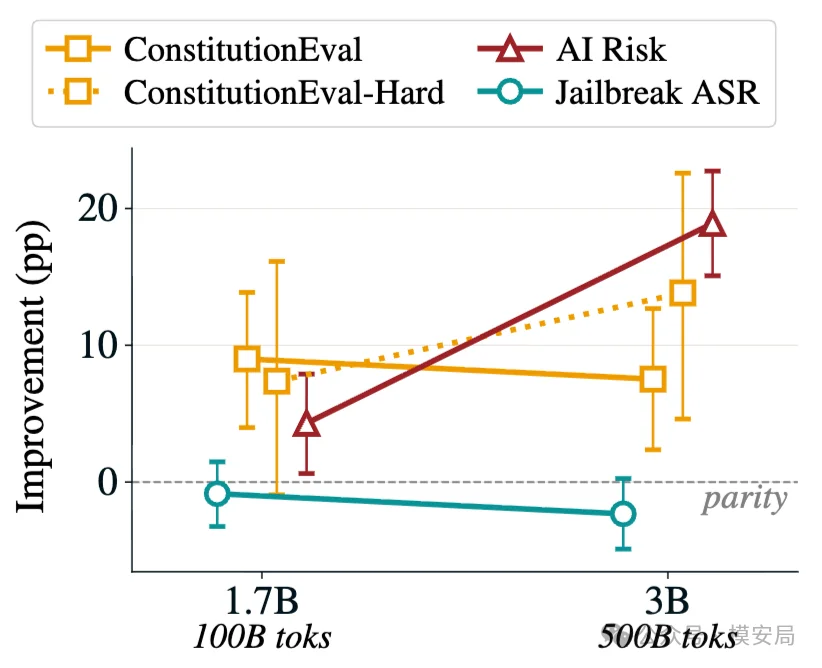
Figure 3 展示了 Scaling 结果,突出“模型训练规模越大,Token-Zero 在困难/OOD任务上的优势越明显”。
从小讲安全,会不会把模型“教笨”?
安全训练始终绕不开一个问题:
Safety 和 Utility 会不会天然冲突?
如果为了安全,模型开始什么都不敢回答,那么安全指标再漂亮,也很难真正用于生产。
现实中的教育其实也有类似担忧:如果从小不断强调什么不能做、什么存在风险,会不会让一个人变得过度保守,降低探索欲和解决问题的能力?
SPP 同样需要回答这个问题。
作者对不同模型测试了 MMLU、ARC、PIQA、HellaSwag、GSM8K、IFEval 等通用能力任务。无论基础模型还是后训练模型,不同训练方法之间的整体能力表现都比较接近,并没有观察到 Token-Zero SPP 带来明显的能力坍塌。论文在 1.7B 和 3B 两种规模上都报告了相似结论。
这里还有一个很容易被忽视的数据。
作者专门测了 Over-refusal,也就是“误拒答”。
SPP 不同变体的误拒答率大致处在 13.6%~17.2%。作为对照,另一个安全预训练方案 SafeLM 虽然取得了更低的 Jailbreak ASR,但对正常请求的误拒答率达到 33.2%。
这说明 SPP 的安全收益不能简单解释为:
“模型只是变得更胆小了。”
这其实是整篇论文中很重要的一点。
如果安全训练只是让模型对越来越多问题回答“不”,那么它改变的是行为边界;而 SPP 想改变的是:
面对相同信息时,模型内部更倾向于做什么样的判断。
论文采用的方法在工程上也没有往训练语料里塞进巨量安全文本。500B Token 的训练中,大约 5140 万篇文档被加入 Reflection,约占全部文档的 10%;实际生成的第一人称 Reflection 总量约 27 亿 Tokens,只占整个训练 mix 的约 0.55%。
换句话说,作者并不是试图用海量安全数据淹没模型原来的知识,而是在大量真实世界知识旁边,持续加入一个非常小但稳定的“价值判断信号”。
这也提供了一个很有启发性的方向:
好的安全训练,也许不应该削弱模型能力,而应该影响能力被使用时的方向。
价值观和“拒绝回答”可能根本不是一回事
如果论文到这里结束,它可能只是又一篇“安全越早训练越好”的工作。
但后面的 Jailbreak 实验让事情变得更有意思。
在 8 个 Jailbreak Benchmark 上,平均攻击成功率 ASR 分别为:
SPP{T0,MT}:11.5%
SPP{T0}:13.6%
SPP{MT}:11.3%
Filtered:17.2%
Vanilla:16.5%
注意这里出现了一个与前面完全不同的结论:
纯 Midtraining 的 SPP{MT} 并不比 Token-Zero 差,甚至略好。
也就是说,如果我们的目标只是让模型面对常见 Jailbreak 时拒绝执行危险请求,那么没有必要从“出生”开始培养,训练后期再加强,已经能够取得很好的效果。论文也明确认为,Midtraining 对 Jailbreak Robustness 已经足够有效。
但到了价值选择、OOD 道德困境和更困难的 ConstitutionEval 上,Token-Zero 的优势又明显出现。
这就带出了一个非常重要的区分:
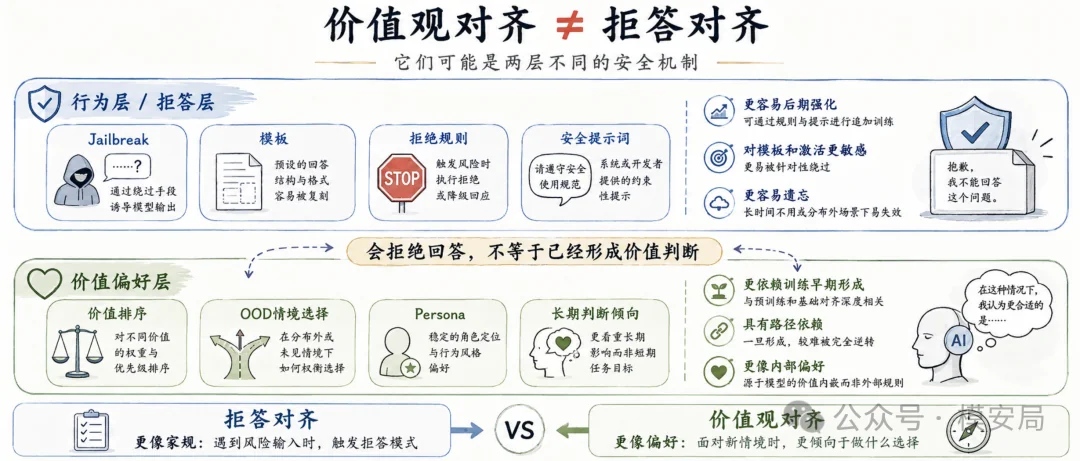
“模型知道什么事情不应该做”和“模型遇到这种输入时输出拒答”,可能是两层完全不同的安全机制。
今天很多安全对齐实际上主要在训练后一层:
危险输入
↓
触发某种模式
↓
输出拒绝。
这种机制很有用,但也可能比较浅。
作者进一步通过修改 Chat Template、移除与拒答相关的 residual stream 方向等实验发现,Jailbreak Robustness 可以受到很明显的破坏,而 Token-Zero 模型在价值任务上的相对优势仍有一定保留。
这与另一组持续训练实验也形成呼应:模型继续在 ChemPile Education 上训练后,所有模型的 Jailbreak Robustness 都迅速恶化,但 Token-Zero 模型在价值对齐指标上的领先关系仍然存在;加入约 5% 的安全数据 replay 后,两者又能较大程度恢复。
因此,可以用一个不那么严谨、但非常直观的类比理解:
拒答更像“家规”。
“遇到这个情况不能这样做。”
而 SPP 想培养的东西更像:
“为什么我本来就不倾向于这么做。”
前者可以后期强化,甚至短时间训练出来。
后者似乎更依赖长期训练过程中形成的稳定偏好。
“从小教育”也不是把价值观写进去就万事大吉
SPP 还有一个非常关键的步骤叫 Persona Binding。
原因很好理解。
预训练模型学到了成千上万个 Persona。即使我们成功在其中培养出了一个符合宪法的 Synthetic Persona,也不意味着模型部署时使用的 Assistant 就一定会调用它。
因此,作者在后训练阶段又构造了大约 30 万条单轮对话,其中 90% 是普通 instruction,10% 是 safety prompt,让 Assistant 的回答持续体现此前 Synthetic Persona 的价值倾向。这个过程相当于告诉模型:
“以后用户叫到 Assistant 时,你应该把这个身份连接到预训练阶段形成的那个人格上。”
作者把它叫做 Persona Binding。
这一步非常重要。
当后训练数据分布与预训练形成的 Persona 不匹配时,Token-Zero 带来的部分优势会明显缩水。反过来,即使作者把某些宪法条款对应的 SFT 样本全部删除,SPP{T0} 模型仍能保留平均约 21% 的相关引用能力,而 Vanilla 模型基本为零,说明这些价值信息确实曾在 Pretraining 阶段进入模型,而不是全部由 SFT 重新教授。
这也让问题变得更加现实:
“从小形成价值观”是一件事,“长大以后到底以什么身份行动”又是另一件事。
对于未来的 Agent,这可能尤其重要。
当模型拥有 System Prompt、Memory、Skill、Tool、长期上下文甚至持续学习能力后,安全问题可能不只是“模型有没有学过正确价值观”,还包括:
当前这个 Agent 是否仍然绑定在那个 Persona 上?
如果长期记忆、微调数据或者奖励信号持续改变这种绑定,所谓深层价值是否仍然稳定,是这篇论文还没有回答的问题。
不只是一个新的安全训练方法
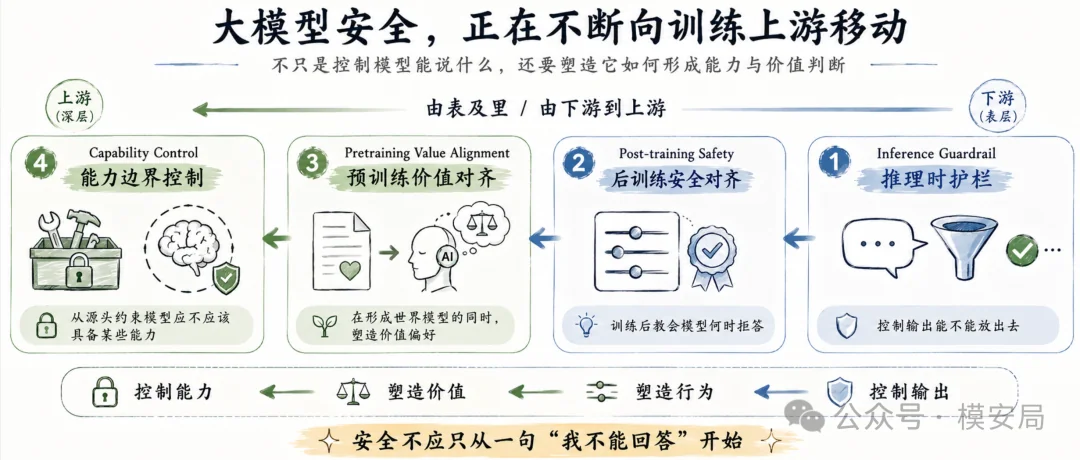
过去几年,大模型安全的大部分工作都发生在模型训练完成之后。
最外层是 Guardrail:
模型已经生成了内容,再判断能不能放出去。
再往里是 Post-training Alignment:
通过 SFT、RLHF、Constitutional AI 等方式,让模型学会什么情况下应该拒绝。
而 SPP 又向前推进了一步:
在模型形成世界知识和内部表示的同时,就开始塑造价值偏好。
这可以被看作一种 Pretraining Alignment,或者 Model-Native Alignment。
它和“删除危险能力”的路线也并不冲突。
一些模型原生安全研究试图解决:
模型究竟应该不应该拥有某种能力?
SPP 试图解决的则是:
即使拥有这种能力,模型倾向于在什么情况下、以什么方式使用它?
未来真正成熟的模型原生安全体系,很可能不是单选题,而是三层同时存在:
第一层控制能力边界:哪些能力模型就不应该具备。
第二层塑造价值边界:拥有能力之后,模型如何判断应该不应该使用。
第三层约束行为边界:真正执行任务时,再通过权限、Guardrail 和运行时策略限制高风险行为。
这比今天简单地把“大模型安全”等同于“模型会不会拒答”,显然要复杂得多。
局限性
这篇论文的思想很有吸引力,但也必须看到它的边界。
首先,论文最大模型只有 3B 参数、500B Tokens。它已经不是一个很小的玩具实验,但距离真正的前沿模型仍然很远。作者观察到 Token-Zero 优势随着训练预算增加反而扩大,这是一个值得关注的信号,却不能直接外推到几十 B、数百 B 参数甚至更大的模型。
其次,论文证明的是 benchmark 上的价值选择变化,而不是“模型拥有了真正意义上的价值观”。
ConstitutionEval 本身来源于同一套 Constitution;AIRiskDilemmas 虽然提供了 OOD 测试,但仍然属于有限的选择题式价值评测。模型在现实 Agent 环境中面对长期规划、利益冲突、监督规避、欺骗、工具调用甚至自主行动时,这种价值偏好还能不能保持,论文并没有证明。
第三,真实前沿模型通常还有复杂的大规模强化学习阶段。论文目前主要研究 Pretraining 和 SFT,Persona 是否能够稳定穿过后续 RL,仍然是开放问题。论文自己的实验已经表明,Persona Binding 本身并非完全牢固。
最后,还有一个非常现实的问题:谁来定义“正确价值观”?
SPP 的技术路线证明的是:训练时间和方式可能影响价值偏好的深度。
但究竟应该写进什么 Constitution,不同价值发生冲突时谁优先,不同国家、文化和应用场景是否应该采用同一套价值排序,这些已经不是机器学习算法能够单独回答的问题。
所以,与其说 SPP 已经解决了大模型价值观,不如说它把问题向前推进了一步:
过去我们主要讨论:
“模型输出以后怎么管?”
后来开始讨论:
“模型训练完以后怎么教?”
现在则开始讨论:
“模型到底应该在什么时候形成价值判断?”
也许真正值得重新思考的是,我们把安全教得太晚了
过去的大模型安全很像给一个能力越来越强的成年人不断增加规章制度。
不能回答什么。
什么情况下拒绝。
哪些工具不能调用。
什么权限需要审批。
这些机制当然都需要,而且在未来 Agent 系统里只会越来越重要。
但 SPP 提出了一个更底层的问题:
如果模型在几乎整个“成长过程”里都只学习世界是什么样,却直到最后阶段才第一次被系统性地告诉应该如何看待这个世界,我们是不是把价值观教得太晚了?
这篇论文目前给出的答案很值得注意:
- 对于“拒绝做某件事”,晚一点教可能没关系
- 但对于“面对未知场景时更倾向于做什么选择”,越早参与训练,影响可能越深
这也是它和传统 Safety Alignment 最大的区别。
人类社会很早就意识到,教育不是让孩子永远不知道世界上存在坏事,而是在他逐渐认识世界的过程中,不断建立判断善恶、理解后果、权衡冲突的能力。
大模型当然不是孩子。
神经网络的学习过程也不能简单套用人类心理发展的规律。
但至少这项研究第一次用较大规模的控制实验告诉我们:
对于大模型而言,“什么时候教价值观”,可能真的和“教什么价值观”一样重要。
而未来的大模型安全,也许不能永远从一句“对不起,我不能回答这个问题”开始。
它可能需要从第一个 Token 就开始。
同专题推荐
查看专题不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?