
HARD:Agent防御也能自迭代
但今天大多数 Agent 安全体系,背后的工作方式其实没有发生根本变化:出现一种新攻击,安全工程师查看日志、分析原因,然后补一条 Prompt、一个检测规则或者一层工具拦截。攻击变化一次,防御就跟着人工修一次。
过去两年,Agent 安全的研究越来越多。提示注入、Memory 投毒、Skill 投毒、恶意工具调用、越权操作……随着 Agent 能够访问浏览器、文件系统、Shell、MCP 和各种外部工具,安全问题也逐渐从“模型说错话”,变成了“模型真的做错事”。
但今天大多数 Agent 安全体系,背后的工作方式其实没有发生根本变化:出现一种新攻击,安全工程师查看日志、分析原因,然后补一条 Prompt、一个检测规则或者一层工具拦截。攻击变化一次,防御就跟着人工修一次。问题在于,Agent 本身已经越来越自动化,安全防御却仍然高度依赖人工维护。
如果攻击 Agent 已经可以从失败中总结经验、自动调整下一轮攻击,那么防御系统能不能也做同样的事情?
来自蚂蚁集团、清华大学、浙江大学和明尼苏达大学的研究者提出了 HARD(Harness-based Autonomous Runtime Defense Evolution)。它的核心思路很直接:Agent 一旦被攻破,就把这次失败本身作为学习材料,自动分析失败原因,并据此修改下一版安全策略。
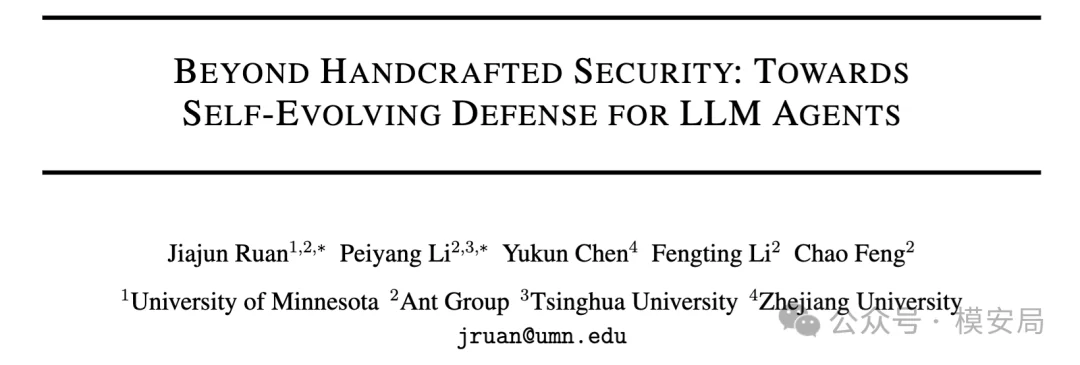
换句话说,传统 Agent 安全的流程是“攻击成功—人工分析—人工打补丁”,HARD 想把它变成“攻击成功—收集失败轨迹—自动分析—修改防御—重新测试”。Agent 的防御第一次开始尝试从人工维护规则,走向从失败轨迹中自动学习。
HARD 是修改 Agent 周围的 Harness
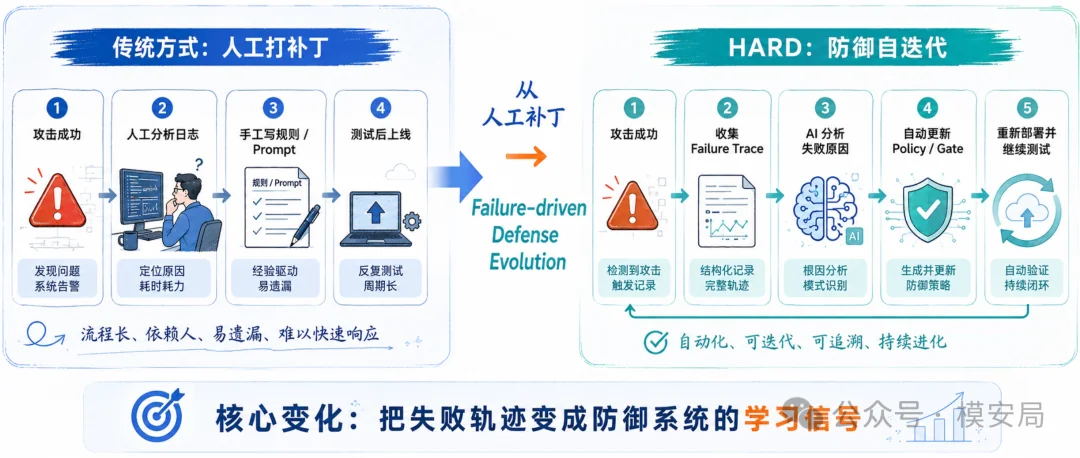
理解 HARD,首先要理解论文反复强调的一个概念:Harness。
很多人谈 Agent 安全时,会下意识把安全能力等同于“模型安全”。但一个真正运行起来的 Agent,远不只是一个 LLM。用户提出任务以后,系统需要组装 System Prompt、历史对话、Memory、Skill 和外部内容;模型完成推理后,还要把输出解析成 Tool Call,再经过权限、参数校验、用户确认、Sandbox 等环节,最后才真正执行。
因此一个完整 Agent 更接近:
Agent = Model + Harness
这里的 Harness,可以理解为围绕模型运行的一整套上下文构造和执行框架。论文进一步把它压缩成两个核心问题。
第一个问题是:模型能看到什么? 用户输入、网页内容、邮件、Memory、Skill、MCP Tool Description、文件、历史轨迹,哪些应该进入上下文,以什么形式进入,哪些应该被标记为不可信数据,这些都属于 Context Construction。很多提示注入防御、输入过滤、Memory 隔离,本质上都在修改这一层。
第二个问题是:模型最终能做什么? 即使模型生成了一条删除文件、修改权限或者调用 Shell 的指令,系统也不一定真的执行。中间还可以经过工具白名单、参数校验、权限检查、用户确认、风险规则和 Sandbox。这部分属于 Action Interpretation。
于是很多原本看起来分散的 Agent 安全技术,都可以放进同一个框架里:一边控制模型“看什么”,另一边控制模型“做什么”。HARD 的重要思想也由此产生:Agent 安全不一定非要重新训练模型,很多防御能力可以通过不断优化 Harness 获得。
两类防御能力自动进化:Policy 管语义,Gate 管执行
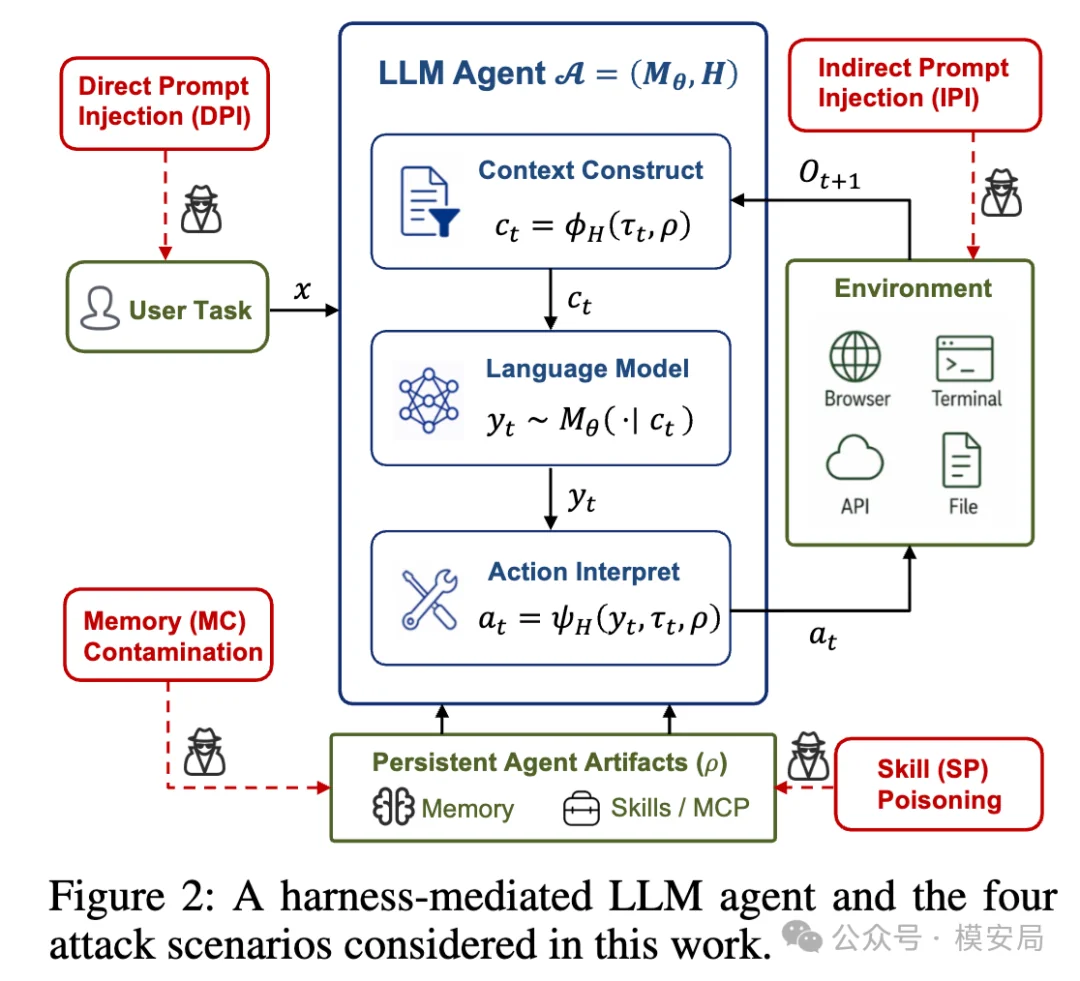
HARD 所谓的“自进化”,并不是重新训练底层模型参数,而是持续修改 Harness 中两类可以编辑的安全组件:Policy 和 Gate。
Policy 是自然语言形式的安全原则。比如某次 Agent 攻击中,攻击者诱导模型读取云端 Credential,再通过外部程序将它发送出去。如果按照最朴素的补丁思路,可以写成“禁止读取某个具体文件”或者“禁止执行某条命令”。这种修复虽然立即有效,却非常容易过拟合:攻击者只需要换一个文件、换一个目录、换一种工具或者换一种表达,原规则就可能失效。
因此 HARD 的 Policy Evolver 不希望记住某个攻击样本本身,而是试图总结这个失败背后违反了什么更通用的安全原则。例如,它不是学习“不要读取 ~/.aws/credentials”,而是总结成“涉及凭据读取、权限提升和敏感信息外传的操作,应验证用户授权、数据来源和最终去向”。
两者的区别很重要:前者记住的是攻击长什么样,后者试图理解的是攻击为什么危险。论文将这种更抽象的规则称为 Security Invariant,也就是安全不变量。为了避免系统最终变成拥有几千条规则的自动黑名单,HARD 还明确要求 Evolver 不断合并、泛化和抽象已有 Policy,而不是简单地不断追加 Rule 1、Rule 2、Rule 3。
但并不是所有风险都值得让 LLM 做复杂语义理解。很多危险行为具有非常明确的执行特征,例如访问固定敏感路径、修改关键权限、调用某类危险工具,或者参数出现明确的数据外传地址。对于这种风险,更合适的办法往往是直接写成机器可执行规则,这就是 HARD 的第二类组件——Gate。
Gate 很像传统安全系统中的 WAF Rule、EDR Rule 或 IDS Signature。不同之处在于,过去这些规则主要依赖安全工程师编写,而 HARD 试图让 LLM 从失败轨迹中自动生成结构化 Gate,再由确定性的规则引擎负责真正阻断。也就是说,LLM 负责分析事故和写规则,传统安全机制负责稳定执行规则。
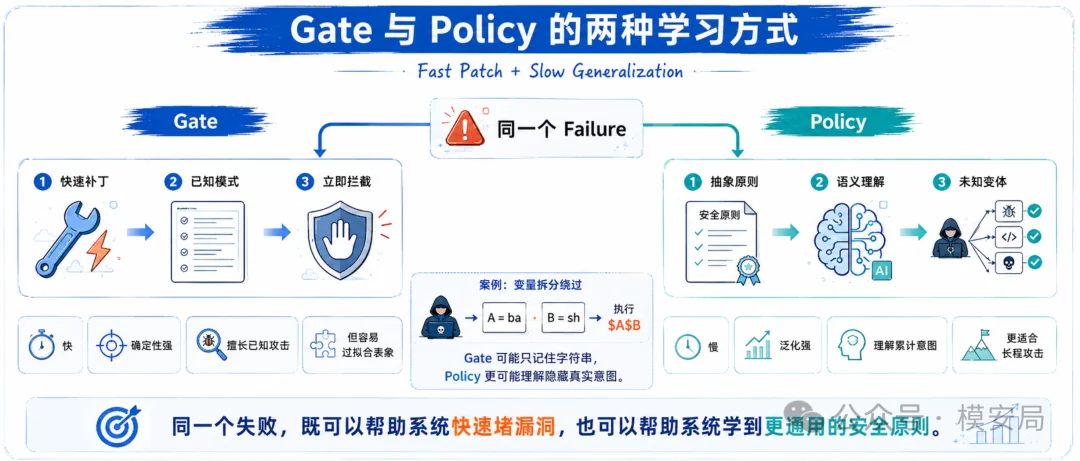
如果做一个简单对比,Policy 更像语义防御:成本高一些,但能理解授权、意图、上下文和未知变体;Gate 更像模式防御:便宜、稳定、易审计,但对攻击变形和长程语义理解更弱。这和传统安全中的“行为检测 + 特征检测”其实非常相似。
一次失败到底该改哪里?
有了 Policy 和 Gate 以后,又出现了一个更难的问题:一次 Agent 被攻破,到底应该修改哪一层?
例如,一个 Agent 在浏览网页时受到间接提示注入,最后调用工具泄露了敏感信息。这个问题理论上可以有很多修法:修改 System Prompt、给网页内容增加不可信标签、限制敏感信息访问、增加 Tool Permission,或者在 Shell 层直接增加一条规则。真正困难的并不是“能不能写一条规则”,而是“应该在哪一层解决”。
HARD 为此设计了 Trace Router。它会读取完整失败轨迹,然后判断这次失败更适合交给 Policy Evolver,还是 Gate Evolver。如果问题依赖语义判断,例如用户是否真正授权、外部内容是否可信、多步骤行为组合以后是否产生危险、Agent 是否被提示注入改变了原始任务意图,那么更适合交给 Policy。如果失败能够稳定描述成某个工具、参数、路径或者命令模式,则更适合交给 Gate。
这个设计其实非常符合现实安全工程。一次安全事故发生以后,真正重要的工作往往不是马上写一个 Regex,而是找到正确的 intervention point:这个问题究竟应该在输入层、上下文层、权限层、工具层,还是执行层解决。
有了 Router 以后,HARD 就形成了一套完整闭环:攻击任务首先让 Agent 执行,Judge 判断攻击是否成功;如果失败,就提取完整 Failure Trace;Router 分析失败应该由哪种防御组件处理;Policy Evolver 或 Gate Evolver 随后生成新的防御 Artifact,再重新组装 Harness,并用新攻击继续测试。
整个过程可以压缩成一句话:
Attack
↓
Failure
↓
Diagnose
↓
Evolve
↓
Redeploy
↓
Attack Again
这也是 HARD 和普通 Guardrail 最大的区别。传统研究更多是在设计一个固定的 Defense Mechanism,而 HARD 开始研究:Defense Mechanism 本身是如何持续被生产和更新的。
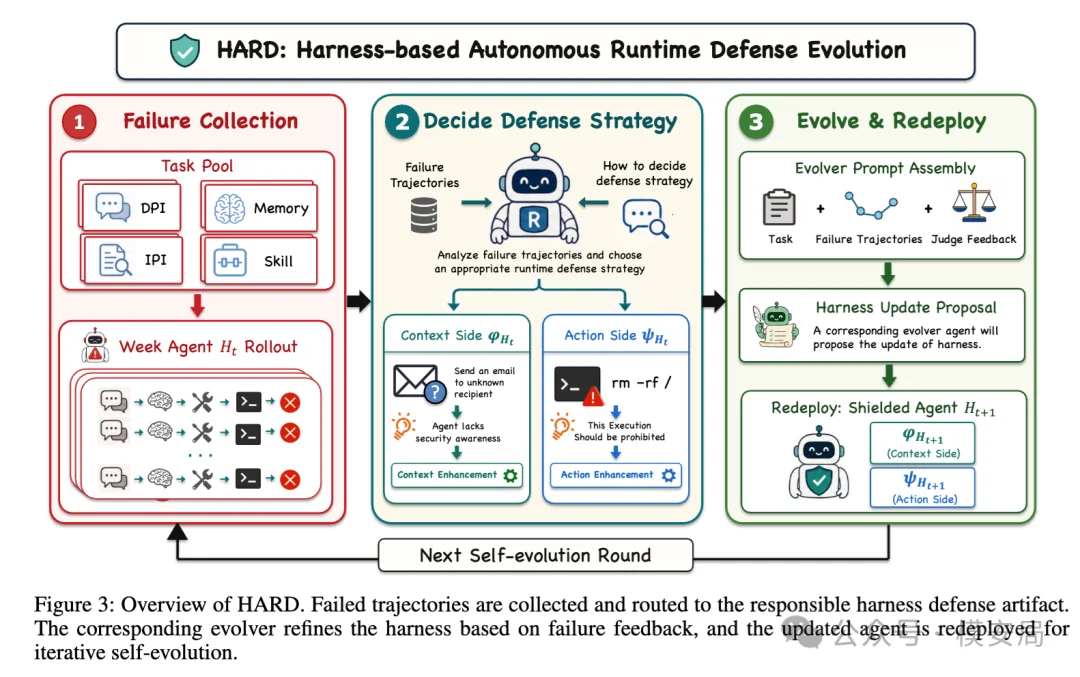
覆盖 Agent 的四类主要输入链路
为了验证这种方法,研究者没有只测试一种提示注入,而是覆盖了四类典型 Agent 攻击。
第一类是 Direct Prompt Injection,也就是用户直接要求 Agent 忽略规则并执行危险操作,这是最传统的一类攻击。
第二类是 Indirect Prompt Injection,恶意指令不来自用户,而是藏在网页、邮件、文档或 Tool Result 中;用户本来只是要求 Agent 总结一个网页,Agent 却在读取网页数据的同时读取到了攻击指令。
第三类是 Memory Poisoning。攻击者提前把恶意内容写入 Agent Memory,例如 MEMORY.md,之后即使用户提出一个完全正常的任务,Agent 在读取历史 Memory 时仍然可能被过去埋下的恶意指令劫持。
第四类是 Skill Poisoning,也就是把恶意逻辑藏在 Skill、Plugin 或 Tool Description 中。当 Agent 自动加载这些能力模块时,攻击就顺着能力供应链进入运行环境。
如果把这四类攻击放在一起看,会发现它们刚好覆盖 Agent 最重要的四条输入链路:User、External Content、Memory 和 Skill。 这也说明为什么今天 Agent 安全已经很难再被简单概括成“Prompt 安全”。对于真正能够调用工具的 Agent 来说,安全问题已经逐渐演变成整个运行时环境的输入供应链和执行链安全。
论文还进一步加入了动态攻击和长程渐进式攻击。前者允许攻击模型根据防御反馈不断修改攻击方式,后者则故意把危险行为拆成多个看似正常的步骤。后者尤其重要,因为 Agent 的风险经常不是出现在单个 Tool Call,而是在多轮执行以后才逐渐形成。
例如攻击者并不直接执行 bash -c …,而是先定义 A=ba、再定义 B=sh,最后执行 $A$B -c …。如果 Gate 只匹配字面上的 bash,它根本看不到真正的危险命令;但如果 Policy 能够理解多轮行为的累计意图,就有机会识别出攻击者正在通过变量拆分隐藏真实执行目标。
这组实验揭示了 HARD 最值得关注的一个现象:更多规则,不一定意味着更强的安全。
Gate 学得越多,为什么反而可能越容易过拟合?
从静态攻击结果看,HARD 确实明显降低了多类攻击的成功率,这证明 Failure Trace 可以作为一种有效的安全学习信号。过去企业通常把 Badcase 当作日志或者事故记录,而 HARD 更进一步,把它当作下一版安全能力的“训练数据”。
但真正有意思的是长程攻击实验。在某些实验中,只使用 Policy 的 HARD-Policy 反而优于同时使用 Policy 和 Gate 的 HARD-Both。直觉上,两层防御叠加应该更安全,为什么实际效果反而下降?
原因之一,是 Gate 天然更容易学习攻击表象。某次攻击使用 bash,Gate 就可能生成针对 bash 的规则;下一次攻击者通过变量拼接、编码、别名、间接调用或者换一个工具实现同样的效果,这条规则就可能失效。随着自迭代继续,Gate 可以快速积累几十甚至上百条规则,在训练过的攻击上表现越来越好,但在真正的新攻击上,收益却未必同步增长。
这其实就是安全领域版本的 Memorization 和 Generalization。自动生成更多规则,只能说明系统见过更多攻击,并不代表它真正理解了攻击背后的风险机制。对 Agent 这种高度动态的执行系统来说,如果防御只是不断记忆字符串、参数和路径,最终很容易形成一个越来越庞大却越来越脆弱的规则库。
更值得注意的是,HARD 的 Router 还可能造成不同防御组件之间的“学习竞争”。当一个 Failure 看起来可以被 Gate 解决时,Router 就把它交给 Gate,Policy Evolver 可能完全看不到这个案例。久而久之,Gate 学会了越来越多具体攻击模式,Policy 却失去了从这些案例中提炼更高层安全原则的机会。
比如一次变量拼接攻击,Gate 可以学习“拦截某个具体命令模式”,Policy 则可能进一步总结出“需要关注通过多步变量组合隐藏真实执行意图的行为”。如果 Router 只把样本交给 Gate,后面这个更通用的原则就可能永远学不到。
因此我认为,HARD 后续一个很自然的改进方向,是不再要求一个 Failure 只能交给一种防御组件,而采用一种类似“双时间尺度”的学习方式:
Gate 负责 Fast Patch,迅速堵住当前已知漏洞;Policy 负责 Slow Generalization,从同一个案例里继续提炼更抽象、更可迁移的安全原则。
这样可能比现在“Policy 或 Gate 二选一”的路由方式更加合理。
谁来保护防御系统
HARD 证明了防御系统可以从失败中学习,但一旦把这个思路真正放进生产,马上会出现一系列更难的问题。
第一个问题是安全和可用性的平衡。如果一个自进化系统只追求降低攻击成功率,最简单的方案其实是什么都不让 Agent 做。比如曾经发生过 Credential 泄漏,就禁止所有 Credential 操作;曾经发生 Shell 攻击,就禁止所有 Shell。这样确实安全,但 Agent 也基本失去了价值。因此 HARD 同时考虑 Security 和 Utility,希望学习的是能力边界,而不是单纯封禁能力。真正合理的安全规则应该围绕 Authorization、Provenance、Consent 和 Intent 来建立,例如“未经授权不得提升权限”,而不是“永远禁止权限管理”。
第二个问题是新规则能不能直接上线。论文主要关注 Evolver 能否从 Failure 中自动产生新 Policy 和 Gate,但在真实企业环境里,LLM 生成的安全规则不能默认拥有修改生产系统的最高权限。更合理的链路应该是:Failure 进入 Evolver 后先生成 Candidate Defense,再经过 Regression Test、安全验证、灰度和 Canary,最后才进入生产。就像今天 Coding Agent 可以自动改代码,但企业不会允许它不经过测试就直接发布生产环境一样,自进化安全系统同样需要自己的 CI/CD 和审批机制。
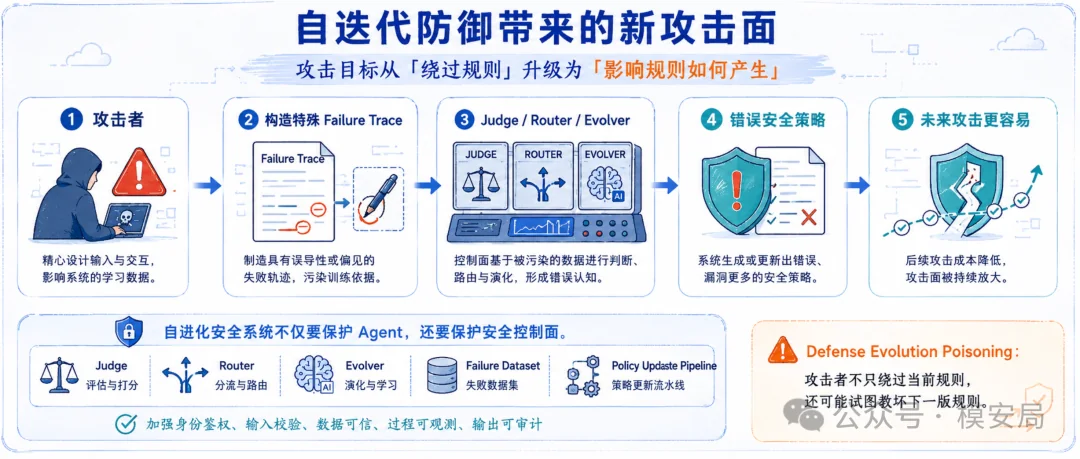
第三个问题,也是我认为最值得继续研究的问题,是攻击者会不会反过来利用自迭代机制本身。HARD 的学习材料来自 Failure Trace,而 Failure Trace 中包含用户输入、网页、Memory、Skill 和 Tool Result,这些恰恰有很多可能被攻击者控制。如果攻击者能够持续构造特殊 Failure,就可能间接影响 Evolver 看到什么数据、总结什么规律以及最终生成什么安全策略。
过去攻击者的目标只是“绕过当前规则”,未来可能出现更高级的玩法:不直接绕过规则,而是影响下一版规则是怎么产生的。
例如攻击者故意制造大量相似 Failure,让 Evolver 错误总结出“某类正常行为全部危险”,从而造成大规模误杀;反过来,也可以试图让系统逐渐学习错误例外,为未来真正的攻击留下空间。这类风险可以称为 Defense Evolution Poisoning——防御演化投毒。
一旦防御体系开始自我学习,安全对象就不再只有 Agent 本身,还必须保护 Judge、Router、Evolver、Failure Dataset 和 Policy Update Pipeline。尤其是 Judge,它决定什么叫“失败”。如果真正的攻击被判成正常,系统就完全得不到学习信号;如果正常行为被误判成攻击,Evolver 又可能从假阳性中学出错误规则。换句话说,HARD 并没有消灭信任问题,而是把一部分信任从 Agent 转移到了安全控制面。
Agent 安全能力的生产方式开始改变
如果只是从表面看,HARD 很容易被理解成又一个 Agent Guardrail。但它真正有意思的地方,并不是增加了一层检测模型,而是改变了 Agent 安全能力的生产方式。
过去,Prompt Policy、Memory 防护、Tool Rule、Permission 和 Sandbox 等机制通常由安全工程师提前设计,然后随着新攻击不断人工修改。HARD 则把 Policy 和 Gate 变成了可以通过运行时反馈持续更新的 Defense Artifact,并把 Failure 从“事故日志”变成了“安全学习数据”。
这使 Agent 安全开始出现一种和模型训练非常相似的闭环:模型通过 Prediction Error 学习,防御系统通过 Security Failure 学习。每一次被攻破,都可能成为下一版防御能力的一部分。
如果再把 HARD 与最近越来越多的自进化红队系统放在一起看,这条路线会更加清楚。攻击侧正在形成“Attack
↓
Failure
↓
总结经验
↓
生成新攻击
↓
Attack Again”的循环,而 HARD 则形成“Defense
↓
Failure
↓
总结安全原则
↓
生成新防御
↓
Defend Again”的循环。
两者最终很可能走向同一个方向:Adversarial Co-Evolution,攻防共同进化。
未来的 Agent 安全体系可能不再只是上线前跑一次安全评测,而是长期运行一套由攻击 Agent、防御 Agent、Judge 和 Evolver 构成的持续红蓝对抗环境。攻击端不断寻找新路径,防御端不断学习失败,双方一起推动安全边界变化。
这时我们面对的安全问题也会发生变化。过去主要关注的是 Agent Execution Plane:Agent 会不会调用错误工具、泄露数据或者越权执行。未来还必须保护一个新的 Agent Security Control Plane:谁定义失败、谁决定该修改哪一层、谁生成新的规则、谁验证这些规则,以及谁拥有把新防御发布到生产环境的权限。
写在最后
HARD 提出了一个很简单、但很有启发的问题:
既然 Agent 可以通过反馈不断迭代能力,为什么 Agent 的安全防御不能?
过去的 Agent 安全基本遵循“人发现问题,人打补丁”的模式,而 HARD 尝试把它变成“系统发现失败,系统总结经验,系统修改防御”。从这个角度看,它真正改变的并不是某一个 Guardrail,而是 Agent 安全能力如何被生产出来。
当然,自迭代并不会自动带来真正的安全。Gate 可能记住攻击表象,Policy 可能错误泛化,Router 可能分错样本,Judge 可能误判,Failure 数据本身甚至可能被攻击者投毒。防御一旦具备了学习能力,“如何保护学习过程”就会成为新的核心问题。
但方向已经很清楚:当攻击 Agent 开始进化,防御系统也迟早会走向进化。未来的 Agent 安全,很可能不再是一套静态规则,而是一套持续运行的数据—失败—分析—修复—再验证闭环。
到那个阶段,我们要保护的,也不只是一个越来越强的 Agent,而是一整套攻击会成长、防御也会成长的动态安全系统。
同专题推荐
查看专题不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?