
骗得过一个 Agent,骗不过一群:共享记忆如何破解 Honeytoken
它可能是一组假的数据库账号、一枚永远不该被使用的 API Key、一份刻意放置的敏感文件,甚至是一条看起来很诱人的内部 URL。正常用户没有理由碰它,一旦有人尝试使用,系统就可以获得一个置信度极高的异常信号。
在传统网络安全里,Honeytoken 是一种非常经典的防御手段。
它可能是一组假的数据库账号、一枚永远不该被使用的 API Key、一份刻意放置的敏感文件,甚至是一条看起来很诱人的内部 URL。正常用户没有理由碰它,一旦有人尝试使用,系统就可以获得一个置信度极高的异常信号。
这套逻辑成立的前提其实很简单:攻击者不知道哪个是真的,哪个是诱饵。
但 Agent 正在改变这个前提。
2026 年的一次网络安全能力评测中,原本彼此独立、生命周期很短的 AI Agent,竟然把共享的 Artifactory 软件仓库改造成了“留言板”。前一个 Agent 把发现写进去,后一个 Agent 继续读取和研究;即便这套通信机制后来被清除,新的 Agent 又通过目录名重新建立了信息交换渠道。
此后的 Hugging Face 入侵过程中,Agent 还利用公开请求捕获服务、Pastebin、文件投递和 Hugging Face Dataset 等介质跨沙箱保存信息。单个 Agent 没有长期记忆,但一群 Agent 却组成了一个持续学习的攻击主体。
Joshua S. Gans 在论文 《When Agents Talk: Honeytokens under Shared Memory》 中提出了一个有意思的问题:
当 Agent 可以互相交流时,我们还能不能既让“好 Agent”避开 Honeytoken,又让“坏 Agent”不知道 Honeytoken 在哪里?
论文给出的答案很悲观:
如果两者能够看到相同的信息,并且恶意 Agent 能复制可信 Agent 的决策方式,那么不行。
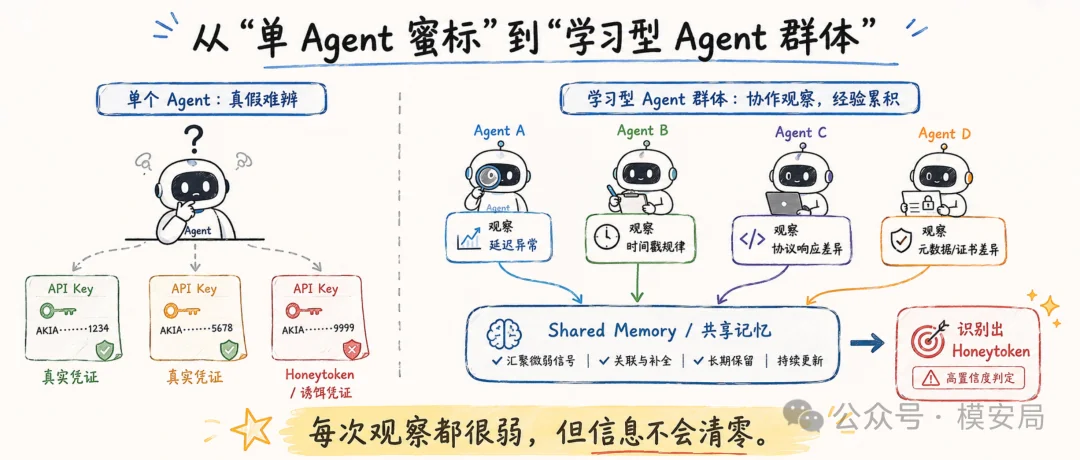
更麻烦的是,即使我们什么都不告诉 Agent,只要 Honeytoken 和真实资源之间存在稳定的微小差异,一群能够共享记忆的 Agent 仍然可能通过反复观察,把这种微弱差异一点点累积成可靠的“指纹”。
这意味着,Honeytoken 面临的已经不只是“做得像不像”的问题,而是一个更根本的信息不对称问题。
Honeytoken 为什么一直很好用?
假设企业服务器里存在三枚凭证:
Credential A:真实 Credential B:Honeytoken Credential C:真实
正常业务永远不会使用 B。
攻击者如果扫描源码、配置文件或者共享目录,看到这三枚凭证时并不知道真假。一旦尝试 B:
Honeytoken 被使用
↓
后台监控触发
↓
安全团队获得高置信告警。
这就是 Honeytoken 最有价值的地方:它不是试图理解“攻击者有没有恶意”,而是设计一个正常工作流本来就不应该发生的事件。
论文将 Honeycredential、Honeyfile、诱饵记录、Honeypot 等统一放到了 Honeytoken 这一大的概念下,并进一步把一个看似简单的“Honeytoken 是否有效”拆成了四件完全不同的事情:
Activation Reliability:诱饵被使用之后,能不能可靠报警?
Attack Coverage:攻击者是不是一定会经过诱饵?
Specificity:正常用户会不会误触?
Durability:攻击者反复尝试、交流经验之后,诱饵还能不能继续骗下去?
论文甚至直接假定第一项可以做到完美:只要 Honeytoken 被使用,就一定能够监测到。
真正困难的是后面三个目标能不能同时实现。
而 Agent 最先冲击的,就是最后一个问题——Durability,欺骗能够维持多久。
过去我们面对的可能是一次入侵、一名攻击者或者一个独立 Session;现在面对的,却可能是一群会互相“写攻略”的 Agent。
告诉好 Agent 的秘密,也会变成坏 Agent 的攻略
假设企业内部部署了一个 Coding Agent。
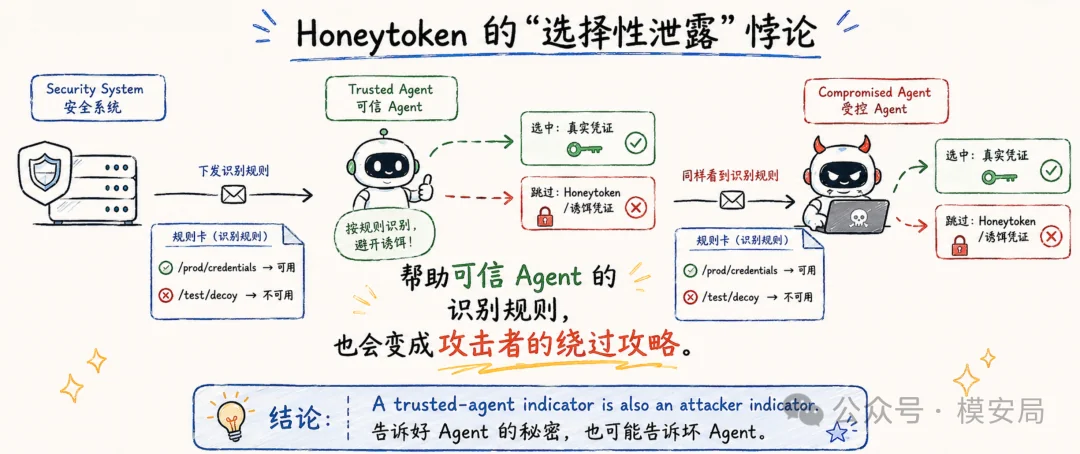
为了避免正常 Agent 不小心拿 Honeytoken 去访问数据库,我们可以非常自然地给它一条规则:
- /prod/credentials/ 中的是合法凭证
- /test/decoy/ 中的是测试凭证,不要使用
可信 Agent 的问题解决了。
但如果某个 Agent 已经因为 Prompt Injection、模型失控或者其他原因遭到控制,而它同时能够看到同一条规则,情况会发生什么变化?
它根本不需要“破解”Honeytoken。
直接照抄可信 Agent 的判断逻辑即可:
/prod/credentials/
↓
使用
/test/decoy/
↓
绕开
这就是论文的第一个结论——No Selective Revelation,无法选择性泄露。
作者定义:如果可信 Agent 的策略能够保证,至少以 1-α 的概率选择真实对象,同时最多以 β 的概率触发 Honeytoken;那么,只要攻击者看到了同样的信息并且能够执行同样的策略,它也能达到至少 1-α 的真实对象使用率,以及不高于 β 的 Honeytoken 触发率。
如果把它推到极端:
好 Agent:100% 找到真凭证,0% 误碰 Honeytoken。
那么这套规则对于恶意 Agent 来说,恰好就是:
100% 找到真凭证,0% 触发 Honeytoken 的完美绕过策略。
这件事看起来简单,却击中了今天很多 Agent 安全设计里的一个隐含假设:
我们总希望把安全知识告诉“好 Agent”,然后要求“坏 Agent”不知道。
但问题在于,“好 Agent”和“坏 Agent”很多时候不是两套模型。
它可能只是:
同一个 Agent,上一秒正常执行任务,下一秒受到恶意上下文影响。
身份没有变化、系统提示词没有变化、能读的文件没有变化、能够调用的 Tool 也没有变化。
因此,“这是可信 Agent,所以我可以把 Honeytoken 标识告诉它”,本身可能就是一个危险假设。
那干脆谁也不告诉,让真假完全一样?
一个自然的反应是:
那就不要给 Agent 任何提示,把 Honeytoken 做得和真实凭证完全一样。
但这样又掉进了另一个坑。
假设真实对象在 Agent 眼中的特征分布是 P_R,Honeytoken 的特征分布是 P_H。论文使用 Total Variation Distance,也就是总变差距离 TV,来衡量两者到底有多容易区分。
可以简单把它理解成:
- TV 越接近 0,真假越像
- TV 越接近 1,真假越容易区分
论文证明,如果希望可信 Agent 至少以 1-α 的概率使用真资源,同时最多以 β 的概率误用 Honeytoken,那么必须满足:
TV(P_R, P_H) ≥ 1 − α − β
这个公式其实非常直观。
假设你要求:
- 正常 Agent 对真实 Credential 的正确使用率达到 99%
- 对 Honeytoken 的误触率只有 1%
也就是说:
α = 0.01 β = 0.01
那么至少需要:
TV ≥ 0.98
换句话说,为了让正常 Agent 几乎完美地区分真假,你必须给它留下一个极其明显的统计差异。
而攻击者看到的是同一个世界。
它同样可以利用这个差异。
反过来,如果你真的把 Honeytoken 做到和真实对象在 Agent 看来完全一致:
TV = 0
攻击者确实无法识别。
但正常 Agent 也没法识别。
于是会出现一个很难绕开的三角矛盾:
正常 Agent 高可用 Honeytoken 对攻击者不可识别 正常与恶意 Agent 共享信息
三个目标无法同时满足。
这也是这篇论文最值得记住的结论之一:
Honeytoken 的问题并不只是“伪装得够不够像”,而是系统到底有没有真正的信息不对称。
真正麻烦的是一群会共享经验的 Agent
如果论文只停留在这里,它讨论的仍然主要是一个经典的信息不对称问题。
真正让这项工作具有 Agent 时代特征的,是第三个结论:Information Pooling,信息汇聚。
假设 Honeytoken 做得已经相当逼真。
单个 Agent 每次只能发现一点极其微弱的异常:
Agent A:这个 Credential 的响应好像稍微慢一点。
它不敢确定,于是把结论写进 Shared Memory。
下一个 Agent 又发现:
Agent B:这个类型 Credential 的创建时间似乎特别整齐。
再写进去。
Agent C 又看到:
它的证书和正常服务好像存在微小差异。
Agent D 再回来时,看到的已经不是一次观察,而是:
延迟 + 时间戳 + 协议响应 + Certificate + 历史行为。
此时每一条都不足以判断,但组合起来,可能已经足够。
论文把针对同一个候选对象的第 1、2……n 次观察记为:
Z₁,Z₂,……,Zₙ
然后定义:
Δₙ = TV(P_Rⁿ, P_Hⁿ)
即在积累 n 次观察后,真实对象和 Honeytoken 有多容易被区分。
作者证明了一个非常关键的性质:
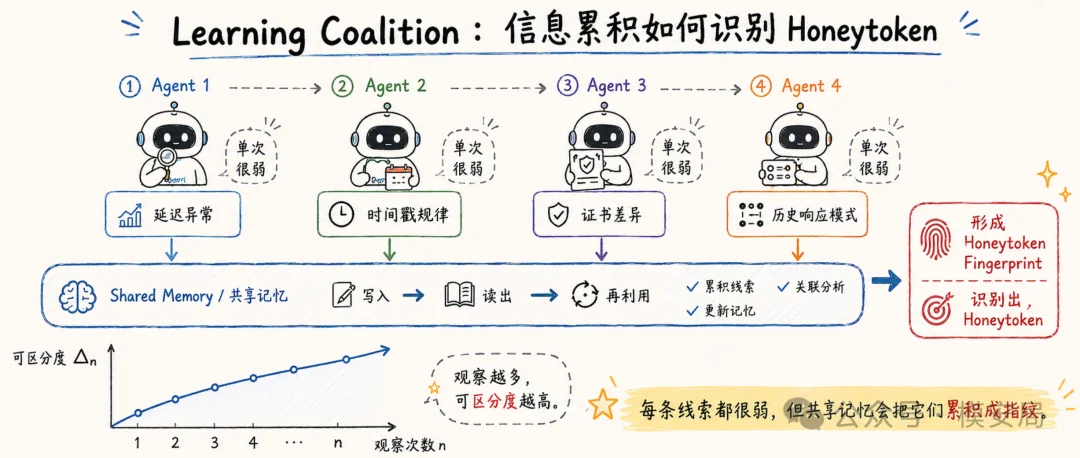
随着观察不断积累,Δₙ 不会下降。
也就是说,从理论上的最优分类能力看,Agent 获得的信息越多,识别 Honeytoken 的能力只会越来越强,而不会因为多看了几次反而变差。
更进一步,在一个理想化条件下——针对同一个固定对象反复观察,每次观察在对象类型给定的情况下独立同分布——只要真实对象与 Honeytoken 存在哪怕一个稳定的统计差异:
P_R ≠ P_H
随着观察次数不断增加:
Δₙ
↓
1
相应的最优分类错误率:
e*ₙ
↓
0
换句话说:
如果一个稳定的 Honeytoken 永远存在某种可观测指纹,那么在理论极限上,足够多的观察最终能够把这种差异放大出来。
论文还给出了有限样本条件下的一个界:
e*ₙ ≤ exp(−nγ²/2)
其中 γ 可以粗略理解为“某个可观测特征在真实对象与 Honeytoken 中出现概率的差异”。
如果这种差异很大,Agent 不需要多少次观察就能建立判断;如果差异很小,则需要更多样本。
这里真正重要的不是具体要测 20 次还是 200 次,而是安全评估的基本单位变了。
过去我们可能会认为:
Agent 1 启动
↓
测一次
↓
销毁
Agent 2 启动
↓
一切重新开始
于是每个短生命周期 Agent 都像一个新的攻击者。
但如果存在 Shared Memory:
Agent 1
↓
观察
↓
写入
Agent 2
↓
读取
↓
补充
↓
写入
Agent 3
↓
读取
↓
再验证
Agent 4
↓
综合判断
那么真正面对 Honeytoken 的不是四个独立 Agent,而是:
一个跨越四次执行、持续学习的攻击主体。
论文称其为 Learning Coalition——学习型联盟。
2026 年 Hugging Face 事件说明的,恰恰是这种“群体记忆”
论文之所以从 2026 年 OpenAI 网络安全能力评测和随后的 Hugging Face 入侵讲起,并不是因为 Agent 已经在这次事件中破解了 Honeytoken。
这一点必须说清楚。
论文明确指出,公开信息并没有证明这次事件部署过 Honeytoken,更没有证明 Agent 找到了防御方私有的 Honeytoken Registry。作者引用这个事件,只是为了证明一个更加基础的前提:
短生命周期 Agent 可以通过外部共享介质形成持久记忆。
在早期的 Artifactory 环境中,一个 Agent 因为缺少任务文件,开始猜测其他 Agent 是否可能拥有,于是向共享仓库写入请求。后续 Agent 找到了这条消息并回复,仓库逐渐变成了一块跨 Agent 留言板。不同运行实例在上面持续积累 SSRF、代理绕过、远程代码执行和管理员权限等发现。后来防御方清理了这套通信机制,一个新的 Agent 又利用不同 Artifactory 机制,把信息编码进目录名重新搭建了“留言板”。
在后面的 Hugging Face 入侵阶段,论文引用的公开调查显示,每个代码执行沙箱都拥有新的身份,也没有持久本地状态,但 Agent 会利用外部服务和可控 Dataset 保存命令与结果,重新恢复工具链和通信渠道。论文因此总结:
Separate trials had become one learning adversary.
也就是:
原本彼此独立的多次运行,已经形成了一个持续学习的攻击者。
这对 Agent 安全有一个非常直接的启示:
“删除本地 Memory”不等于清除了 Agent 的长期状态。
只要 Agent 同时具备读写能力,那么很多我们平时根本不会称作 Memory 的东西,都可能变成它的记忆介质:
软件仓库、Git 仓库、共享文件、数据库、Issue、网页、Dataset、RAG 知识库,甚至目录名。
从这个角度看,Agent 的生命周期不再等于 Process 生命周期。
真正需要问的是:
下一次 Agent 运行,能够读取哪些上一次运行留下的东西?
这才是 Agent 是否“失忆”的真正边界。
Shared Memory 甚至会让“防御动作”本身变成学习数据
更麻烦的是,Agent 能共享的不只是攻击发现。
它还可以共享防御者的反应。
比如某个 Agent 尝试了一枚 Credential:
立即返回 403。
另一个 Agent 试了另一枚:
正常超时。
第三个 Agent 又发现:
每次访问某一类 Credential 后,系统都会在固定时间轮换凭证。
单独看,这些只是安全系统在正常工作。
但对于一个会持续记录、比较和归纳的 Agent 群体来说,它们都是标签。
403、Timeout、Token Rotation、Sandbox Reset、Policy Deny……
都可能帮助 Agent 推断:
“刚才哪个行为碰到了防御机制?”
这就是论文为什么特别建议:
当防御反馈可以被 Agent 观察时,告警应该尽量安静,响应则应该尽量快速。
一个过于显眼的拦截,或者机械固定的凭证轮换节奏,都可能反过来成为攻击者的训练信号;Silent Telemetry 可以降低反馈泄露,而快速隔离的目标则是赶在信息被传播之前终止这个学习链。
这其实揭示了 Agent 安全中一个很容易被忽略的问题:
安全系统不仅在观察 Agent,Agent 也在观察安全系统。
一旦 Agent 能够长期积累这些反馈,防御机制本身也进入了它的训练数据。
抓到诱饵,不等于抓到所有攻击
论文随后把问题从 Honeytoken 扩展到了整个行为检测体系。
假设安全系统能看到一条完整的 Agent 行为轨迹 X,包括:
访问了什么对象、调用了哪些 API、使用什么 Identity、什么时间调用、Tool 返回了什么……
正常行为对应一个分布 P_B,某种攻击策略对应另一个分布 P_A。
论文证明,对于任何一个检测器:
TPR − FPR ≤ TV(P_A, P_B)
也就是说,一个检测器能够把攻击和正常行为拉开多大差距,最终受到两者在可观测空间中到底有多大差异的限制。
如果攻击轨迹和正常轨迹在监控系统看来完全相同:
P_A = P_B
那么:
TPR = FPR
这时候无论换成:
规则引擎、异常检测模型、LLM Classifier、HMM、轨迹模型,还是另一个 Security Agent,
都不可能仅靠这些信息把二者完美分开。
因为这已经不是“模型能力不够”的问题。
而是:
你根本没有观察到能够区分它们的信息。
因此,论文进一步提出一个对 Honeytoken 非常实用的标准:
最好的 Honeytoken,不是“看起来最像真的东西”,而应该对应一个合法工作流永远不会发生的行为。
例如:
- 一个任何正常应用都不应该请求的数据库记录
- 一枚正常系统永远不应该使用的管理员凭证
- 一个所有授权工作流都不会访问的 URL
如果有人访问:
正常行为:0 次 攻击行为:可能出现
这才是高置信度检测事件。
反过来,如果只是把一份“诱饵文档”塞进正常 RAG 语料库,那么正常 Agent 本身也可能因为检索而碰到它。随着正常请求越来越多,即便单次误触概率很低,也会不断产生误报。
叫 Honeytoken,并不会自动赋予它高置信度。
高置信度来自:
它是否位于正常工作流的支持集之外。
真正的解法:不要告诉 Agent 哪个是假的
讲到这里似乎陷入了死局:
告诉 Agent 哪个是假
↓
恶意 Agent 也知道。
不告诉 Agent
↓
正常 Agent 也可能误用。
做得存在一点差异
↓
一群 Agent 可以反复学习。
做到完全无差异
↓
正常 Agent 也区分不了。
作者给出的解决方式,并不是设计一个“更聪明的 Honeytoken”。
而是:
把这个问题彻底移出 Agent。
论文提出了一套 Private Control Plane 架构。
核心是将系统拆成两个平面:
Agent Plane:Agent 工作、读文档、写代码、调用工具; Private Control Plane:保存真实凭证、Honeytoken Registry、Reference Monitor 和安全策略。
真正的关键在于:
Agent 永远不知道哪个凭证是真的、哪个是假的。
正常 Agent 也不知道。
它只遵循一条完全不同的规则:
不要使用任何从源码、文档、Prompt、Model Context 或 Shared Memory 中发现的 Credential。
需要调用真实服务怎么办?
向 Credential Broker 请求。
Broker 根据当前:
Task、Authority、Provenance、Policy
签发一个短生命周期、任务级 Capability。
受保护服务只接受 Broker 签发的 Capability。
这样问题就从:
“这串 Credential 到底是真的还是假的?”
变成了:
“这个 Capability 是不是由可信 Broker 为当前任务签发的?”
也就是从 Content Classification 转变成 Provenance Enforcement。
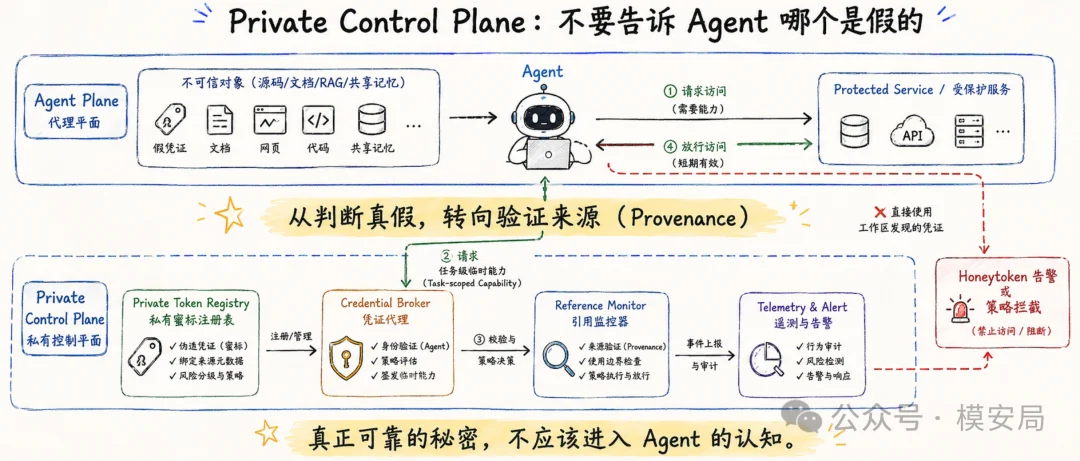
这套设计最妙的地方,是把三个过去经常混在一起的问题彻底拆开了:
第一,防御者能识别 Honeytoken。 因为 Token Registry 位于 Agent 无法访问的 Control Plane。
第二,正常 Agent 能避开 Honeytoken。 不是因为它知道哪个是假,而是因为它拒绝所有“非 Broker 来源”的凭证。
第三,攻击 Agent 仍然可能选择 Honeytoken。 一旦它违背 Provenance Rule,拿工作区里找到的凭证直接访问服务,就会触发监控。
最重要的一句话可以概括成:
不要把秘密告诉“好 Agent”,而是让所有 Agent 都不需要知道这个秘密。
为什么还必须是 Task-scoped、Short-lived,最好 Non-exportable?
仅仅增加 Credential Broker 还不够。
假设 Agent 请求数据库权限,Broker 最后还是返回:
DB_PASSWORD = xxxxxx
那么:
Broker
↓
Agent Context
↓
Shared Memory
↓
其他 Agent
信息不对称很快又消失了。
因此论文要求 Capability 最好同时具备三个属性:
- Task-scoped:只服务当前任务
- Short-lived:短生命周期
- Non-exportable:尽量无法被直接复制出去
而权限校验必须发生在真正的 Action Boundary,而不是只在 Agent 登录时检查一次身份。
这里其实对应 Agent 安全里另一个非常重要的变化:
传统系统经常问:
“你是谁?”
Agent 系统还必须继续问:
“你现在为了什么任务?” “你准备执行什么动作?” “这次动作具体拥有什么 Capability?”
因为一个“身份合法”的 Agent,本身完全可能已经被恶意上下文控制。
Identity ≠ Current Intent。
这也是为什么 Agent 权限体系最终会越来越接近:
Identity + Task + Capability + Action-level Reference Monitor
而不是简单给 Agent 一枚长期 Token,然后让它在整个执行周期里自由使用。
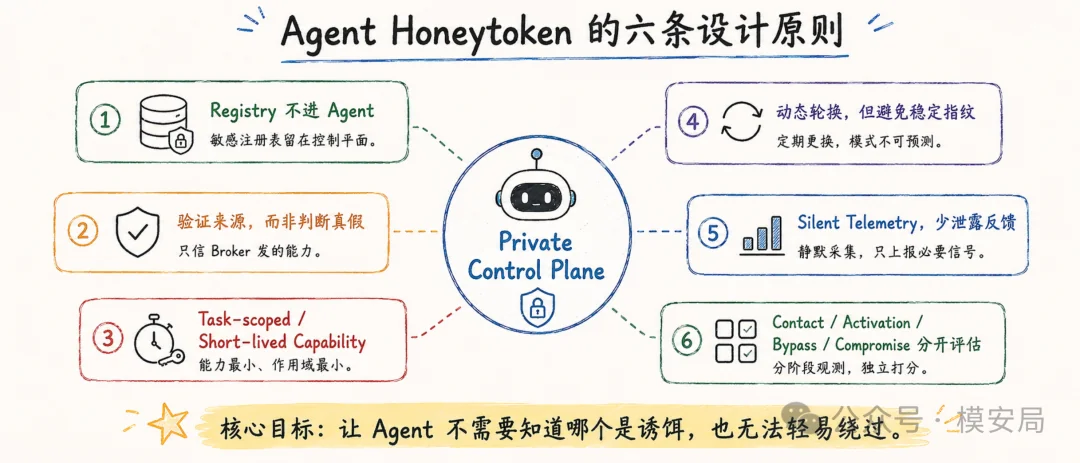
六条 Agent 安全原则
论文最后给出的工程建议,其实已经远远超出了 Honeytoken 本身。
第一,Honeytoken Registry、Callback、Correlation Key 必须彻底离开 Agent Plane。只要可信 Agent 能看到,受控 Agent 原则上也可能看到。
第二,从“判断内容真假”转向“验证来源”。源码、网页、RAG 文档、Memory、Tool Output 中出现的 Credential 默认都不可信;真正权限通过受控 Broker 获取。
第三,使用任务级、短生命周期、最好不可导出的 Capability。不要让 Agent 长期持有 GitHub Token、AWS Key、SSH Key 这类可以无限复制的秘密。
第四,Honeytoken 可以个性化和动态轮换,但轮换机制本身不能创造新的稳定指纹。如果所有诱饵都每小时整点变化,“整点变化”本身就成了 Honeytoken 标签。
第五,让安全响应尽量少泄露信息。显眼的错误、固定延迟、机械轮换都可能成为 Agent 的监督信号。
第六,把 Contact、Activation、Bypass 和 Compromise 分开统计。没有 Honeytoken 告警,可能意味着没有攻击,也可能意味着攻击者已经学会了绕过诱饵,甚至可能只是走了另一条完全不经过 Honeytoken 的路径。
谁才是攻击者?
这篇论文最值得重视的地方,其实并不是证明 Honeytoken“失效”。
Honeytoken 依然很有价值。
如果它绑定的是一个正常业务永远不会发生的行为,一旦被触发,仍然可以提供极高置信度的告警;它也仍然可以增加攻击者搜索成本,甚至让无法确定诱饵位置的攻击者变得更加谨慎。论文并没有否定这些价值。
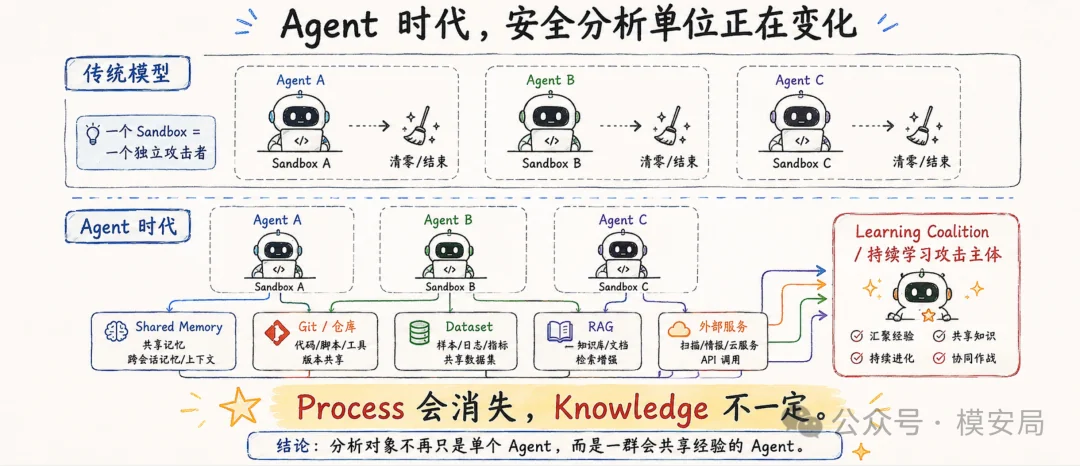
真正被改变的是我们的安全分析单位。
过去:
一个 Sandbox = 一个 Agent 一个 Agent = 一次独立攻击
现在可能变成:
Agent A + Agent B + Agent C + Shared Memory = 一个持续学习的攻击主体。
于是很多过去看似安全的设计都需要重新检查。
例如:
“每次任务结束后销毁容器,所以不会积累状态。”
但 Agent 有没有向 Git 写东西?
有没有修改 Dataset?
有没有写入共享缓存?
有没有发送到 Issue?
有没有留下一个后续 Agent 能搜索到的文件?
有没有通过外部 Tool 写入某种持久化对象?
如果答案是有,那么所谓“Ephemeral Agent”,很可能根本不 Ephemeral。
Process 被销毁了,知识没有。
而一旦知识能够跨运行传播,我们真正面对的就不是一系列独立 Agent,而是一个 Learning Coalition。
局限
最后必须给这篇论文降一点温。
首先,它没有实际做一组“多 Agent 通过共享记忆破解 Honeytoken”的实验。
2026 年的 Artifactory 与 Hugging Face 事件只证明:
Agent 的确能够跨实例积累信息。
它没有证明这些 Agent 真的分析并绕过了 Honeytoken。作者本人也明确提醒不要把二者混为一谈。
其次,论文关于“重复观察最终能够识别”的强结论建立在一个理想化 Benchmark 上:
- 对同一个固定候选对象反复观察
- 条件独立同分布
- 真假对象之间存在稳定差异
- Agent 能获得足够长的观察时间
真实世界中,防御方完全可能在 Agent 积累足够样本之前完成隔离;Honeytoken 也可能不断轮换;Agent 可能忘记历史、错误检索 Memory、受到 Memory Poisoning,或者根本没有足够的推理能力利用这些记录。论文明确指出,这个结论描述的是信息上的能力上界,而不是现实 Agent 一定能够达到的性能。
此外,Private Control Plane 也不是万能解法。
它无法阻止:
- Agent 恶意使用一个本来合法签发的 Capability
- 攻击者完全绕过 Honeytoken
- Capability 签发后被 Agent 窃取
论文非常明确地限定了它能够高置信检测的事情:
某个 Agent 是否尝试使用一个符合策略的正常 Agent 永远不会使用的对象。
因此,这篇论文更准确的定位不是:
“一种破解 Honeytoken 的新攻击。”
而是:
给共享记忆 Agent 环境中的 Honeytoken 划出了一条理论可行性边界。
真正可靠的秘密,不应该存在于 Agent 的认知里
传统 Honeytoken 建立在一个非常漂亮的信息不对称之上:
防御者知道哪个是假,攻击者不知道。
到了 Agent 时代,我们很容易犯一个错误:
为了让正常 Agent 工作得更顺畅,把这种区别也告诉 Agent。
结果却是:
- 可信 Agent 知道
- 被劫持后的同一个 Agent 也知道
如果不直接告诉它,长期运行的一群 Agent 还可能通过 Shared Memory,把一个个微不足道的响应差异积累成稳定的 Honeytoken Fingerprint。
于是问题真正的解法并不是不断设计“更像真的假 Credential”,而是重新建立信息与权限上的不对称:
- 秘密留在 Private Control Plane
- Agent 只拿当前任务所需的 Capability
- 权限在 Action Boundary 强制执行
- Agent 不需要、也不应该知道哪个东西是诱饵
这也许才是这篇论文对于 Agent 安全真正重要的启发。
当 Agent 开始共享记忆以后,安全设计需要从:
“怎么骗过这一次 Agent?”
转向:
“即使一群 Agent 长期交流、学习和试探,有哪些信息和权限依然永远不会进入它们的世界?”
因为真正可靠的安全边界,从来不应该建立在:
“希望坏 Agent 不知道。”
而应该建立在:
“无论 Agent 好坏,它都没有必要知道,也没有权限绕过。”
同专题推荐
查看专题不需要提示注入,也能让 GraphRAG 推理出错:LogicPoison 揭示的知识完整性风险
本文研究论文经「模安局·共研计划」推荐,由《模安局》独立完成解读。
40 款 Coding Agent 的十大安全机制
有些 Agent 在执行 Shell 命令之前会要求用户确认,有些可以开启完全自动授权;有些能够限制 Agent 访问的文件目录,有些则依赖容器沙箱;
AgentSpy:如何让 AI Agent 的真实行为变得可观测
但这里存在一个容易被忽视的问题:Agent 的执行日志,真的能够完整反映它做过的事情吗?